
LLM Stats
LLM Stats · Business · Sonstiges
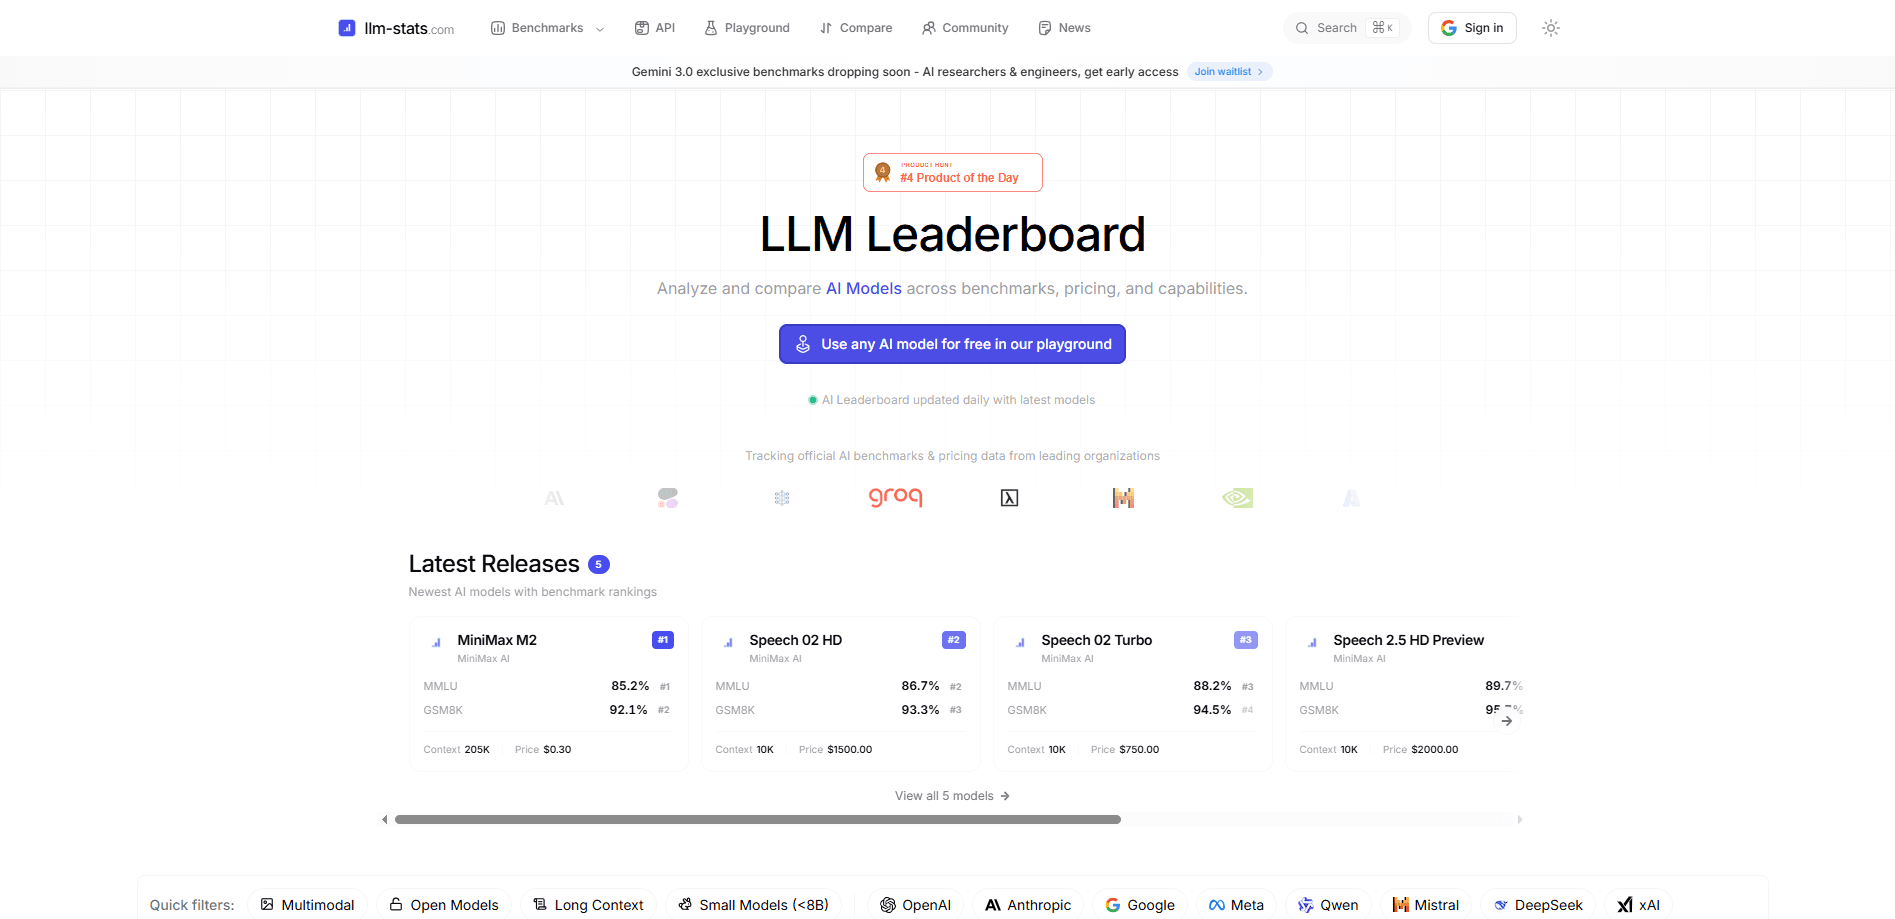
LLM Stats ist eine kostenlose Plattform zum Vergleich von KI-Modellen, die über 300 Sprachmodelle nach Benchmark-Werten, Geschwindigkeit und Preis auf einem einzigen Dashboard ordnet. Sie bündelt öffentliche Benchmarks und Live-API-Metriken in einer einzigen LLM-Rangliste, sodass Sie GPT, Claude, Gemini und DeepSeek direkt nebeneinander vergleichen können, ohne zwischen einem Dutzend Anbieterseiten zu springen.
Über LLM Stats
Was ist LLM Stats
LLM Stats ist eine Anlaufstelle für alle, die den Markt der KI-Modelle verstehen wollen. Statt die Marketingseite jedes Labors zu lesen, bekommen Sie einen Ort, der die Werte für Schlussfolgern, Programmieren, Mathematik und langen Kontext über die gängigen Modelle hinweg gegenüberstellt. Die Seite aktualisiert sich laufend und verfolgt sowohl geschlossene als auch offene Gewichte.
Der Kernwert ist der Vergleich. Warum ist das wichtig? Weil kein Labor ehrliche, direkt vergleichbare Zahlen für seine Konkurrenzmodelle veröffentlicht. Die Plattform schickt jedes Modell durch einen zusammengesetzten LLM-Stats-Score, eine vorsichtige, unsicherheitsbewusste Zahl, die die Benchmark-Beweise in eine einzige Rangfolge mischt. Laut LLM Stats bleiben fehlende Ergebnisse fehlend, statt als Fehlschläge zu zählen. So wirkt ein halb getestetes Modell nicht schlechter, als es tatsächlich abschneidet. Ein kleines Detail. Ein großer Unterschied, wenn Sie ein Modell für ein echtes Projekt auswählen.
Die Einschränkung ist der Umfang. Die Ranglisten spiegeln die öffentlichen Belege wider, die heute vorliegen. Ein Modell mit dünner Benchmark-Abdeckung kann niedriger stehen, als es verdient. Die Plattform sagt offen, dass ihr Score keine aufgabenspezifische Empfehlung für den Einsatz ist. Behandeln Sie ihn als Abkürzung in der Recherche, nicht als endgültige Antwort.
Erste Schritte
- Öffnen Sie llm-stats.com und sehen Sie sich die KI-Hauptrangliste an, die die gereihten Modelle mit Scores, Geschwindigkeit und Preis pro Million Token auflistet.
- Grenzen Sie die Liste mit den Ranglisten für eine bestimmte Aufgabe ein, etwa die beste KI zum Programmieren, Schreiben, für Mathematik oder langen Kontext.
- Filtern Sie nach Lizenz, Geschwindigkeit oder Preis, passend zu Ihrem Budget und Ihren Latenzanforderungen.
- Öffnen Sie eine Modellseite, um die Benchmark-Aufschlüsselung, das Kontextfenster und die Anbieterpreise zu sehen.
- Wenn Sie Software entwickeln, verbinden Sie sich über die Daten-API oder die MCP-Integration, um dieselben Zahlen in Ihre eigene Anwendung zu holen.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von LLM Stats.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Entwickler, die ein Modell für ein Projekt auswählen
- Produktmanager und Gründer, die den Markt einschätzen
- Forschende und Studierende
Aufgaben
- Preise von KI-Modellen vergleichen
- Ein Programmier- oder Schreibmodell auswählen
- Neue Veröffentlichungen verfolgen
Szenarien
- Entscheiden, für welches Modell Sie dieses Quartal zahlen
- Ein Modell mit offenen Gewichten gegen ein geschlossenes abwägen
- Live-Modelldaten in ein internes Tool einbinden
Wichtigste Funktionen
Zusammengesetzter LLM-Stats-Score
Jedes Modell erhält einen einzigen Score, der die Benchmark-Ergebnisse zu einer vergleichbaren Zahl zusammenführt. Der Score ist vorsichtig angelegt: Modelle mit weniger Belegen behalten mehr Unsicherheit, statt bestraft zu werden. Die Rangfolge belohnt breite, gut getestete Leistung statt eines glücklichen Siegs in einem einzelnen Benchmark.
Live-LLM-Rangliste
Die Haupt-Rangliste ordnet über 300 Modelle und aktualisiert sich laufend aus öffentlichen Benchmarks und API-Metriken. Die Spalten decken Schlussfolgern, Programmieren, Agent, Kontextfenster, Ausgabegeschwindigkeit und Preise ab. Sie erfassen alles auf einen Blick. Sortieren Sie nach dem, was für Sie zählt.
Kategorie-Ranglisten
Über die Gesamtwertung hinaus führt die Seite gezielte Listen für Programmieren, Schreiben, Recherche, Mathematik, langen Kontext, Tool-Aufrufe, Schlussfolgern, Bildgenerierung und Videoproduktion. Jede Liste wendet dieselben Bewertungsregeln auf einen engeren Benchmark-Satz an, was hilft, wenn Ihr Bedarf nichts mit allgemeiner Intelligenz zu tun hat.
Preisvergleich für KI-Modelle
Eine eigene Preisseite listet die Kosten für Eingabe, zwischengespeicherte Eingabe und Ausgabe pro Million Token für Hunderte von Modellen, dazu eine beobachtete Kosten-pro-Austausch-Zahl aus echtem Verkehr. Sie vermerkt, wann jeder Preis zuletzt geprüft wurde, und aktualisiert sich alle 30 Minuten, damit die Zahlen nicht veralten.
Offene LLM-Rangliste
Modelle mit offenen Gewichten haben ihre eigene Rangliste, getrennt von den geschlossenen Labors. Diese Trennung zählt, wenn Sie selbst hosten oder feinabstimmen wollen. Offene und geschlossene Modelle messen sich selten zu gleichen Bedingungen.
Offene Arena und Spielwiese
Die Plattform betreibt Arenen für Chat, Programmieren, Bild und Video, in denen Sie Modelle mit echten Prompts gegeneinander antreten lassen. Eine Spielwiese lässt Sie Modelle direkt ausprobieren. Eine nützliche Kontrolle, bevor Sie einer beliebigen Ranglistenzahl vertrauen.
Daten-API und MCP-Server
Für Entwickler stellen eine Daten-API und ein MCP-Server dieselben Ranglisten- und Preisdaten programmatisch bereit. Die Plattform bietet außerdem maßgeschneiderte Benchmarking- und Datenetikettierungsdienste für Teams, die eine Bewertung jenseits öffentlicher Benchmarks brauchen.
Vor- und Nachteile
Vorteile
- Kostenlos zu durchsuchen, ohne Paywall zwischen Ihnen und den Ranglisten oder Preistabellen.
- Bündelt Hunderte von Modellen in einer Ansicht zum Vergleich von KI-Modellen. Schluss mit dem Springen zwischen Dutzenden von Anbieterseiten.
- Die Preisseite zeigt, wann die Daten geprüft wurden, und aktualisiert sich alle 30 Minuten, sodass die Kostenzahlen aktuell bleiben.
- Getrennte Ranglisten für offene und geschlossene Modelle halten den Vergleich fair für alle, die selbst hosten.
- Die Daten-API und der MCP-Server machen es leicht, die Daten in Ihren eigenen Tools weiterzuverwenden.
Nachteile
- Der Score hängt von öffentlichen Benchmarks ab, sodass ein neues oder wenig getestetes Modell niedriger stehen kann, als seine tatsächliche Fähigkeit vermuten lässt.
- Die tiefe Benchmark-Abdeckung neigt zu populären Modellen, was Nischen- oder regionale Modelle mit dünneren Daten zurücklässt.
- Maßgeschneidertes Benchmarking und Datenetikettierung sind kostenpflichtige Dienste, und die Preise werden nicht auf der Seite veröffentlicht, sodass Sie das Team für ein Angebot kontaktieren müssen.
- Die Ranglisten ändern sich oft, wenn neue Modelle erscheinen, was einen gespeicherten Screenshot in wenigen Wochen veralten lässt.
Häufige Fragen
Ja. Die öffentlichen Ranglisten, Modellseiten und der Preisvergleich kosten nichts beim Durchsuchen. Das Unternehmen verkauft jedoch maßgeschneiderte Benchmarking- und Datenetikettierungsdienste für Firmen. Die Kerndaten bleiben trotzdem offen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu LLM Stats.
Alternativen zu LLM Stats

Knocket
Knocket (Tencent RTC team) · Produktivität · Business · ChatbotKnocket ist ein kostenloses Werkzeug für Live-Chat und Kontaktseite: Besucher schreiben über Ihre Website, Ihre App oder einen Link, und Sie antworten aus Telegram oder einem einzigen Posteingang.

shippedit.me
Krawlup · Marketing · Businessshippedit.me leitet inzwischen auf Krawlup um, eine Web-Plattform, die SEO, AEO und Ladezeit wöchentlich prüft und die Korrekturen per MCP an Coding-Agenten übergibt.

Ayven
Alknoma · Produktivität · BusinessAyven ist ein KI-Kontrollzentrum von Alknoma: Es macht aus einem einfach formulierten Ziel einen datierten Plan, verteilt die Aufgaben an Ihr Team und seine KI-Agenten und fragt nur dann nach Freigabe, wenn die Entscheidung bei Ihnen liegt.