
Middleware Observability Platform
Middleware · Coding
Middleware ist eine Cloud-Observability-Plattform, die Logs, Metriken, Traces und echte Nutzersitzungen auf einer Zeitachse zusammenführt und mit einem KI-Agenten die Ursache einer Störung findet und einen Fix vorschlägt.
Über Middleware Observability Platform
About
Was ist Middleware
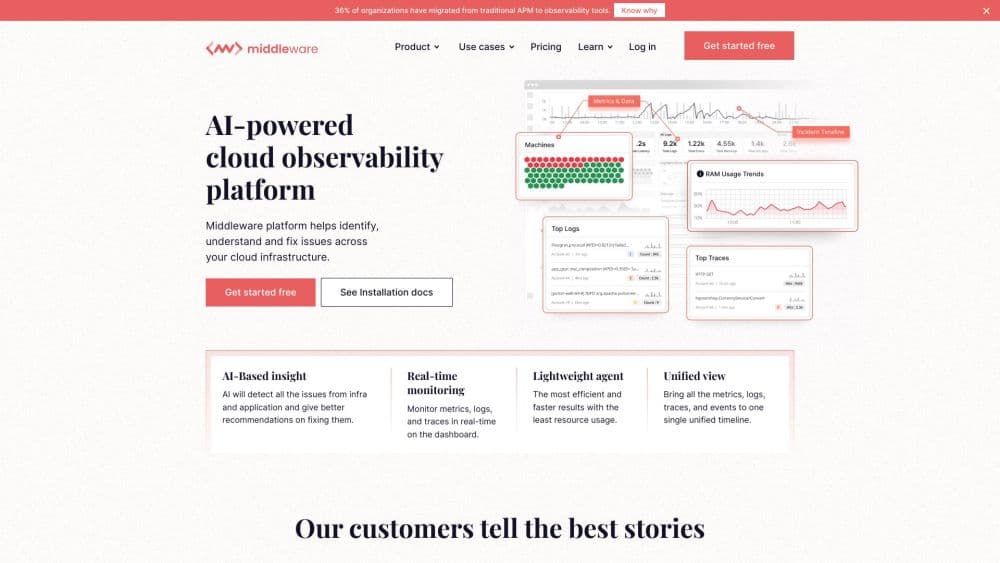
Middleware Observability Platform ist ein Monitoring-Dienst für Teams, die Anwendungen auf Kubernetes, virtuellen Maschinen und Managed Databases betreiben. Statt Metriken, Logs und Anwendungsmonitoring bei drei Anbietern einzeln zu kaufen, installieren Sie einen Agenten und sehen alles auf einem Bildschirm. Diese gemeinsame Zeitachse zählt, wenn etwas ausfällt: ein langsamer API-Aufruf, eine Fehlerzeile im Log und die Aufzeichnung einer Sitzung stehen nebeneinander, verbunden über denselben Request-Kontext.
Hinter dem Produkt steht Middleware, 2022 von Ingenieuren gegründet, die bei Netflix, DigitalOcean, Google und Cisco gearbeitet haben. Die Daten kommen über Agenten auf den Servern, SDKs je Programmiersprache und Integrationen mit Drittanbietern herein, und die Plattform spricht OpenTelemetry. Vorhandene Collector und Agenten anderer Anbieter speisen sie also, ohne dass Sie komplett migrieren. Abgerechnet wird nach Verbrauch, und das Verkaufsargument ist der Gesamtaufwand, nicht ein riesiger Funktionskatalog für die Einkaufsabteilung.
Die Grenzen sollten Sie von Anfang an kennen. Es handelt sich um einen gehosteten Dienst, die Daten verlassen also Ihr Netz, sofern Sie nicht die Option für die eigene Cloud buchen. Tiefe Compliance-Prozesse und lange Aufbewahrungsfristen hängen am individuellen Vertrag. Der KI-Agent ist jünger als das Kernmonitoring, und Teams mit strengem Change-Management schauen sich die automatische Pull-Request-Funktion besser an, bevor sie sie einschalten.
Erste Schritte
- Legen Sie ein Konto auf app.middleware.io an und melden Sie sich per Google, GitHub, E-Mail, Okta SSO oder Microsoft Entra ID an.
- Öffnen Sie die Installationsseite und kopieren Sie MW_API_KEY und MW_TARGET für Ihr Projekt.
- Wählen Sie Ihre Umgebung: ein Kubernetes-DaemonSet, einen Agenten für Linux, ein SDK für Java, Python, Node.js oder eine andere Laufzeit, oder eine Integration mit AWS, Azure, Prometheus oder Datadog.
- Installieren Sie den Agenten und prüfen Sie, ob die Daten nach wenigen Minuten im Dashboard ankommen.
- Bauen Sie Ansichten und Alarme für die Signale, die Ihr Team braucht, und aktivieren Sie danach die Erkennung von OpsAI für Anomalien ohne eigene Regel.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Middleware Observability Platform.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- DevOps- und SRE-Teams
- Startups mit knappem Budget
- Backend-Entwickler, die an LLM-Funktionen arbeiten
Aufgaben
- Die Ursache eines langsamen Endpunkts finden
- Kubernetes-Cluster gesund halten
- Datenbankabfragen im Blick behalten
- Prüfen, ob eine API von außen erreichbar ist
Szenarien
- Ein Produktionsvorfall um zwei Uhr nachts
- Der Traffic-Peak in der Launch-Woche
- Die monatliche Kostenprüfung
Wichtigste Funktionen
OpsAI-Agent für Erkennung und Behebung
OpsAI beobachtet Anwendungen, Infrastruktur, Datenbanken, Container, Logs und LLM-Projekte gleichzeitig und verknüpft die Funde über diese Signale hinweg. Der Mehrwert beginnt nach dem Alarm: Der Agent benennt eine wahrscheinliche Ursache, schlägt einen Fix vor und kann eine Pull-Request mit der Änderung öffnen. Die Fehlererkennung kostet nichts, die Ursachenanalyse wird pro Token abgerechnet, Sie können die Alarme also eingeschaltet lassen, auch wenn Sie die KI nicht bei jeder Störung dabeihaben wollen.
Anwendungsmonitoring
Das APM-Modul schreibt Spans in Echtzeit mit und verfolgt einen Request vom API-Endpunkt bis in die berührten Datenbanken. Kontinuierliches Profiling zeigt, welche Funktion CPU verbrennt, und beantwortet damit eine andere Frage als ein langsamer Trace: Der Trace sagt, wo die Zeit hin ist, das Profil sagt, welcher Code sie verbraucht hat. Traffic-Maps und Abhängigkeitsansichten helfen, wenn Sie einen Ausfall jemandem außerhalb der Technik erklären müssen.
Log-Management mit QueryGenie
Logs kommen aus jeder JSON-Quelle herein, Sie müssen die Ausgabe vor dem Versand also nicht umformatieren. Die Suche läuft über Attribute, unscharfen Abgleich oder reguläre Ausdrücke, und während eines Deployments lässt sich die Live-Ansicht pausieren und fortsetzen. QueryGenie übersetzt eine Anfrage in normaler Sprache in eine Abfrage, was allen hilft, die nicht täglich strukturierte Queries schreiben. Maskierung sensibler Daten und eigene Attribut-Extraktion passieren vor dem Speichern, ein Punkt, der bei Logs mit Kundendaten zählt.
Infrastruktur- und Kubernetes-Monitoring
Infrastrukturmonitoring und Kubernetes-Monitoring teilen sich denselben Agenten. Automatische Instrumentierung deckt Hosts, Kubernetes-Cluster, Linux-Knoten und Cloud-Dienste ab, ohne Skript pro Maschine. Cluster-Zustand, CRDs und Netzwerkrichtlinien stehen in einer Ansicht, dazu ECS-Details für containerisierte Workloads. Einen CPU-Spike mit der verursachten Latenz zu verbinden, ist der Ablauf, für den das Produkt gebaut wurde, und genau dieser Teil fällt Teams zuerst auf.
Real-User-Monitoring und Sitzungswiedergabe
Das Real-User-Monitoring erfasst, was Besucher in Web- und Mobile-Apps tatsächlich erleben, und verbindet ein langsames Laden mit dem Backend-Trace, das es verursacht hat. In der Sitzungswiedergabe schauen Sie sich die Sitzung neben den Netzwerkdaten an, statt Nutzer bitten zu müssen, ihr Erlebnis zu beschreiben. Datenschutzkontrollen anonymisieren Felder und begrenzen die Aufzeichnung, das macht die Funktion in Produkten mit personenbezogenen Daten nutzbar.
Synthetische Checks und Browsertests
Synthetische Tests und Browsertests sitzen im selben Modul. Synthetische Checks senden HTTP-, UDP-, DNS- und WebSocket-Anfragen von mehreren Standorten nach Zeitplan, mit vollständigem Request und Response. Browsertests spielen einen Nutzerweg durch, etwa einloggen und bezahlen, und laufen auf mehreren Browsern und Geräteprofilen. Zusammen decken sie die Lücke ab, die serverseitiges Monitoring nicht sieht: ob der Dienst von außen erreichbar und bedienbar ist.
Datenbank- und LLM-Observability
Das Datenbankmonitoring geht bis auf die Ebene einzelner Queries bei MySQL, PostgreSQL, MongoDB, Cassandra und Aurora und verfolgt CPU, Speicher, Disk und Durchsatz neben den Abfragen. Das LLM-Modul misst Latenz, Tokenverbrauch, Kosten, Antwortqualität und Fehler bei Prompts, Agenten und mehrstufigen Abläufen und verbindet einen teuren oder fehlschlagenden KI-Aufruf mit dem Trace und der Sitzung, die ihn ausgelöst haben.
Vor- und Nachteile
Vorteile
- Ein Agent und ein Bildschirm für Logs, Metriken, Traces, Infrastruktur, Real-User-Monitoring, synthetische Checks und LLM-Daten, damit entfällt das Werkzeugwechseln mitten in einer Störung.
- Die Sammlung über OpenTelemetry lässt vorhandene Collector, Datadog-Agenten und Prometheus-Konfigurationen andocken, ohne dass Sie Bestehendes abreißen.
- Der Preis nach Verbrauch startet mit einer kostenlosen Stufe von 100 GB Daten und unbegrenzten Nutzern, die Rechnung wächst also mit der Telemetrie und nicht mit der Belegschaft.
- Die Datenpipeline wirft laute Log-Quellen vor dem Speichern raus, Rechnung und Suchergebnisse bleiben dadurch im Griff.
- Die Fehlererkennung von OpsAI ist kostenlos, und vorgeschlagene Codeänderungen laufen über eine Pull-Request, der Reviewer behält also das letzte Wort.
Nachteile
- Es ist eine gehostete Plattform, die Daten verlassen also Ihr Netz, sofern Sie die Option für die eigene Cloud per individuellem Vertrag buchen.
- Die kostenlose Stufe hält Daten 14 Tage, der Pay-as-you-go-Plan standardmäßig 30 Tage. Für Teams, die nach einem Audit ein Jahr zurückblicken müssen, ist das kurz.
- Automatische Behebung und Codevorschläge bergen in regulierten Umgebungen echtes Risiko, viele Teams lassen sie anfangs ausgeschaltet.
- LLM-Observability ist jünger als APM und Logs, daher sind weniger tiefe Integrationen zu erwarten als bei den ältesten Wettbewerbern.
Häufige Fragen
Middleware überwacht Infrastruktur, Container, Kubernetes, Anwendungstraces, Logs, Datenbanken, Sitzungen echter Nutzer, synthetische Checks und LLM-Anwendungen. Alles landet auf einer Zeitachse, verknüpft über den Request-Kontext, Sie kommen also von der Nutzerbeschwerde bis zur Query, die den Fehler ausgelöst hat.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Middleware Observability Platform.
Alternativen zu Middleware Observability Platform

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

GitGlow
GitGlow · Coding · ProduktivitätGitGlow ist ein Git-Client für den Desktop, der Ihren Code und die Änderungen Ihrer KI-Agenten in einer Review bündelt, damit Sie vor dem Ausliefern sehen, was die Maschine verlässt.