
MyScale
MOQI SINGAPORE PTE. LTD. · Coding
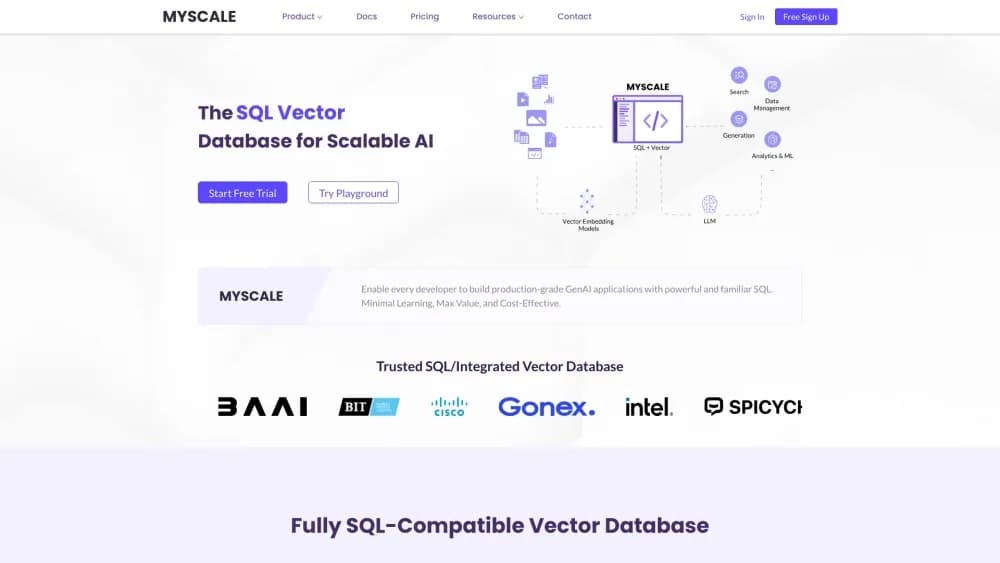
MyScale ist eine SQL-Vektordatenbank auf Basis von ClickHouse. Sie vereint Vektorsuche, Volltextsuche und Analyse in einer Engine, die Sie mit SQL abfragen, ideal für RAG und KI-Apps.
Über MyScale
What Is MyScale
MyScale ist eine Cloud-Datenbank für KI-Anwendungen und läuft auf der Open-Source-Engine ClickHouse. Die Idee ist einfach: Sie bewahren strukturierte Daten, Vektoren und Text in einem System auf und fragen alles mit dem SQL ab, das Sie schon kennen. Die Engine namens MSTG ist auf Vektorsuche in Milliardenhöhe ausgelegt, und das Unternehmen behauptet, sie schlage spezialisierte Vektordatenbanken um das 4- bis 10-Fache bei Tempo und Kosten. Diese Zahl stammt aus dem eigenen Benchmark, also prüfen Sie sie mit Ihren Vektoren, bevor Sie darauf bauen.
Das Problem, das sie löst, ist die Zersplitterung der Werkzeuge. Ein typischer RAG-Stack hängt einen Vektorspeicher an eine relationale Datenbank und eine Suchmaschine, und danach pflegen Sie drei Systeme mit drei Abfragesprachen. MyScale fasst sie in einem zusammen, sodass eine Abfrage gleichzeitig nach Metadaten filtern und nach Vektorähnlichkeit sortieren kann. Wer programmiert, behält seine SQL-Kenntnisse, statt eine eigene Vektor-API zu lernen.
Der Haken ist, dass MyScaleDB jung und schmaler ist als ClickHouse selbst. Sie zweigt von ClickHouse ab und ändert die Speicher- und Ausführungsengine für Vektorarbeit, kann also hinter der Originalversion zurückbleiben. Eine Open-Source-Version lässt sich unter Apache 2.0 selbst betreiben, doch das ausgereifte Erlebnis samt MSTG-Engine kommt über MyScale Cloud.
Getting Started
- Registrieren Sie sich auf myscale.com und starten Sie einen Cluster über die Seite Clusters.
- Holen Sie Host, Benutzername und Passwort aus Connection Details und verbinden Sie sich mit dem Python-Client, Node.js, Go, JDBC oder HTTPS.
- Legen Sie eine Tabelle an, fügen Sie Ihre Zeilen ein und setzen Sie einen Vektorindex auf die Vektorspalte mit einer Metrik wie cosine.
- Starten Sie eine Vektorsuche in SQL, mit ORDER BY distance und LIMIT, oder filtern Sie die Zeilen zuerst mit WHERE.
- Binden Sie die Datenbank über die Integrationen mit OpenAI, LangChain oder LlamaIndex in Ihren Stack ein und gehen Sie live.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von MyScale.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Backend- und KI-Entwickler
- RAG-Entwickler
- Datenteams
Aufgaben
- RAG-Suche versorgen
- Hybride Suche
- Gefilterte Vektorsuche
- Semantische Suche in eine App einbauen
Szenarien
- Ein Team, das seine erste RAG-Funktion ausliefert
- Ein Startup, das einen Stack aus mehreren Datenbanken ablöst
- Eine KI-App mit wachsenden Daten
Wichtigste Funktionen
Vektorabfragen in SQL
MyScale behandelt Vektorsuche als SQL-Operation. Sie setzen einen Vektorindex auf eine Spalte und sortieren die Zeilen dann mit einer Distanzfunktion innerhalb von ORDER BY, frei gemischt mit WHERE, JOIN und GROUP BY. Wenn Sie SQL können, können Sie hier schon eine Vektordatenbank abfragen.
MSTG-Vektorengine
Die MSTG-Engine ist der eigene Indexieralgorithmus von MyScale und nutzt NVMe-SSDs, um mehr Daten pro Knoten unterzubringen. Das Unternehmen sagt, sie erreiche etwa das 10-Fache der Datendichte üblicher Setups und schlage spezialisierte Vektordatenbanken bei den Kosten. Das ist der eigene Benchmark, also testen Sie ihn mit Ihren Vektoren, bevor Sie sich festlegen.
Volltext- und hybride Suche
Neben Vektoren liefert MyScale einen BM25-Volltextindex mit konfigurierbaren Tokenizern für verschiedene Sprachen. Sie starten die Textsuche allein oder mischen sie mit Vektortreffern in einer hybriden Abfrage. Für RAG holt diese Mischung oft bessere Abschnitte als jede Methode für sich.
Gefilterte Suche in jedem Verhältnis
Gefilterte Suche ist der wunde Punkt vieler Vektordatenbanken. MyScale wendet zuerst den Metadatenfilter an und sucht dann in den verbleibenden Zeilen, sodass die Genauigkeit hält, selbst wenn ein Filter nur einen winzigen Ausschnitt einer Milliardentabelle übrig lässt. In der Praxis ist das der Unterschied zwischen einem sauberen und einem langsamen, unscharfen Ergebnis.
Einheitliche Datenverwaltung
Der Speicher beschränkt sich nicht auf Vektoren. MyScale verwaltet strukturierte Spalten, JSON, Text, Geodaten und Zeitreihen in derselben Tabelle. Ein Produkt, sein Embedding und seine Verkaufshistorie liegen nebeneinander, sodass eine Abfrage KI-Merkmale mit Geschäftsdaten verbinden kann.
Integrationen und Clients
MyScale verbindet sich mit OpenAI, LangChain, LangChain JS/TS und LlamaIndex und liefert Clients für Python, Node.js, Go und JDBC plus eine HTTPS-Schnittstelle. Die meisten Teams hängen sie an eine bestehende Pipeline, statt bei null zu beginnen, und halten so die Migration kurz.
MyScale Telemetry
Telemetry bringt Beobachtbarkeit für LLM-Systeme, sodass Sie Prompts, Antworten und Abrufschritte an einer Stelle verfolgen. Ein RAG-Pipeline ohne sie zu debuggen heißt raten, woher eine schlechte Antwort kam; mit ihr sehen Sie den Abruf, der das Modell gespeist hat.
Sicherheit und Zugriffskontrolle
MyScale bietet rollenbasierte Zugriffskontrolle über SQL und erklärt Konformität mit SOC 2 und ISO 27001. Für Teams mit sensiblen Daten öffnet das einen Weg, begrenzten Zugriff zu geben, ohne den ganzen Cluster offenzulegen.
Vor- und Nachteile
Vorteile
- Weil sie vollständig SQL-kompatibel ist, kann jemand mit SQL-Kenntnissen Vektorsuche betreiben, ohne eine eigene API oder eine neue Abfragesprache zu lernen.
- Vektorsuche, Volltextsuche und Analyse teilen eine Engine, was die Zusatzdienste streicht, die ein typischer RAG-Stack braucht.
- Die MSTG-Engine zielt auf Vektoren in Milliardenhöhe auf der Platte, sodass große Sammlungen nicht komplett im Speicher liegen müssen.
- Die gefilterte Suche setzt Metadatenfilter vor dem Sortieren, was die Genauigkeit bei selektiven Abfragen hält.
- Der kostenlose Pod für 5M Vektoren à 768 Dimensionen und die Integrationen mit OpenAI, LangChain und LlamaIndex machen das Testen schnell.
Nachteile
- Die Leistungs- und Kostenzahlen von 4- bis 10-Fach stammen aus dem Benchmark des Unternehmens selbst, also sollten Sie sie mit Ihren Daten nachstellen, bevor Sie sich darauf verlassen.
- Als ClickHouse-Abzweig kann MyScaleDB hinter der Original-Engine und ihrem Funktionsumfang zurückbleiben, was zählt, wenn Sie die neuesten ClickHouse-Funktionen brauchen.
- Die stärksten Funktionen, inklusive MSTG-Engine, liegen in MyScale Cloud, also liefert der Selbstbetrieb der Open-Source-Version ein weniger vollständiges Produkt.
- Es gibt keine breite Mobile- oder Desktop-App, sie passt also eher zu Server- und Pipeline-Arbeit als zu Endnutzerwerkzeugen.
Häufige Fragen
MyScale speichert und fragt die Daten hinter KI-Apps ab, vor allem für den Abruf in RAG-Systemen und die semantische Suche. Sie halten Vektoren, Text und strukturierte Zeilen zusammen und fragen sie dann mit SQL ab.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu MyScale.
Alternativen zu MyScale

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

GitGlow
GitGlow · Coding · ProduktivitätGitGlow ist ein Git-Client für den Desktop, der Ihren Code und die Änderungen Ihrer KI-Agenten in einer Review bündelt, damit Sie vor dem Ausliefern sehen, was die Maschine verlässt.