
OctoAI
OctoAI (formerly OctoML, now part of NVIDIA) · Coding
OctoAI war eine KI-Inferenz-API in der Cloud, die offene Modelle wie Llama, Mistral und Stable Diffusion über einen OpenAI-kompatiblen Endpunkt bereitstellte. NVIDIA übernahm das Unternehmen 2024.
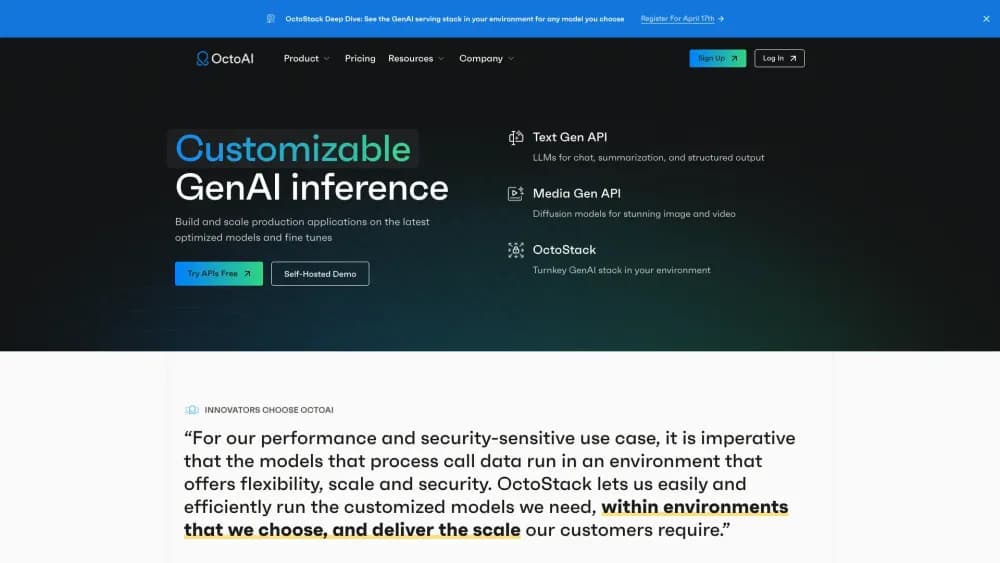
Über OctoAI
About
Was OctoAI war
OctoAI war ein Unternehmen aus Seattle, das schnellen und günstigen Zugang zu offenen KI-Modellen verkaufte. Man schickte eine Anfrage an die API, wählte ein Modell aus dem Katalog und bekam Text oder ein Bild zurück. Der Reiz lag in der Geschwindigkeit: Jedes Modell wurde so eingestellt, dass es aus derselben GPU mehr herausholte, sodass Antworten schneller kamen und weniger kosteten als bei einer gewöhnlichen Cloud-Bereitstellung.
Der Weg dorthin führte über Compiler, nicht über Chatbots. OctoAI startete 2019 als OctoML, ein Spin-off der University of Washington rund um Apache TVM, einen Open-Source-Compiler, der ein Modell so umschreibt, dass es auf dem vorhandenen Chip gut läuft. Diese Compiler-Arbeit wurde später zu einem Hosting offener Modelle für App-Entwickler, die Llama oder Stable Diffusion in einem Produkt brauchten, ohne ein Team für Machine-Learning-Infrastruktur einzustellen.
Diesen Dienst gibt es nicht mehr. NVIDIA übernahm OctoAI im September 2024, und das Unternehmen teilte Kunden mit, dass der Zugang zu allen OctoAI-Diensten am 31. Oktober 2024 endet. Konten wurden deaktiviert, die API abgeschaltet. Das Team wechselte in NVIDIAs Softwarebereich. Wer heute OctoAI sucht, findet ein abgeschlossenes Kapitel. Die eigentliche Frage ist, was an seine Stelle getreten ist.
Erste Schritte
Eine Anmeldung lässt sich nicht mehr durchlaufen, weil die Plattform eingestellt ist. Was folgt, beschreibt den Ablauf zu Betriebszeiten. Das hilft, wenn Sie alte Anleitungen lesen oder eine Migration planen.
- Legen Sie ein Konto auf der OctoAI-Plattform an und erzeugen Sie in der Konsole einen API-Token.
- Wählen Sie ein Modell aus dem Katalog wie Llama, Mistral oder Stable Diffusion XL oder laden Sie ein eigenes feinabgestimmtes Modell hoch.
- Richten Sie Ihren Code auf den OpenAI-kompatiblen Endpunkt, sodass sich fast jede bestehende Client-Bibliothek nach einem Wechsel der Basis-URL weiter nutzen ließ.
- Senden Sie eine Anfrage und lesen Sie die Antwort, ob erzeugter Text, Bild oder JSON.
- Für private Bereitstellungen betreiben Sie OctoStack im eigenen Cloud-Konto oder auf eigener Hardware, damit der Datenverkehr nicht über gemeinsam genutzte Infrastruktur läuft.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von OctoAI.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler, die auf offenen Modellen aufbauen
- Teams, die von OctoAI wegmigrieren
- Unternehmen in regulierten Branchen
Aufgaben
- Textgenerierung im Produktionsmaßstab bereitstellen
- Bilder mit Stable Diffusion XL erzeugen
- Ein feinabgestimmtes Modell hosten
- Eine alte Abhängigkeit prüfen
Szenarien
- Ein Prototyp, der auf OctoAI setzte
- Eine Anbieterprüfung für Inferenz
- Eine Anleitung von 2024 lesen
Wichtigste Funktionen
OpenAI-kompatible Textgenerierung
OctoAI betrieb Llama 2 in den Größen 7B, 13B und 70B samt Chat-Varianten, dazu Code Llama und Mistral 7B. Die API folgte dem Anfrageformat von OpenAI, sodass ein Wechsel des Anbieters für Teams, die diesen Standard nutzten, nur eine andere Basis-URL bedeutete. Diese Kompatibilität reduzierte den Test eines neuen Hosters auf wenige Zeilen Konfiguration.
Stable-Diffusion-API
Über die Bildseite lief Stable Diffusion XL, und eigene LoRA-Adapter ließen sich direkt im Aufruf anhängen. Ein Spielestudio oder ein Marketingteam erzeugte Grafiken im eigenen Stil, ohne ein Grundmodell zu trainieren. Anfragen lieferten das fertige Bild zurück, keine Wartenummer zum späteren Abfragen.
Hardwareunabhängige Optimierung
Der Vorsprung kam von Apache TVM, einem Compiler, der ein Modell in Code für einen bestimmten Chip übersetzt. OctoAI nahm diese Abstimmung auf den eigenen Servern vor, der Gewinn zeigte sich also in der Antwortzeit der API und nicht in einem Paket zum Installieren. Unterstützt wurden NVIDIA-GPUs, AMD-Hardware, Intel-CPUs und AWS-Inferentia-Chips. Diese Portabilität verlor an Gewicht, als sich der Markt auf NVIDIA konzentrierte.
OctoStack für private Bereitstellung
OctoStack, im April 2024 gestartet, ließ Unternehmen dieselbe Inferenz-Umgebung in ihrer eigenen Infrastruktur betreiben, ob bei AWS, Google Cloud, Azure, CoreWeave, Lambda Labs oder im eigenen Rechenzentrum. Der Verkaufsargument war Kontrolle über die Daten: Teams aus Gesundheitswesen, Finanzwesen und Verwaltung nutzten die Modelle, ohne Daten an OctoAI-Server zu schicken. Das Unternehmen nannte eine viermal bessere GPU-Auslastung und 50 Prozent niedrigere Betriebskosten als bei einem selbstgebauten Aufbau.
Eigenes Modell mitbringen
Über den Katalog hinaus ließ sich eine feinabgestimmte Llama-2-Variante auf der Plattform hosten und wie jeden anderen Endpunkt aufrufen. Das ersparte Teams eine eigene Serving-Schicht für ein angepasstes Modell, die Feinabstimmung musste aber anderswo erstellt und geprüft werden.
Nutzungsbasierte Preise
OctoAI rechnete nach Verbrauch statt mit einem festen Abo, mit einer kostenlosen Teststufe, Preisen pro Token für Text, pro Bild für SDXL und pro Rechenstunde bei eigenen Endpunkten. Die größte Ersparnis brachten die abgestimmten Modelle, die laut Unternehmen bis zu zehnmal schneller liefen als eine unoptimierte Bereitstellung.
Vor- und Nachteile
Vorteile
- Die API sprach das Format von OpenAI, ein Umzug bedeutete also nur neue Basis-URL und neuen Schlüssel
- Abgestimmte Modelle antworteten schneller und kosteten weniger pro Token als eine rohe GPU-Bereitstellung in der Cloud
- Eigene LoRA-Adapter gaben der Bildgenerierung einen einheitlichen Markenstil, ohne ein Modell zu trainieren
- OctoStack erlaubte regulierten Branchen, ihre Daten im eigenen Cloud-Konto zu behalten
- Eine kostenlose Teststufe erlaubte Latenz- und Qualitätsmessungen, bevor Budget gebunden wurde
Nachteile
- Die gesamte Plattform ging am 31. Oktober 2024 offline, rund fünf Wochen nach der Übernahme durch NVIDIA
- Kein NVIDIA-Produkt übernahm dieselbe Aufgabe, Kunden mussten ihre Anwendung also bei einem konkurrierenden Inferenzdienst neu aufbauen
- Die Modellauswahl hinkte den schnellsten Wettbewerbern hinterher, neue offene Modelle blieben wochen- oder monatelang bei der Konkurrenz
- Das Versprechen der Hardwareunabhängigkeit verlor an Wert, als sich der Markt auf NVIDIA-GPUs einigte, womit der Grund für OctoAI schrumpfte
- Preise für eigene Endpunkte waren schwerer zu planen als ein fester Satz pro Token, was die Budgetierung bei schwankendem Verkehr erschwerte
Häufige Fragen
NVIDIA übernahm OctoAI im September 2024, und das Unternehmen stellte alle kommerziellen Dienste am 31. Oktober 2024 ein. Das Team unter CEO Luis Ceze wechselte zu NVIDIA, API und Plattform nehmen keinen Datenverkehr mehr an.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu OctoAI.
Alternativen zu OctoAI

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

GitGlow
GitGlow · Coding · ProduktivitätGitGlow ist ein Git-Client für den Desktop, der Ihren Code und die Änderungen Ihrer KI-Agenten in einer Review bündelt, damit Sie vor dem Ausliefern sehen, was die Maschine verlässt.