
OpenScience
Synthetic Sciences · Coding · Produktivität
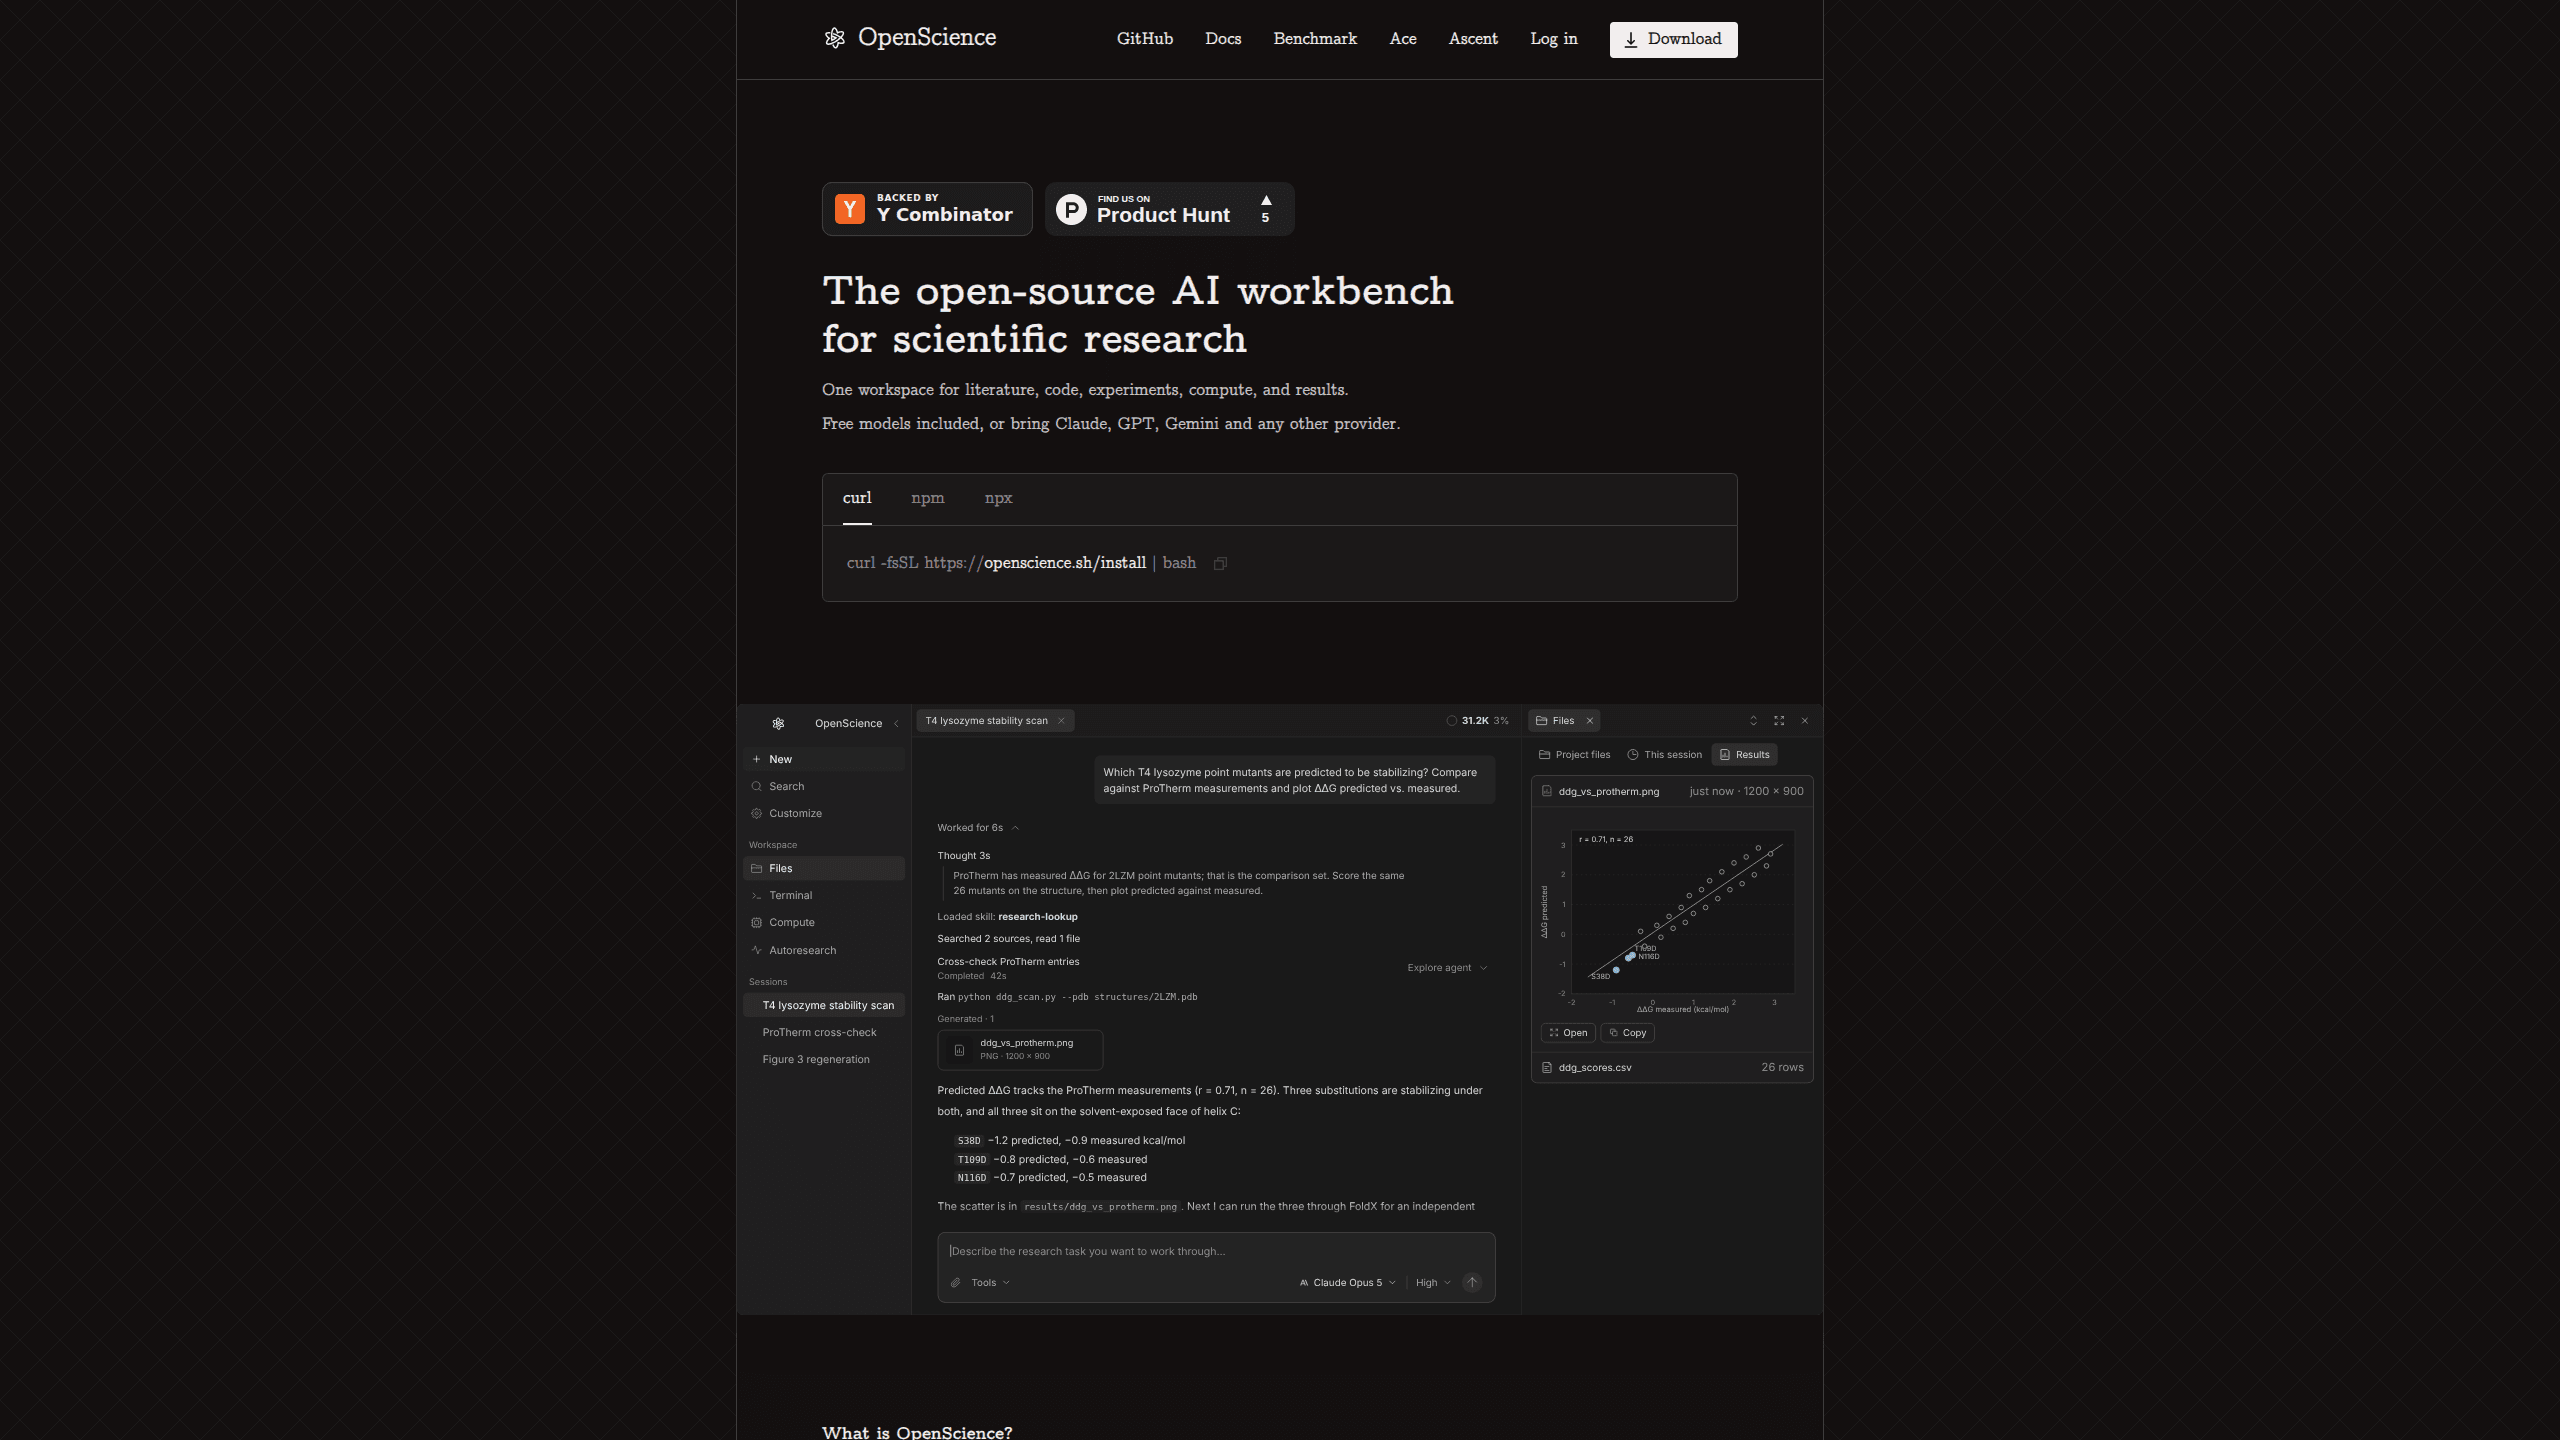
OpenScience ist eine Open-Source-Arbeitsumgebung für KI-Forschung, entwickelt von Synthetic Sciences. Sie liest Paper, schreibt und startet Code, fragt wissenschaftliche Datenbanken ab und hält die Belege zu jedem Ergebnis in einem Projekt zusammen.
Über OpenScience
About
Was ist OpenScience
OpenScience ist ein Arbeitsbereich, in dem ein KI-Forschungsagent Aufgaben übernimmt. Sie beschreiben eine Frage, verweisen auf Dateien oder einen Datensatz, und der Agent durchsucht die Literatur, schreibt Python oder R, fragt Quellen wie UniProt oder PDB ab und verfasst die Zusammenfassung. Hinter dem Produkt steht Synthetic Sciences, ein von Y Combinator unterstütztes Unternehmen, das es als KI-Co-Wissenschaftler vermarktet und den Code unter Apache 2.0 veröffentlicht.
Die meisten Werkzeuge für KI in der Wissenschaft setzen einen Modellanbieter und einen gehosteten Ablauf voraus. Hier ist die Ausgangslage umgekehrt. Echte Analyse springt vom Chatfenster ins Notebook, vom Notebook ins Cluster-Terminal und von dort in die Literaturverwaltung, und der Faden von einer Abbildung zurück zum erzeugenden Code geht dabei verloren. OpenScience hält Projekte, Sitzungen, Dateien, Läufe und gespeicherte Ergebnisse an einer Stelle, sodass eine Kollegin die Arbeit Monate später wieder öffnen und nachvollziehen kann, wie eine Zahl entstanden ist. Genau das braucht reproduzierbare Forschung im Alltag.
Der Einstieg kostet Zeit. Es braucht die Desktop-App oder das Kommandozeilenwerkzeug, und der Modellzugang muss geklärt sein: eigener Schlüssel, Anbieter-Abo, lokales Modell oder der kostenpflichtige Dienst Ace. Die Dokumentation verlangt außerdem, Methoden zu lesen und Ergebnisse zu prüfen, bevor daraus ein Manuskript wird.
Erste Schritte
- Laden Sie die Desktop-App für macOS, Windows oder Linux herunter, oder installieren Sie die CLI mit npm install -g @synsci/openscience@latest und starten Sie den Arbeitsbereich im Projektordner.
- Legen Sie ein Konto bei Synthetic Sciences an. Der Assistent beim ersten Start fragt danach, auch wenn Sie eigene Modellschlüssel mitbringen.
- Wählen Sie den Modellzugang unter Customize → Models: verwaltete Modelle über Ace, einen API-Schlüssel Ihres Anbieters, eine Anmeldung bei ChatGPT oder Claude oder ein lokales Modell auf Ihrer Hardware.
- Eröffnen Sie ein Projekt und beschreiben Sie die Aufgabe mit drei Angaben: Eingabe, erwartete Ausgabe und Grenzen. Hängen Sie Daten an oder verweisen Sie auf vorhandene Dateien.
- Verfolgen Sie den Lauf, prüfen Sie den ausgeführten Code und die verwendeten Quellen, und exportieren Sie den Bericht oder arbeiten Sie in derselben Sitzung weiter.
Eine gute erste Anfrage nennt eine Datei und ein Ziel. Bitten Sie um die Auswertung von data/measurements.csv, um Prüfung fehlender Werte, den Vergleich der Behandlungsgruppen und eine Grafik samt Methodennotiz in results/. Dann hat der Agent etwas Konkretes, gegen das er seine Arbeit prüfen kann.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von OpenScience.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Doktoranden und Postdocs
- Bioinformatiker und Chemiker
- Forschungsingenieure und ML-Teams
Aufgaben
- Literaturrecherche mit angehängten Quellen
- Datenauswertung und Statistik
- Ein veröffentlichtes Ergebnis nachvollziehen
Szenarien
- Ein Labor übernimmt das Projekt einer ausgeschiedenen Person
- Eine Gruppe hat ein Cluster, aber kein eigenes Tooling-Team
- Ein Manuskript braucht den Methodenteil
Wichtigste Funktionen
Ein Projekt für den ganzen Forschungszyklus
Jedes Projekt sammelt Sitzungen, hochgeladene Dateien, erzeugte Dateien und gespeicherte Ergebnisse. Das Gespräch bewahrt die Antworten des Agenten neben den gestarteten Befehlen, gelesenen Dateien und zitierten Quellen. Wenn eine Abbildung zählt, springen Sie zu der Sitzung zurück, die sie erzeugt hat, statt in alten Notebooks zu suchen.
Modell jederzeit austauschbar
OpenScience ist modellunabhängig. Ace bietet einen geprüften Katalog von 21 Modellen von OpenAI, Anthropic, Google, xAI, Z.ai, DeepSeek, Qwen, Moonshot, MiniMax, Xiaomi, Meta und NVIDIA auf verwalteten Routen. Sie können auch einen eigenen API-Schlüssel einbinden, ein ChatGPT-Plus- oder Pro-Abo weiterverwenden oder ein offenes Modell lokal betreiben. Ein Wechsel der Route verlangt kein neues Projekt.
42 wissenschaftliche Datenbanken als Werkzeuge
UniProt, PDB, ChEMBL, PubChem und arXiv sind enthalten, dazu 37 weitere Quellen, und der Agent ruft sie als Werkzeuge auf, statt Sie um eingefügte Ergebnisse zu bitten. Bei Strukturarbeit heißt das: PDB-Eintrag holen, Mutanten gegen gemessene Werte bewerten und den Vergleich in einem Durchgang zeichnen.
371 mitgelieferte Skills
Der Client kommt mit 371 Skills aus Biologie, Chemie, Physik, Machine Learning und wissenschaftlichem Schreiben. Ein kuratierter Kern deckt die üblichen Schritte ab, und jede Skill-Datei lässt sich lesen und ändern, sodass ein Labor ein Protokoll an eigene Konventionen anpasst oder eine interne Methode ergänzt.
Rechenleistung vom Laptop bis zum Cluster
Der Agent baut Umgebungen auf und bringt einen Job über die Maschine vor Ihnen hinaus. Kleine Analysen laufen lokal, größere Durchläufe gehen an ein Cluster oder einen GPU-Host. Diese Flexibilität erspart das Umschreiben, wenn aus einem Notebook-Prototyp ein Lauf mit Stunden Rechenzeit wird.
Desktop, Browser und Terminal
Derselbe Arbeitsbereich öffnet als Desktop-App, im Browser nach dem Start der CLI oder per einzelnem Befehl für eine kurze Anfrage. Wer im Terminal lebt, und wer einen grafischen Dateibaum bevorzugt, arbeiten im selben Projekt, ohne etwas zu exportieren.
Vor- und Nachteile
Vorteile
- Der Code ist unter Apache 2.0 offen, ein Labor kann also prüfen, was der Agent tut, forken oder ohne Anbietervertrag betreiben.
- Die Modellwahl bleibt bei Ihnen, inklusive lokaler Modelle für sensible Daten und bereits bezahlter ChatGPT- oder Claude-Abos.
- Die Datenbankliste deckt die Quellen ab, die Projekte in Life Sciences und Chemie tatsächlich zitieren, und sie laufen als Agent-Werkzeuge statt als manuelle Abfragen.
- Ergebnisse behalten ihre Herkunft: erzeugender Code, Eingaben und Laufhistorie bleiben am Artefakt.
- Synthetic Sciences veröffentlicht Ergebnisse zu Terminal-Bench Science, Terminal-Bench 4.0, BiomniBench-DA und dem eigenen OpenScience Bench. Das sind Zahlen zum Nachprüfen statt einer vagen Behauptung.
Nachteile
- Beim ersten Start ist ein Konto nötig, auch für die Open-Source-Version, und die Anmeldung aktiviert standardmäßig das Teilen von Sitzungsspuren. Das lässt sich pro Gerät abschalten, der Standard verdient in klinischen oder industriellen Laboren aber Aufmerksamkeit.
- Die Einrichtung setzt Terminal-Erfahrung voraus. CLI installieren, Modellroute wählen und Schlüssel verwalten kosten mehr Zeit als das Öffnen einer Chat-App.
- Die Benchmark-Zahlen stammen aus eigenen Läufen des Anbieters, mehrere davon auf hauseigenen Tests. Unabhängige Nachprüfungen sind noch dünn.
- Modellkosten kommen zur Software dazu und hängen von der Route ab. Eine lange Sitzung kann teurer werden als erwartet, wenn Sie das Guthaben nicht beobachten und kein Limit setzen.
Häufige Fragen
OpenScience ist eine Open-Source-Arbeitsumgebung für wissenschaftliche Forschung mit KI von Synthetic Sciences. Ein Agent liest Paper, schreibt und startet Code, fragt wissenschaftliche Datenbanken ab und speichert Ergebnisse mit den Belegen, auf denen sie beruhen. Die Umgebung läuft als Desktop-App, im Browser oder als CLI.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu OpenScience.
Alternativen zu OpenScience

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

GitGlow
GitGlow · Coding · ProduktivitätGitGlow ist ein Git-Client für den Desktop, der Ihren Code und die Änderungen Ihrer KI-Agenten in einer Review bündelt, damit Sie vor dem Ausliefern sehen, was die Maschine verlässt.