
QwQ-32B
Alibaba (Qwen team) · Business · Sonstiges
QwQ-32B ist das Reasoning-Modell mit offenen Gewichten vom Qwen-Team bei Alibaba: Es löst Mathe und Code Schritt für Schritt und läuft auf einer einzelnen eigenen GPU.
Über QwQ-32B
What Is QwQ-32B
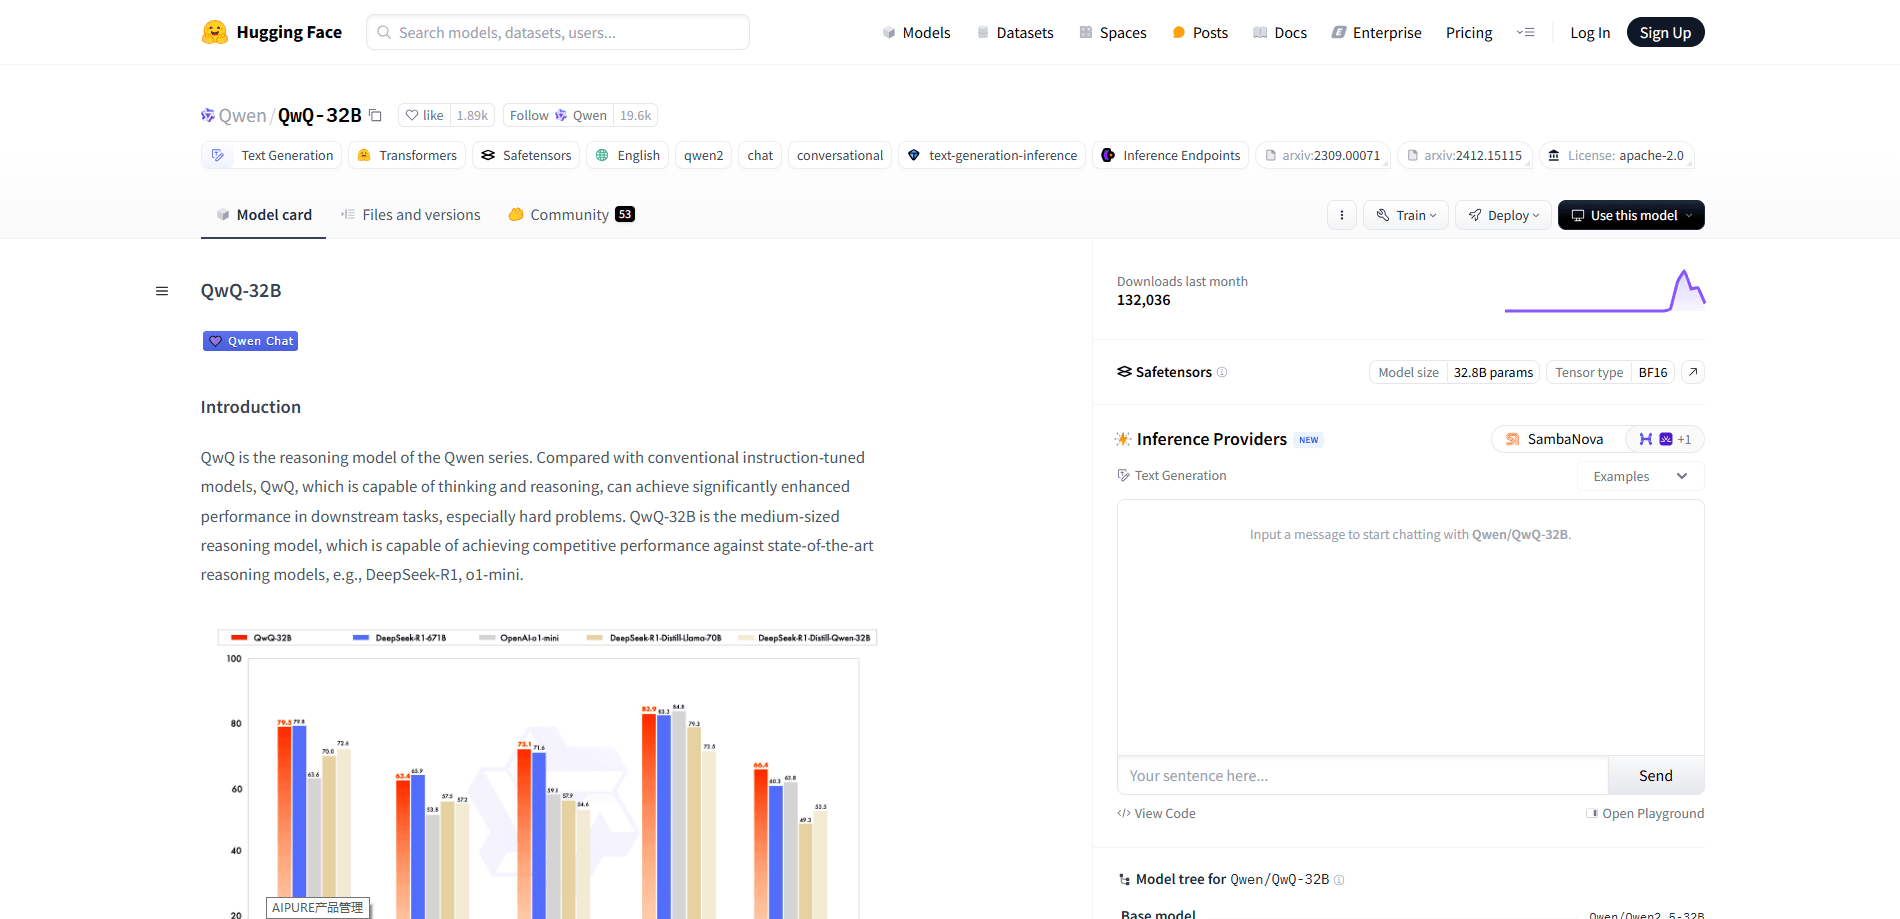
QwQ-32B ist ein auf Reasoning ausgerichtetes Sprachmodell des Qwen-Teams bei Alibaba, veröffentlicht im März 2025 unter der Apache-2.0-Lizenz. Es hat 32 Milliarden Parameter und stammt vom allgemeinen Modell Qwen2.5-32B ab. Statt sofort zu antworten, schreibt es eine lange Gedankenkette, prüft die eigenen Schritte und legt sich erst dann auf eine Antwort fest. Diese Angewohnheit nennt man Reasoning, und sie erklärt, warum das Modell bei Fragen punktet, bei denen Raten teuer wird.
Als Open-Source-Reasoning-Modell lässt es sich zudem prüfen, statt es zu mieten. Die zentrale Aussage des Qwen-Teams lautet, dass QwQ-32B mit DeepSeek-R1 mithält, einem Modell mit 671 Milliarden Parametern. Das Team führt das auf Reinforcement Learning zurück und nicht auf die Größe: Es skalierte RL für Mathe und Code und schob dann eine zweite Runde für allgemeine Fähigkeiten nach. Für Sie bleibt ein solides Reasoning-Modell, das klein genug ist, um es selbst zu betreiben.
Die Grenze liegt im Umfang. QwQ-32B denkt, bevor es spricht, also ist es bei trivialen Aufgaben langsam, und seine Gewichte sind auf dem Stand der ersten Veröffentlichung eingefroren. Spätere Qwen-Modelle decken mehr Sprachen ab und wechseln zwischen schnellem und tiefem Modus, deshalb ist QwQ-32B eher ein gezieltes Reasoning-Werkzeug als ein Assistent für alles.
Getting Started
- Laden Sie die Gewichte von Hugging Face oder ModelScope, oder holen Sie die quantisierte Variante mit
ollama run qwq - Binden Sie das Modell in einen Inferenzserver wie vLLM, SGLang oder Ollama ein, je nach Hardware
- Senden Sie die Anfrage über den OpenAI-kompatiblen Endpunkt des Servers und lesen Sie die Denkspur vor der endgültigen Antwort
- Für gehosteten Zugang rufen Sie die Qwen-API bei Alibaba Cloud Model Studio mit dem Modellnamen
qwq-32bauf
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von QwQ-32B.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler, die ein Reasoning-Modell auf eigener Hardware wollen
- Studierende und Selbstlerner, die an Mathe- oder Code-Aufgaben hängen
- Forscher, die Reasoning-Modelle vergleichen
Aufgaben
- Matheaufgaben im Wettbewerbsstil lösen
- Code schreiben und debuggen
- Werkzeuggestützte Agenten bauen
- QwQ-32B lokal ausführen nach der Quantisierung
Szenarien
- Vertrauliche Daten im Haus behalten
- Arbeit offline oder im abgeschotteten Netz
- Eine Reasoning-Funktion prototypen
Wichtigste Funktionen
Reasoning über eine lange Gedankenkette
QwQ-32B arbeitet ein Problem in ausdrücklichen Schritten durch, bevor es antwortet. Sie lesen diese Gedankenkette, erkennen, wo es abgeirrt ist, und formulieren den Prompt neu. Das ist der Unterschied zwischen einem Modell, das sicher klingt, und einem, das Sie tatsächlich prüfen können.
Mathe- und Code-Leistung nahe an viel größeren Modellen
Das Qwen-Team berichtet, dass der QwQ-32B-Benchmark bei Tests wie AIME und LiveCodeBench mit DeepSeek-R1 gleichzieht, trotz des Größenunterschieds. Genau diese zwei Bereiche stecken im Training, also ist es die naheliegende Wahl, sobald Zahlen oder Code im Spiel sind.
Werkzeugaufrufe mitten im Reasoning
QwQ-32B ruft Funktionen mitten im Denken auf und führt die Ergebnisse in seinen Plan zurück. Braucht die Aufgabe aktuelle Daten oder eine externe Aktion, entscheidet das Modell, wann es zu einem Werkzeug greift, statt zu raten. Dadurch taugt es als Kopf eines Agenten, nicht nur als Chatpartner.
Offene Gewichte unter Apache 2.0
Die vollständigen Gewichte lassen sich herunterladen, und die Lizenz ist freizügig: Sie können das Modell feinjustieren, quantisieren oder in ein Produkt einbauen. Nichts hängt hinter einem Anbieterkonto, was zählt, wenn Sie darauf aufbauen.
Läuft quantisiert auf einer einzelnen GPU
In voller Genauigkeit braucht das Modell viel Speicher, doch 4-Bit-Varianten schrumpfen es auf eine Consumer-Karte. Sie bekommen Reasoning, das früher ein Rechenzentrum verlangte, auf einer eigenen Maschine.
OpenAI-kompatibles Serving
Server wie vLLM und SGLang stellen QwQ-32B über eine API im OpenAI-Stil bereit. Sie richten Ihren bestehenden Code auf eine neue URL und einen neuen Schlüssel, und es läuft, der Umstieg dauert also Minuten statt einer Neuentwicklung.
Vor- und Nachteile
Vorteile
- Reasoning-Qualität, die laut den Benchmarks des Qwen-Teams mit viel größeren Modellen mithält
- Offene Gewichte unter Apache 2.0, also freies Selbsthosten, Feinjustieren und Weitergeben
- Quantisierte Varianten laufen auf einer einzelnen Consumer-GPU, was die Daten lokal hält
- Werkzeugaufrufe funktionieren in der Reasoning-Schleife und machen es zu einer soliden Agentenbasis
- Ein OpenAI-kompatibler Server bedeutet wenige Codeänderungen für den Einstieg
Nachteile
- Es ist von Natur aus langsam: Jede triviale Frage löst einen kompletten Denkdurchlauf aus, der Chat-Betrieb wirkt dadurch zäh
- Die Gewichte sind auf dem Stand von 2025 eingefroren, die neue Sprachabdeckung und Modi späterer Qwen-Modelle fehlen
- Der Speicherbedarf in voller Genauigkeit ist hoch, auf bescheidener Hardware führt kein Weg an der Quantisierung vorbei
- Das Training zielte auf Mathe und Code, freies Schreiben oder seltene Sprachen können hinter einem Allround-Modell zurückbleiben
Häufige Fragen
Es ist ein Sprachmodell mit offenen Gewichten und Fokus auf Reasoning, vom Qwen-Team bei Alibaba. Es hat 32 Milliarden Parameter und arbeitet Probleme Schritt für Schritt durch, bevor es antwortet, daher die Stärke bei Mathe und Code.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu QwQ-32B.
Alternativen zu QwQ-32B

Knocket
Knocket (Tencent RTC team) · Produktivität · Business · ChatbotKnocket ist ein kostenloses Werkzeug für Live-Chat und Kontaktseite: Besucher schreiben über Ihre Website, Ihre App oder einen Link, und Sie antworten aus Telegram oder einem einzigen Posteingang.

shippedit.me
Krawlup · Marketing · Businessshippedit.me leitet inzwischen auf Krawlup um, eine Web-Plattform, die SEO, AEO und Ladezeit wöchentlich prüft und die Korrekturen per MCP an Coding-Agenten übergibt.

Ayven
Alknoma · Produktivität · BusinessAyven ist ein KI-Kontrollzentrum von Alknoma: Es macht aus einem einfach formulierten Ziel einen datierten Plan, verteilt die Aufgaben an Ihr Team und seine KI-Agenten und fragt nur dann nach Freigabe, wenn die Entscheidung bei Ihnen liegt.