
Reflection 70B
HyperWrite · Schreiben · Chatbot
Reflection 70B ist ein Modell mit offenen Gewichten von HyperWrite. Auf Basis von Llama 3.1 70B prüft dieses selbstkorrigierende LLM sein eigenes Denken, bevor es antwortet.
Über Reflection 70B
Was ist Reflection 70B
Reflection 70B ist ein auf Reasoning ausgerichtetes Sprachmodell von HyperWrite, veröffentlicht Anfang September 2024 und aufgebaut auf Metas Llama 3.1 70B Instruct. Sein Verkaufsargument ist eine Trainingsmethode namens Reflection-Tuning, die dem Modell beibringt, Fehler in der eigenen Gedankenkette zu erkennen und sie zu beheben, bevor es sich auf eine endgültige Antwort festlegt. Das Modell schreibt sein Denken in <thinking>-Tags und seine endgültige Antwort in <output>-Tags und fügt einen <reflection>-Block ein, sobald es mitten im Reasoning einen Fehler bemerkt.
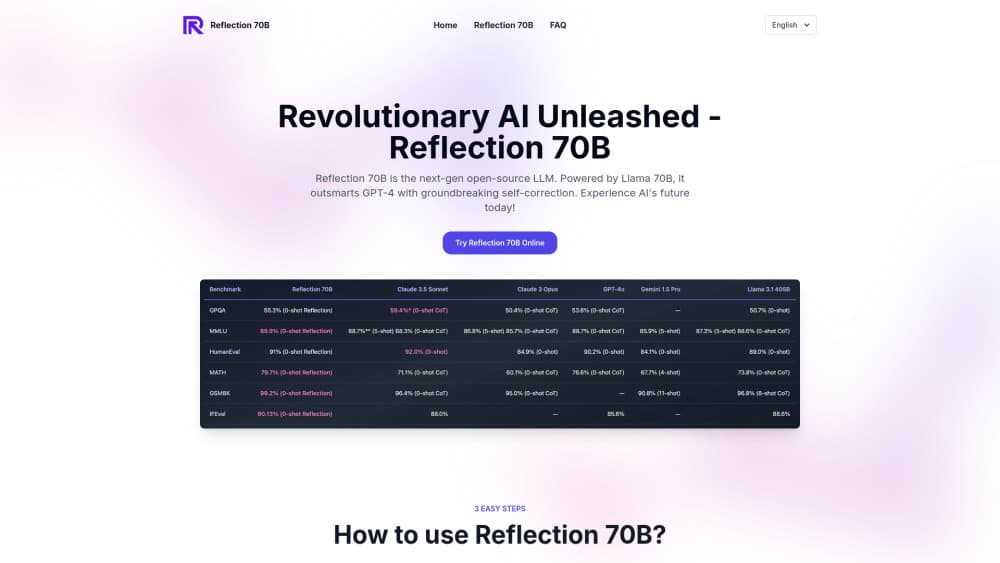
Die Idee packt eine echte Frustration an. Standard-LLMs halluzinieren. Sie merken es selten. Reflection 70B wurde darauf trainiert, es zu merken. Laut HyperWrite schlug das Modell GPT-4o und sogar Llama 3.1 405B in Benchmarks wie MMLU, MATH, IFEval und GSM8K. Diese Zahlen zogen beim Start enorme Aufmerksamkeit auf sich.
Dieser frühe Hype hielt dem Kontakt mit Dritten nicht stand. Unabhängige Prüfer, darunter Artificial Analysis, konnten die Spitzenwerte nicht reproduzieren. Spätere Tests ergaben, dass auf Hugging Face veröffentlichte Versionen schlechter abschnitten als das einfache Llama 3.1 70B, auf dem das Modell aufbaut. Manche Nutzer warfen der gehosteten API außerdem vor, Anfragen still an Claude weiterzuleiten. Matt Shumer von HyperWrite räumte ein, dass das Modell hinter seinen gemeldeten Benchmarks zurückblieb.
Das ehrliche Fazit fällt also gespalten aus. Der Ansatz des Reflection-Tuning ist wirklich interessant. Das Modell in der ausgelieferten Form hat sein eigenes Marketing nie erreicht. Veröffentlichungen von Modellen mit offenen Gewichten wie diese sind trotzdem eine Untersuchung wert, auch wenn der Launch-Pitch sie überverkauft.
Erste Schritte
- Öffnen Sie die Modellseite auf Hugging Face (mattshumer/Reflection-70B) oder einen Mirror und akzeptieren Sie die Lizenzbedingungen.
- Laden Sie die Gewichte herunter, oder überspringen Sie die lokale Einrichtung und betreiben Sie das Modell über einen gehosteten Inferenzanbieter.
- Laden Sie es mit demselben Code, den Sie für jedes Llama-Modell verwenden würden, da es Llama's Chat-Template teilt.
- Geben Sie ihm die Reasoning-Systemnachricht, damit es Denken, Reflexion und Antwort in dieser Reihenfolge ausgibt.
- Lesen Sie die
<reflection>-Tags, wenn Sie sehen möchten, wo das Modell seine Meinung geändert hat.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Reflection 70B.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Forscher
- Entwickler lokaler Reasoning-Tools
- Hobbyisten mit Neugier auf Reflection-Prompts
Aufgaben
- Mathe- und Logikaufgaben
- Prototyping von Selbstprüfungs-Pipelines
- Vergleichsstudien
Szenarien
- Ein Reasoning-Modell betreiben, ohne Daten an eine geschlossene API zu senden
- Bewertungsfallen studieren
- Reflection-Prompts mit kleinem Budget ausprobieren
Wichtigste Funktionen
Reflection-Tuning
Reflection-Tuning ist die Technik, die dem Modell seinen Namen gibt. Statt nur auf endgültige Antworten zu trainieren, bringt sie dem Modell bei, sein eigenes Denken zu prüfen und mitten in der Generierung zu überarbeiten. In der Praxis erzeugt das Modell einen Entwurf seines Denkens, prüft ihn und schreibt die Teile neu, die es für falsch hält, bevor es eine Antwort liefert. Diese Reihenfolge ist die ganze Idee: erst korrigieren, dann festlegen.
Strukturierte Denk- und Ausgabe-Tags
Das Modell trennt seine interne Arbeit mit speziellen Tokens von seiner Antwort. Das Reasoning steht in <thinking>-Tags, die endgültige Antwort in <output>-Tags. Diese Trennung lässt die Schmierarbeit sichtbar, was praktisch ist, wenn Sie nachvollziehen wollen, warum ein Modell zu einer Schlussfolgerung kam, oder wenn Sie das Denken lieber verbergen und nur die Antwort zeigen.
Inline-Selbstkorrektur
Wenn das Modell einen Fehler bemerkt, gibt es einen <reflection>-Block in seinem Denken aus. Sie können diesen Block lesen, um genau zu sehen, wo das Reasoning umgeschwenkt ist. Bei Aufgaben mit einer einzigen richtigen Antwort ist dieser sichtbare Wendepunkt oft nützlicher als die Antwort selbst, weil er zeigt, wie das Modell seinen eigenen Fehler fängt, statt ihn zu vergraben.
Llama-Kompatibilität
Weil es auf Llama 3.1 70B Instruct aufbaut und das Standard-Chat-Format von Llama beibehält, passt Reflection 70B in Tools und Pipelines, die Llama schon unterstützen. Wenn Sie schon einmal ein Llama-Modell bereitgestellt haben, übertragen sich Ladecode und Serving-Setup mit wenigen Änderungen. Diese Kompatibilität ist der Grund, warum das Modell von Anfang an leicht zu testen war.
Fokus auf hochpräzises Reasoning
Das Modell zielt auf Aufgaben, die Genauigkeit über Geschwindigkeit stellen, etwa mehrstufige Mathematik und Logik. Es zerlegt das Reasoning in einzelne Schritte und gibt mehr Tokens fürs Gegenprüfen aus. Der Preis dafür ist die Latenz. Antworten kommen später, und die Token-Kosten steigen, weil Reflexion bedeutet, mehr Text zu schreiben, bevor die letzte Zeile kommt.
Offene Gewichte
Die Gewichte sind öffentlich verfügbar, sodass Sie das Modell auf eigener Hardware betreiben, feinabstimmen oder untersuchen können, wie das Reflexionstraining sein Verhalten verändert hat. Offene Gewichte bedeuten auch, dass Sie nicht an Preis oder Ratenlimits eines einzelnen Anbieters gebunden sind, was zählt, wenn Sie das Modell in irgendeinem Umfang testen.
Vor- und Nachteile
Vorteile
- Offene Gewichte, die Sie herunterladen, untersuchen und selbst hosten können
- Auf Llama 3.1 70B aufgebaut, also kompatibel mit vorhandenem Llama-Tooling und Serving-Stacks
- Sichtbare Selbstkorrektur über Denk-, Reflexions- und Ausgabe-Tags
- Lokal kostenlos, mit günstiger gehosteter Inferenz, wenn Sie keine GPUs verwalten möchten
Nachteile
- Unabhängige Benchmarks bestätigten die Leistungsaussagen beim Start nie
- Manche Hugging-Face-Versionen sollen unter dem einfachen Llama 3.1 70B gelegen haben
- Lange Denk- und Reflexionsschritte erhöhen Latenz und Token-Kosten
- Die gehostete API zog Vorwürfe auf sich, Traffic an Claude zu leiten, was Vertrauen kostete
Häufige Fragen
Es ist ein Open-Source-Sprachmodell von HyperWrite, aufgebaut auf Llama 3.1 70B Instruct, das eine Trainingsmethode namens Reflection-Tuning nutzt, um sein eigenes Reasoning vor der Antwort zu prüfen und zu korrigieren.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Reflection 70B.
Alternativen zu Reflection 70B

Claude for Google Workspace
Anthropic · Schreiben · Produktivität · BusinessClaude for Google Workspace öffnet eine Claude-Seitenleiste in Google Docs, Sheets und Slides. Sie liest die geöffnete Datei und ändert sie direkt im Dokument.

Claude Haiku 5.5
Anthropic · Schreiben · Coding · ChatbotClaude Haiku 5.5 ist Anthropics schnellstes und günstigstes kleines Modell: 0,10 US-Dollar pro Million Eingabe-Tokens und ein Kontext von 1M Tokens.

NoteWorthy
Suman Hansada · Schreiben · Produktivität · KI-AssistentNoteWorthy ist eine Notizen-App für iPhone, iPad und Mac, die Titel schreibt, Formatierung aufräumt, lange Notizen zusammenfasst und jede Notiz mit KI direkt auf dem Gerät einsortiert. Kein Konto, kein Upload, keine Netzwerkanfrage.