
Reworkd AI
Reworkd · Coding
Reworkd AI ist eine Webscraping-Plattform auf Basis von Sprachmodellen, die Scraper im großen Stil erstellte und betrieb und Websites in strukturierte Daten verwandelte. Am 6. Februar 2025 eingestellt.
Über Reworkd AI
What Is Reworkd AI
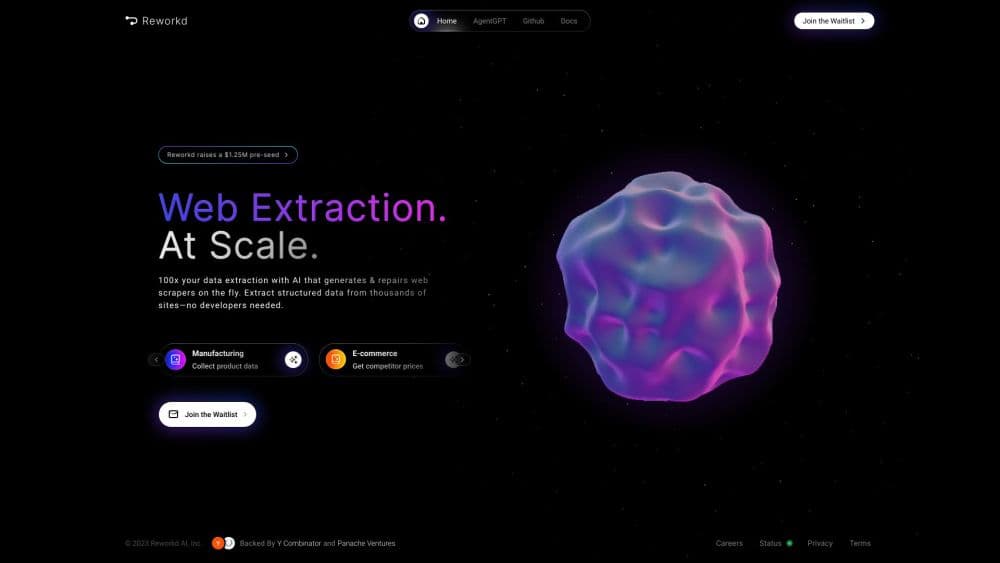
Reworkd AI ist eine Plattform zur Web-Datenextraktion, die große Sprachmodelle nutzte, um Scraper zu erstellen und strukturierte Daten von Websites zu ziehen. Dieses LLM-Webscraping lief so: Sie beschrieben die gewünschten Felder in einem Schema, und die Agenten fanden selbst heraus, wie sie sie über die ganze Website und ihre Unterseiten einsammeln, ohne von Hand geschriebene Selektoren. Genau darum ging es bei der Web-Datenextraktion in dieser Größenordnung, und das Unternehmen zielte auf Teams, die Daten in großem Umfang brauchten, von Produktkatalogen über Preistabellen bis zu Bewertungen.
Die Botschaft war die Breite. Reworkd erklärte, seine Kunden extrahierten Millionen Zeilen, um domänenspezifische Modelle zu trainieren und bestehende Daten-Pipelines zu versorgen, eine Arbeit, die sonst ein Team von Ingenieuren an zerbrechlichen Scrapern erfordert. Reworkd wollte das auf ein Schema plus eine Quellenliste zusammenstreichen.
Am wichtigsten ist: Das Produkt gibt es nicht mehr. Reworkd kündigte an, die Plattform am 6. Februar 2025 einzustellen, und verwies Nutzer auf einen Kontakt für die Migration. Das Team steckt auch hinter AgentGPT, einem Open-Source-Projekt für autonome Agenten auf GitHub, und das läuft weiter. Das kommerzielle Scraping-Produkt nicht. Dieser Unterschied zählt, wenn Sie hier landen und ein funktionierendes Werkzeug erwarten.
Getting Started
- Legen Sie ein Konto an und richten Sie eine Gruppe ein, den Container für die URLs, die Sie scrapen wollen.
- Definieren Sie ein Schema, die strukturierte Liste der Felder, die der Scraper zurückgeben soll.
- Fügen Sie der Gruppe Quell-URLs hinzu. Jede URL wird zu einem Job, der durch Kategorie-, Listen- und Detailseiten läuft.
- Lassen Sie das Modell den Scraper bauen und ausführen. Jobs reihen beim Crawlen Unterseiten ein, und jeder Durchlauf meldet Status und Ergebnisse.
- Exportieren Sie die Ergebnisse über die Oberfläche, die API oder einen Massenexport, und planen Sie die Gruppe so, dass sie in festen Abständen erneut scrapt.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Reworkd AI.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Datenteams in Startups
- Machine-Learning-Ingenieure
- Entwickler, die eine Idee testen
Aufgaben
- Einen Produktkatalog aus Shop-Websites aufbauen
- Bewertungen in großer Zahl sammeln
- Eine Daten-Pipeline regelmäßig versorgen
- Einen vorhandenen Datensatz anreichern
Szenarien
- Ein Recherche-Sprint, in dem schnell Hunderttausende Zeilen nötig sind
- Einen internen Datensatz frisch halten
- LLM-Scraping prüfen, bevor Sie sich festlegen
Wichtigste Funktionen
Von LLM erstellte Scraper
Die Kernidee: Sie beschrieben die gewünschten Daten in einem Schema, und die Plattform erzeugte den Scraper, statt Ihnen Selektoren abzuverlangen. Das senkte die Hürde bei Seiten mit wechselndem Markup, wo CSS-Selektoren brechen, sobald ein Redesign kommt. Für Teams ohne eigenen Scraping-Ingenieur ersetzte es wochenlange Rüstzeit durch ein auszufüllendes Formular.
Gruppen und schemagesteuerte Jobs
Eine Gruppe bündelte Quell-URLs, die sich ein Schema und eine Crawl-Frequenz teilten. Innerhalb der Gruppe wurde jede URL zu einem Job, den die Plattform in Stufen zerlegte: eine Kategorieseite, dann Listenseiten, dann Detailseiten. Diese Struktur ließ eine einzige Definition eine ganze Website und ihre Unterseiten abdecken, sodass der Sprung von zehn auf zehntausend URLs keine Nacharbeit bedeutete.
Geplantes, wiederholtes Scraping
Gruppen ließen sich so planen, dass sie in festen Abständen erneut liefen, und das trennte Reworkd von einem einmaligen Crawl. Daten-Pipelines brauchen frische Einträge, und die Planung machte aus einem manuellen Scrape einen wiederkehrenden. Die Ergebnisse kamen als bereits entdoppelte Ansicht zurück, aktualisiert bei jedem neuen Lauf der Gruppe.
Exporte und API
Die gesammelten Daten verließen die Plattform auf drei Wegen: Massenexporte über die Oberfläche, eine API zum programmatischen Abholen der Ausgaben und Unterstützung für Dateidownloads mitten im Scraping. Die API machte Reworkd in einer bestehenden Pipeline nutzbar und nicht als Ziel, das man aufsuchen muss. Eine eigene Scraping-API zum programmatischen Abholen gehörte dazu, die Ausgaben waren entdoppelt und pro Gruppe materialisiert, sodass Konsumenten eine saubere Ansicht bekamen statt roher Duplikate.
Umgang mit Sitzungen und Cookies
Manche Seiten verstecken Inhalte hinter einem Login oder halten den Zustand in Cookies und lokalem Speicher. Reworkd bot API-Endpunkte zum Lesen und Schreiben von Cookies und lokalem Speicher, sodass Scraper Seiten erreichten, die ein gewöhnlicher HTTP-Client nie erreichen würde. Das zählte für alles hinter einer Kontosperre und ist eine häufige Lücke bei einfacheren Scraping-Werkzeugen.
Der technische Unterbau
Die Plattform lief auf einer Streaming-Architektur, und das Team schrieb öffentlich darüber, wie es Echtzeit-Extraktion mit agentischer KI und GenAI skalierte. Der Mitgründer von Reworkd beschrieb den Umgang mit Terabytes pro Tag bei gleichzeitiger Vermeidung von Blocks, was das Designziel war. Das sagt Ihnen, dass der gedachte Nutzer ein Team mit echtem Volumen war, nicht jemand, der einmal eine Tabelle zieht.
Vor- und Nachteile
Vorteile
- Die Schema-Konfiguration ersparte handgeschriebene Selektoren, sodass auch ohne technischen Hintergrund ein laufender Scraper entstand.
- Eine einzige Gruppe deckte viele ähnliche Websites ab, was das Skalieren über Shops oder Verzeichnisse verbilligte.
- Geplantes Scraping und entdoppelte Ausgaben passten in echte Pipelines statt in einmalige Crawls.
- API-Exporte und Cookie-Handling erlaubten Arbeit auf zugangsbeschränkten Seiten und in bestehenden Abläufen.
- Die kostenlose Stufe ließ die Ausgabequalität vor dem Bezahlen prüfen.
Nachteile
- Das Produkt ist eingestellt. Reworkd schloss die Plattform am 6. Februar 2025, sie taugt also nicht für neue Arbeit.
- Die Migration liegt bei Ihnen. Reworkd verwies zum Ausstieg auf einen Support-Kontakt, bestehende Pipelines brauchten also eine Ersatzlösung.
- Der Preis wurde zusätzlich zum Abo gemessen, die Ausgaben stiegen also mit Volumen und Seitenzahl, statt stabil zu bleiben.
- Der LLM-Ansatz eignet sich für breite Extraktion, doch Sonderfälle brauchten weiter Prüfung, weil automatisiertes Scraping auf ungewöhnlichen Layouts rauschende Ergebnisse liefern kann.
Häufige Fragen
Reworkd AI erstellte und betrieb Web-Scraper mit großen Sprachmodellen. Sie definierten ein Schema der gewünschten Felder, fügten Quell-URLs hinzu, und die Plattform sammelte strukturierte Daten über die ganze Website und ihre Unterseiten. Teams nutzten es, um Produktkataloge, Bewertungen und andere Datensätze in großem Stil zusammenzustellen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Reworkd AI.
Alternativen zu Reworkd AI

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

GitGlow
GitGlow · Coding · ProduktivitätGitGlow ist ein Git-Client für den Desktop, der Ihren Code und die Änderungen Ihrer KI-Agenten in einer Review bündelt, damit Sie vor dem Ausliefern sehen, was die Maschine verlässt.