
RLAMA
Dontizi · Coding · Produktivität
RLAMA ist ein kostenloses Open-Source-Kommandozeilentool, das private RAG-Systeme über Ihre eigenen Dokumente baut, mit lokalen Ollama-Modellen, damit nichts Ihren Rechner verlässt.
Über RLAMA
What Is RLAMA
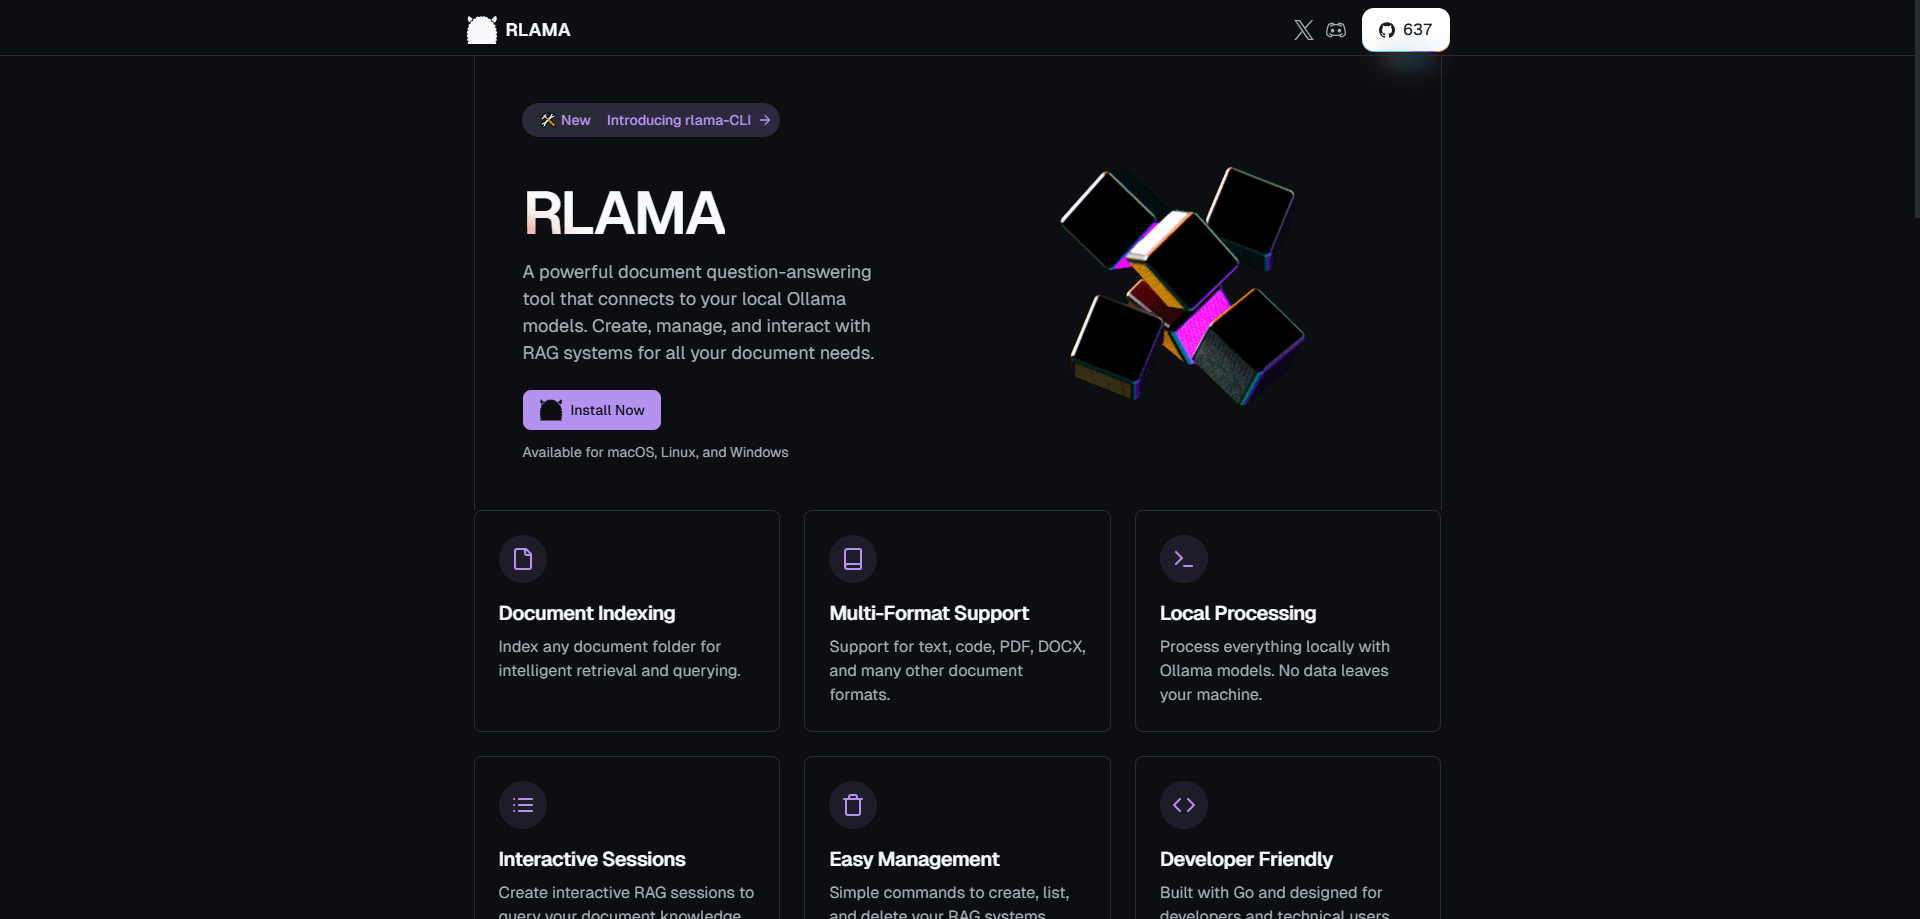
RLAMA ist ein Frage-Antwort-Tool für Ihre eigenen Dokumente, gebaut, um komplett auf Ihrem Computer zu laufen. Es ist ein lokales RAG-Tool für die Kommandozeile, das sich auf Ollama stützt, die Anwendung, die Sprachmodelle offline ausführt, und aus einem Ordner voller Dateien eine durchsuchbare Wissensbasis macht. Der Entwickler veröffentlicht es unter der Apache-2.0-Lizenz, der Code ist also offen und kostenlos nutzbar.
Das Prinzip ist einfach. Sie zeigen auf einen Ordner, RLAMA liest die Dateien, zerlegt sie in Abschnitte und speichert die Vektoren jedes Abschnitts auf Ihrer Festplatte. Stellen Sie eine Frage, findet das Tool die passenden Passagen, übergibt sie an Ihr lokales Modell, und das Modell antwortet mit Ihren Unterlagen als Kontext. Dieses Verfahren heißt retrieval-augmentierte Generierung (RAG), und es hält die Antworten an echte Quellen gebunden, statt das Modell aus dem Gedächtnis raten zu lassen.
Der Haken liegt beim Einrichten. RLAMA ist eine CLI, keine App für einen Klick, Sie arbeiten also im Terminal und brauchen Ollama installiert und gestartet, bevor irgendetwas läuft. Eine gehostete Version gibt es auch nicht, und ein selbst gehostetes RAG ist genau der Sinn des Tools. Die Ergebnisse hängen vom gewählten Modell und der Qualität Ihrer Dokumente ab, und schwache Hardware oder ein kleines Modell zeigen sich in den Antworten. Das Projekt pausiert zudem gerade, neue Funktionen kommen derzeit nicht dazu.
Getting Started
- Installieren Sie Ollama von ollama.ai und laden Sie mindestens ein Modell, etwa mit ollama pull llama3.
- Installieren Sie RLAMA mit dem Einzeiler: curl -fsSL https://raw.githubusercontent.com/dontizi/rlama/main/install.sh | sh.
- Erstellen Sie ein RAG-System mit Verweis auf einen Ordner: rlama rag llama3 meine-docs ./docs.
- Starten Sie eine interaktive Sitzung und stellen Sie Fragen: rlama run meine-docs.
- Fügen Sie später Dateien mit rlama add-docs hinzu, oder aktivieren Sie die Ordnerüberwachung, damit sie von selbst in den Index wandern.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von RLAMA.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler, die lokale Dokumentensuche wollen
- Teams mit Fokus auf Datenschutz
- Nutzer, die Ollama schon einsetzen
- Neugierige, die verstehen wollen, wie RAG funktioniert
Aufgaben
- Fragen zu einem Doku-Ordner stellen
- Eine Codebasis durchsuchen
- Eine Wissensbasis aus einer Website bauen
- Die Basis aktuell halten
- RAG in ein anderes Werkzeug einbinden
Szenarien
- Eine Freiberuflerin mit Kundenverträgen, die sie nirgends hochladen darf
- Ein Entwickler, der in einem großen Repository sucht
- Ein Forscher mit einem Stapel PDFs
- Ein Hobbyist, der kleine Modelle testet
Wichtigste Funktionen
Lokale RAG-Pipeline
Mit dem Befehl rag indexieren Sie einen Ordner, mit run fragen Sie ihn ab, und die lokalen Dateien in ~/.rlama sichern alles. Dokumente werden gelesen, aufgeteilt, über Ollama in Embeddings umgewandelt und auf der Festplatte gespeichert. Nichts berührt einen externen Server, und genau das ist der Zweck des Tools.
Mehrere Aufteilungsstrategien
RLAMA zerlegt Dokumente auf vier Wegen: feste Größe, semantisch, hierarchisch und hybrid. Der Hybridmodus wählt je Dateityp die beste Methode und teilt Markdown nach Überschriften, Code nach Funktionen und Klassen und reinen Text nach Absätzen. Bessere Abschnitte bedeuten bessere Treffer, und hier bleiben viele RAG-Tools im Grundmodus stecken.
Website-Crawling und Monitoring
Der Befehl crawl-rag baut ein RAG aus einer Website statt aus einem Ordner, mit Reglern für Tiefe, Parallelität und ausgeschlossene Pfade. Web-watch beobachtet die Seite und nimmt neue Seiten in den Index auf, eine Doku-Seite bleibt so ohne manuelles Neuindexieren aktuell.
Ordnerüberwachung
Sie können ein RAG auf einen Ordner richten und RLAMA ihn in einem Intervall prüfen lassen, oder nur dann, wenn das RAG genutzt wird. Neue Dateien landen von selbst im Index, was den Schritt spart, nach jeder Änderung add-docs laufen zu lassen.
Eingebauter API-Server
Der Befehl api startet einen HTTP-Server, und ein einzelner Endpunkt POST /rag nimmt den RAG-Namen, einen Prompt und eine optionale Kontextgröße an. So hängen Sie lokale Dokumentfragen in ein Skript, eine kleine App oder ein Werkzeug, das die CLI nicht spricht.
Ollama- und Hugging-Face-Modelle
RLAMA stützt sich für Embeddings und Generierung auf Ollama und akzeptiert jedes Modell, das Ollama ausführen kann. Die Befehle hf-browse und run-hf reichen in den GGUF-Katalog von Hugging Face, damit Sie ein Modell suchen und testen, bevor es in ein RAG-System kommt.
Vor- und Nachteile
Vorteile
- Läuft völlig offline, Dokumente verlassen also Ihren Rechner nicht, und es gibt keine Kosten pro Abfrage.
- Kostenlos und Open Source unter Apache 2.0, mit einer einzigen Go-Binary, die sich in einer Zeile installieren lässt.
- Vier Aufteilungsstrategien und ein Website-Crawler gehen weiter als die meisten lokalen RAG-Lösungen.
- Der eingebaute API-Server macht aus der CLI etwas, das andere Werkzeuge aufrufen können.
- Läuft auf Linux, macOS und Windows ohne Cloud-Abhängigkeit.
Nachteile
- Es ist nur eine CLI, wer eine Desktop-App erwartet, muss vom Terminal aus arbeiten.
- Die Einrichtung verlangt laufendes Ollama und geladene Modelle im Voraus, und dieser Schritt bremst Einsteiger.
- Die Antwortqualität folgt dem gewählten Modell, ein kleines Modell auf schwacher Hardware liefert also flache Ergebnisse.
- Die Entwicklung pausiert, das heißt derzeit keine neuen Funktionen und langsamere Korrekturen.
Häufige Fragen
RLAMA baut ein privates Frage-Antwort-System über Ihre eigenen Dateien. Sie indexieren einen Ordner oder eine Website, stellen dann Fragen und erhalten Antworten aus diesem Material, alles mit lokalen Ollama-Modellen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu RLAMA.
Alternativen zu RLAMA

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

GitGlow
GitGlow · Coding · ProduktivitätGitGlow ist ein Git-Client für den Desktop, der Ihren Code und die Änderungen Ihrer KI-Agenten in einer Review bündelt, damit Sie vor dem Ausliefern sehen, was die Maschine verlässt.