
sync-3
sync. labs (Synchronicity Labs Inc.) · Video
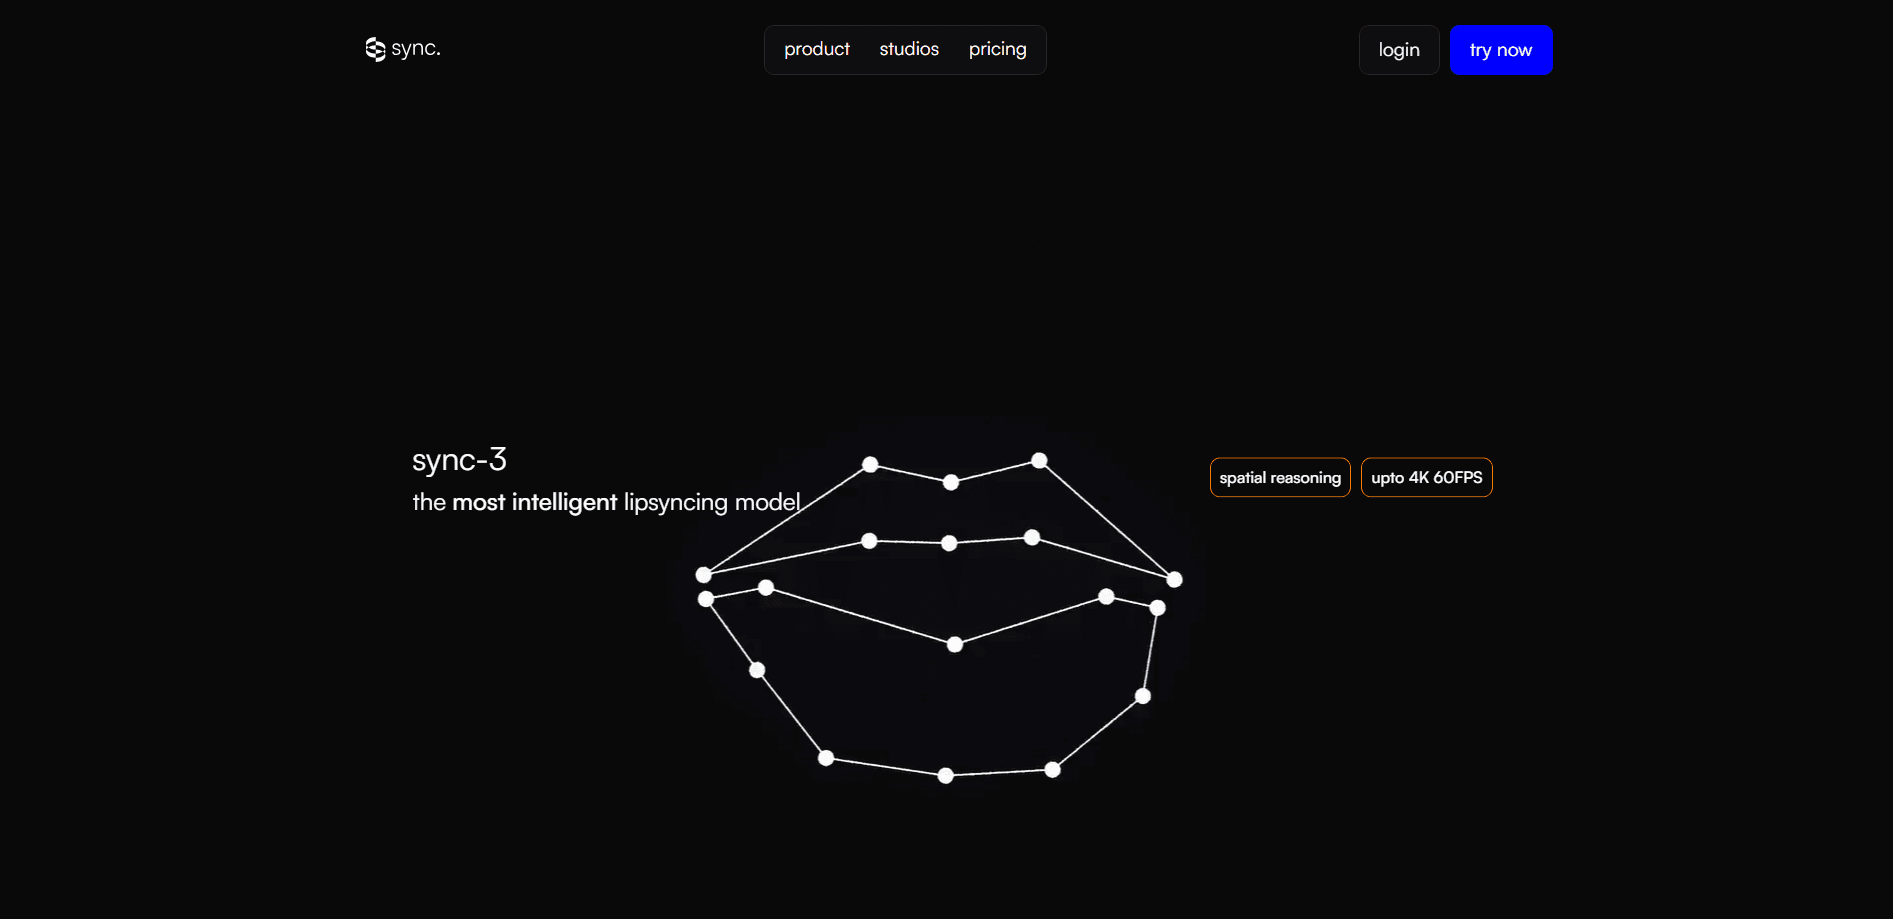
sync-3 ist ein KI-Lipsync-Modell von sync. labs, das die Mundbewegung neu zeichnet, damit jedes Video zu jeder Audiospur passt. Es baut einen breiten räumlichen Kontext um eine Szene auf und meistert so scharfe Seitenwinkel, mehrere Sprecher und schwaches Licht, Fälle, die ältere Tools zum Scheitern brachten. Die Ausgabe läuft bis zu 4K bei 60FPS, und du erreichst sie über eine einzige API, ein Web-Studio oder Schnitt-Plugins.
Über sync-3
Was ist sync-3
sync-3 ist ein Lipsync-Modell für visuelles Dubbing. Du gibst ihm ein Video und eine Audiospur, und es schreibt den Mund des Sprechers neu, damit die Performance zur neuen Stimme passt. Das ist wichtig für alle, die Inhalte übersetzen: Statt einer flachen Voiceover-Spur bewegt sich das Gesicht des Darstellers tatsächlich mit den Worten.
Das Modell baut eine breite räumliche Karte jeder Einstellung auf, bevor es den Mund berührt. Darin liegt der Unterschied zu früheren Lipsync-Tools. Statt nur die Lippen zu verfolgen, liest es das ganze Bild. Scharfe Seitenprofile, teilweise sichtbare Gesichter und mehrere Sprecher in einer Einstellung sind keine automatischen Fehlerfälle mehr. Laut sync. labs verarbeitet sync-3 die ganze Einstellung auf einmal und bringt eine eingebaute Hinderniserkennung mit, sodass eine Hand oder ein Mikrofon vor dem Mund eine Aufnahme nicht mehr ruiniert.
Der Haken sind Kosten und Menge. sync-3 ist das teuerste Modell der Familie, mit Preisen von 0,107 $ bis 0,133 $ pro Videosekunde bei 25fps je nach Tarif, und es ist eine Premium-Stufe, kein kostenloser Standard. Wenn du viel Material mit knappem Budget erzeugst, passt das günstigere Modell lipsync-2 für einfache Frontaleinstellungen besser.
Erste Schritte
- Erstelle ein Konto bei sync.so und wähle einen Tarif, oder starte mit der kostenlosen Stufe, um kurze Clips zu testen.
- Lade dein Ausgangsvideo und die Audiospur hoch, die der Sprecher treffen soll.
- Wähle sync-3 als Modell für den Job, da niedrigere Stufen standardmäßig andere Modelle nutzen.
- Erzeuge den Clip und lade dann das Ergebnis herunter oder hole es aus deinem Job-Verlauf.
- Für wiederkehrende Arbeit binde denselben Ablauf mit der REST-API in deine eigene App ein.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von sync-3.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Schnitt-Profis, die Filme oder Serien in andere Sprachen dubben
- Content-Teams, die Social-Videos lokalisieren
- Entwickler, die Dubbing-Funktionen in eine App bauen
Aufgaben
- Einen Film oder einen Podcast-Ausschnitt visuell dubben
- Münder in schwierigem Material korrigieren
- Eine Inhaltsbibliothek im Stapel verarbeiten
Szenarien
- Einen YouTube-Kanal in mehrere Sprachen übersetzen, ohne neu zu drehen
- Spiele und Animationen, bei denen Figuren nicht zu einer sauberen Frontalreferenz passen
- Eine Studio-Pipeline, die bereits in Premiere oder ComfyUI schneidet
Wichtigste Funktionen
Räumliches Denken über die ganze Einstellung
sync-3 liest das ganze Bild, statt nur die Lippen zu isolieren. Es erfasst, wo der Kopf sitzt, wohin er gedreht ist und was vor dem Gesicht liegt, und plant die Mundbewegung dann gegen diesen Kontext. Deshalb brechen extreme Winkelwechsel und teils verdeckte Gesichter nicht zusammen wie bei älteren Lipsync-Tools. Einfache Idee, großer Effekt.
Ausgabe bis 4K bei 60FPS
Das Modell erzeugt natives 4K-Video bei 60 Bildern pro Sekunde. Wer ein Projekt für einen großen Bildschirm oder eine Plattform mit hoher Bildrate fertigstellt, bekommt synchronisiertes Material, das ohne separaten Upscale-Durchgang hält. Keine Unschärfe, keine weichen Kanten. Niedrigere Modelle bleiben weit darunter, deshalb ist detailreiche Arbeit der Punkt, an dem sync-3 seinen Preis verdient.
Hinderniserkennung
Hände, Mikrofone und andere Objekte kreuzen ständig Gesichter. sync-3 erkennt Hindernisse und hält den Mund glaubhaft, auch wenn ein Teil mitten im Satz verdeckt ist. Weniger ruinierte Takes bedeuten weniger manuelle Nacharbeit und weniger Zeit für erneute Jobs.
Mehrere Sprecher und schwieriges Licht
Gruppenszenen, Podcasts mit mehreren Personen und dunkle oder gegenlichtige Räume werden in einem Durchgang bewältigt. Das Modell unterscheidet Sprecher und hält jeden Mund an die richtige Stimme gebunden. Das spart einen üblichen Schritt, bei dem du den Clip erst in Einzelsprecher-Stücke schneiden musstest. Weniger Vorbereitung.
Eine Lipsync-API für jedes Video
Eine einzige REST-API deckt Filme, Podcasts, Spiele und Animationen ab. Du sendest ein Video plus eine Audiospur und bekommst ein synchronisiertes Ergebnis zurück, mit SDKs und Partner-Integrationen wie Text-to-Speech und Dubbing in 29 Sprachen. Es ist eine Lipsync-API, die bei jedem Quellentyp gleich funktioniert. Für Entwickler ist das der kürzeste Weg von einer Idee zu einer funktionierenden Funktion.
Zugang über Studio und Plugin
Du musst keinen Code anfassen. sync-3 läuft im sync. Web-Studio, und es gibt offizielle Plugins für Adobe Premiere und einen ComfyUI-Knoten. Schnitt-Profis behalten ihre bestehende Pipeline; das Modell fügt sich dort ein, wo sie schon arbeiten. Gut, wenn du keine Oberfläche bauen willst.
Vor- und Nachteile
Vorteile
- Meistert schwierige Fälle, die frühere Lipsync-Modelle brechen, darunter scharfe Seitenwinkel und mehrere Sprecher in einer Einstellung
- Liefert bis zu 4K bei 60FPS, sodass synchronisiertes Material in hochauflösende Projekte mit hoher Bildrate passt
- Ohne Code nutzbar über das Web-Studio, das Premiere-Plugin und den ComfyUI-Knoten
- Eine API umfasst Filme, Podcasts, Spiele und Animationen, mit Dubbing in 29 Sprachen und TTS-Integrationen
- Die Batch-API in höheren Tarifen lässt Teams große Bibliotheken in einem Aufruf verarbeiten
Nachteile
- Das teuerste Modell der Familie, ab 0,107 $/s bei 25fps, sodass lange Videos schnell teuer werden
- Für Clips über einer Minute brauchst du einen bezahlten Tarif, und der Zugang zu sync-3 liegt auf den oberen Stufen
- Kein Google Play und keine eigenständige Mobile-App, also können reine Mobile-Creator es nicht auf dem Handy nutzen
- Die Qualität hängt weiter von sauberem Input ab; stark komprimiertes oder schlecht beleuchtetes Quellmaterial kann begrenzen, wie gut das Ergebnis aussieht
Häufige Fragen
Es ist ein KI-Lipsync-Modell für visuelles Dubbing. Du gibst ihm ein Video und eine Audiospur, und es zeichnet den Mund des Sprechers neu, damit das Gesicht zur neuen Stimme passt. Der übliche Einsatz ist, Inhalte zu übersetzen und dabei das Schauspiel des Originaldarstellers zu erhalten. Denk an ein Video mit Lippensynchronisation, das einen Sprachwechsel übersteht.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu sync-3.
Alternativen zu sync-3

ngram 2.0
ngram · Video · Marketingngram 2.0 ist ein KI-Videogenerator für Teams. Aus einem Prompt, einer Bildschirmaufnahme oder einer Produkt-URL entsteht ein Erklärvideo, eine Demo oder ein KI-Avatar-Video, und jede Szene bleibt bearbeitbar.

OpenScreen 2
OpenScreen (open-source project) · Video · ProduktivitätOpenScreen 2 ist ein kostenloser Open-Source-Bildschirmrecorder und Demo-Editor für Windows, macOS und Linux, mit automatischem Zoom, gestalteten Rahmen, lokalen Untertiteln und Schnitt per Agent.

Skreno
Skreno · Video · ProduktivitätSkreno ist ein Bildschirmrecorder im Browser: Er nimmt einen Tab, ein Fenster oder den ganzen Bildschirm auf und hängt KI-Transkripte, Zusammenfassungen und Konsolen-Logs an einen einzigen Link.