
Vectorize
Vectorize · Coding · Lernen
Vectorize ist eine verwaltete RAG-Plattform, die unstrukturierte Daten aus Dokumenten, SaaS-Anwendungen und Wissensdatenbanken in Ihre eigene Vektordatenbank bringt und diesen Index aktuell hält.
Über Vectorize
What Is Vectorize
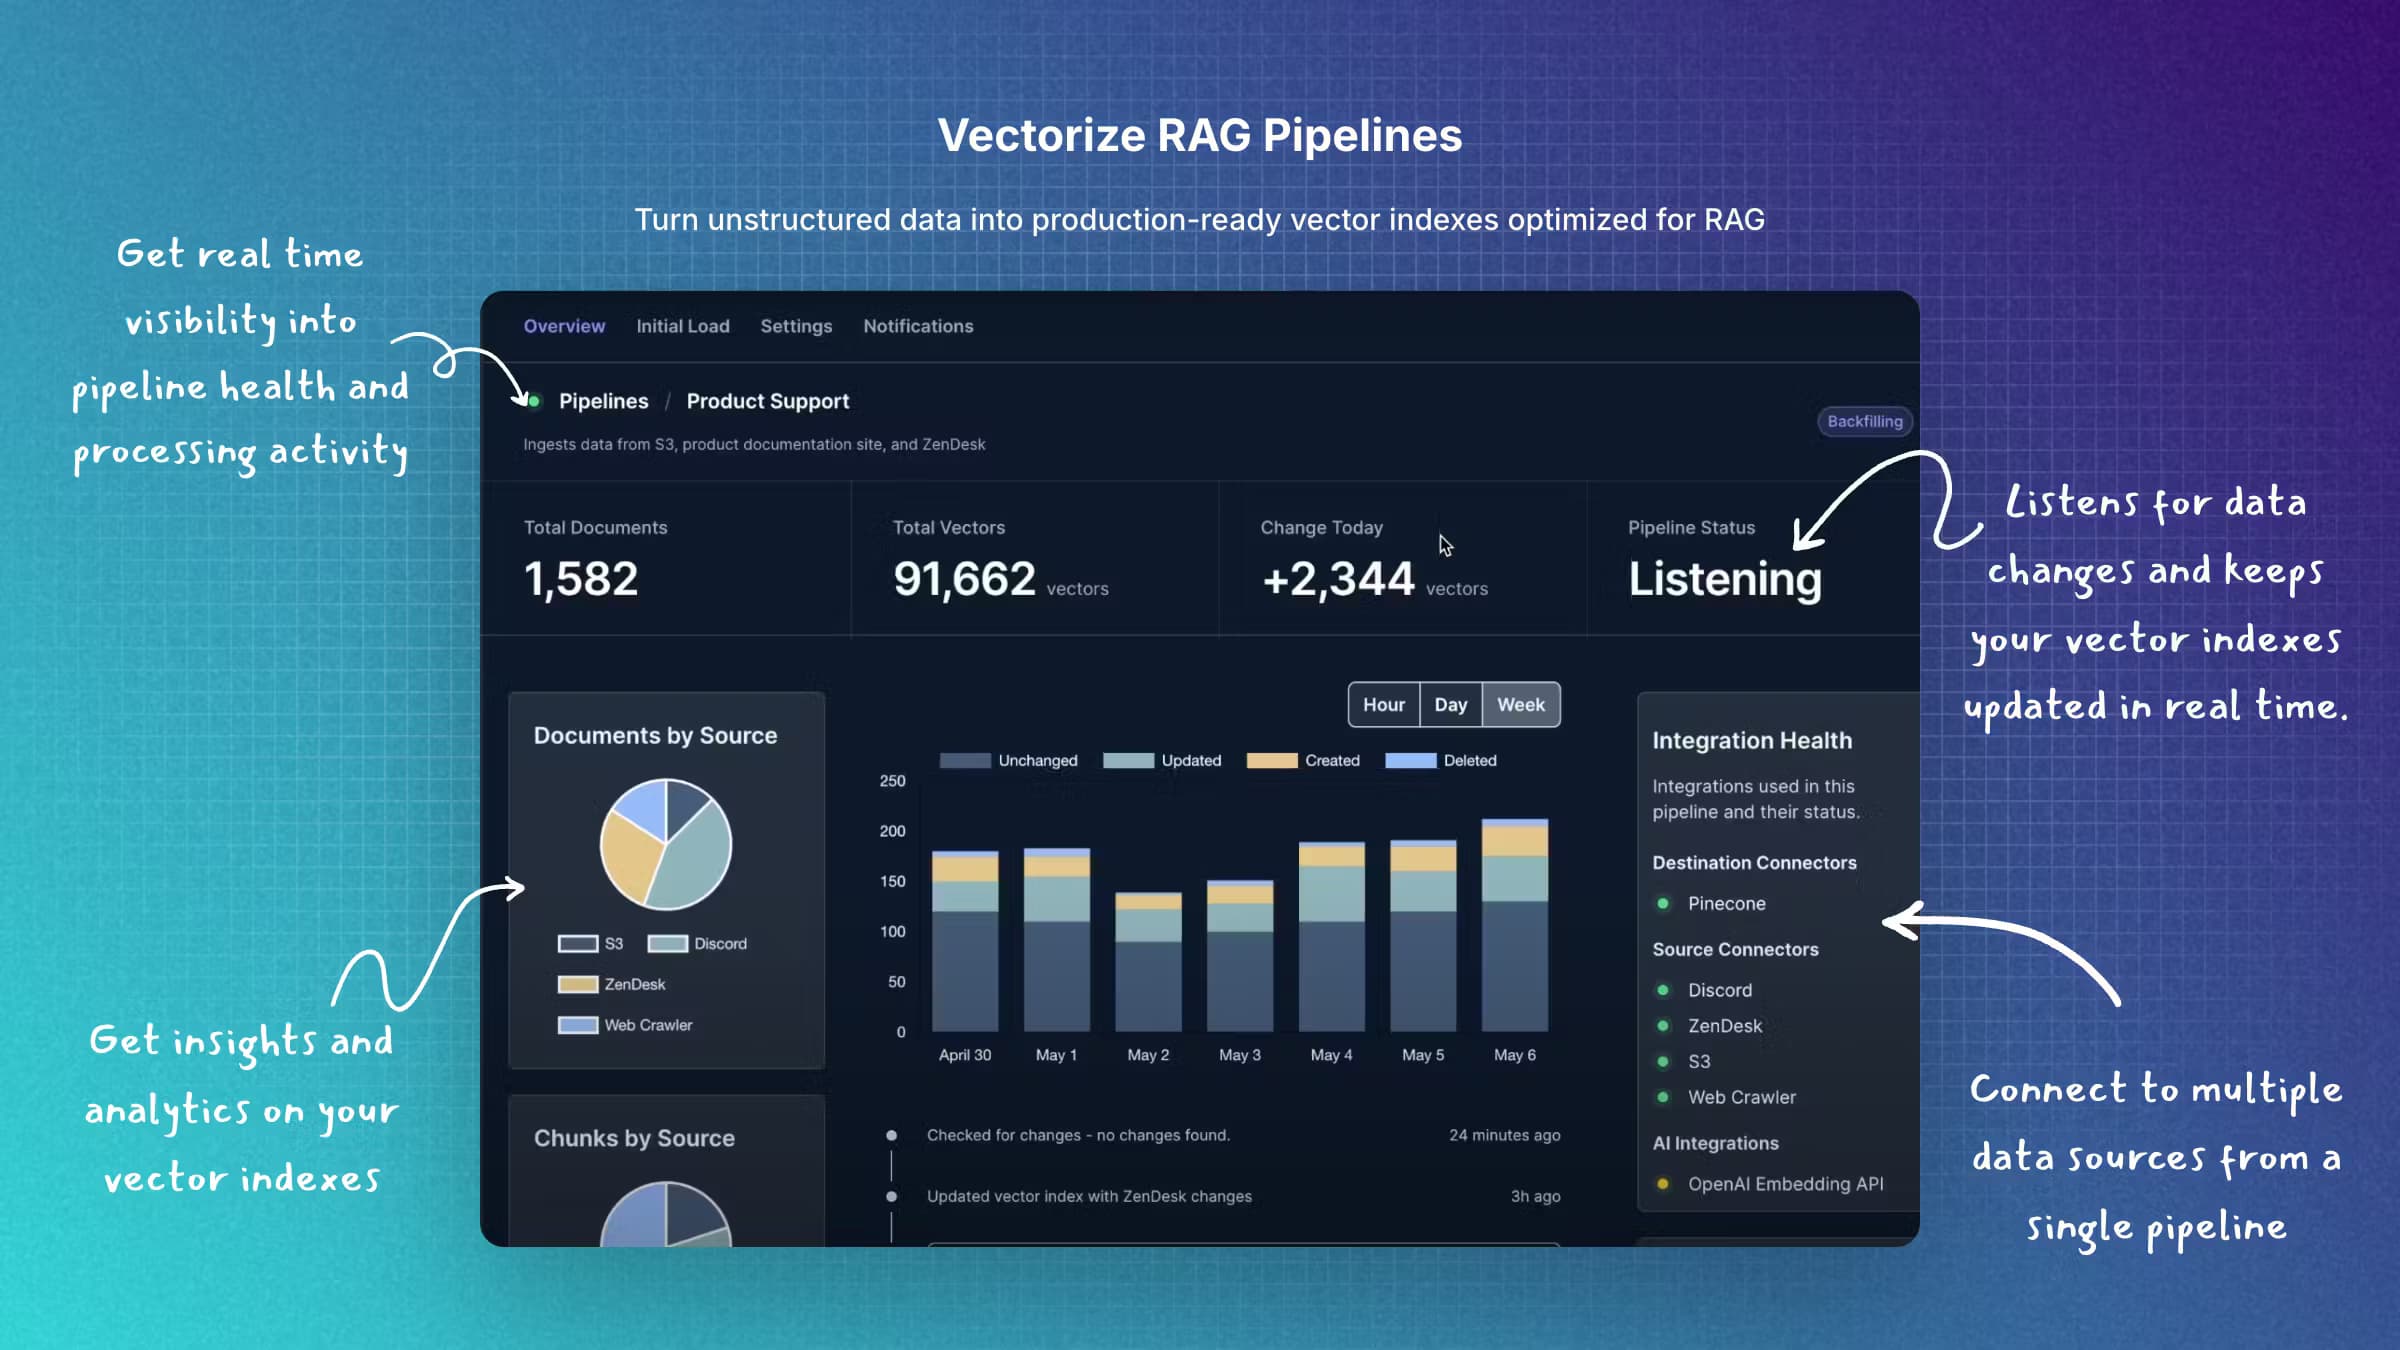
Vectorize ist eine gehostete Plattform zum Bauen von Pipelines für retrieval-augmentierte Generierung, kurz RAG. Im Kern steht eine Echtzeit-RAG-Pipeline, bei der sich der Index ändert, sobald sich die Quelldaten ändern. Sie verbindet sich mit Daten, die Sie ohnehin haben, Dateien, Cloud-Laufwerke, Chat-Verläufe, Support-Tickets und Website-Inhalte, wandelt diese Inhalte in Embeddings um und schreibt sie in eine Vektordatenbank, die Sie steuern. Der Sinn dahinter: ein Sprachmodell bekommt privaten, frischen Kontext, auf dem es nie trainiert wurde.
Das Problem, das die Plattform angeht, ist verstreutes oder veraltetes Wissen. Baut man dieselbe Pipeline von Hand, verdrahtet man mehrere Dienste, einen zum Extrahieren des Textes, einen zum Aufteilen und Einbetten, einen zum Speichern der Vektoren, dazu eigenen Code, der alles synchron hält. Vectorize fasst diese Schritte hinter einer Oberfläche zusammen und lässt jede Änderung in Ihren Quelldaten bis in den Index durchlaufen.
Die wichtigste Einschränkung ist der Umfang. Vectorize deckt die Abrufschicht ab, nicht die Modellschicht, Sie bringen also weiterhin Ihr eigenes LLM und Ihre Vektordatenbank mit. Auch setzt die Plattform auf vorkonfigurierte Konnektoren statt auf vollständig maßgeschneiderte Pipelines, eine ungewöhnliche Datenquelle kann daher zusätzlichen Aufwand bedeuten.
Getting Started
- Legen Sie ein Konto auf platform.vectorize.io an und richten Sie eine Organisation für Ihr Projekt ein.
- Verbinden Sie eine Datenquelle, etwa ein Cloud-Laufwerk, einen Datei-Upload oder eine SaaS-Wissensdatenbank, aus der Liste der fertigen Konnektoren.
- Wählen Sie eine Ziel-Vektordatenbank wie Pinecone, Qdrant oder PostgreSQL und ein Embedding-Modell von OpenAI, Voyage AI oder aus den eingebauten Optionen.
- Stellen Sie die Pipeline so ein, dass sie Änderungen laufend abgleicht, und starten Sie die Indexierung Ihrer Inhalte.
- Fragen Sie den Index über den Retrieval-Endpoint ab, der die Frage einbettet, eine k-ANN-Suche ausführt und sortierte Ergebnisse mit Relevanzwerten zurückgibt.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Vectorize.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Backend- und ML-Entwickler
- Junge Teams mit einem KI-Produkt
- Daten- und Plattformingenieure in größeren Firmen
Aufgaben
- Einen Support-Chatbot erden
- Einen Suchindex frisch halten
- Abrufqualität testen
Szenarien
- Teams mit schnell wechselnder Dokumentation
- Produkte mit vielen Datenquellen
- Regulierte Umgebungen
Wichtigste Funktionen
RAG-Pipeline-Builder
Der Pipeline-Builder ist das Herz des Werkzeugs. Sie wählen eine Quelle, eine Zieldatenbank und ein Embedding-Modell, und Vectorize baut für Sie die Schritte Extraktion, Aufteilung, Embedding und Speicherung zusammen. Man klickt und konfiguriert, statt Framework-Code zu schreiben, was den Weg von einer verbundenen Quelle zu einem abfragbaren Index verkürzt. Teams, die später das Modell wechseln wollen, tun das, ohne den ganzen Ablauf neu zu bauen.
Echtzeit-Vektorupdates
Fast jede RAG-Konfiguration veraltet in dem Moment, in dem sich ein Dokument ändert, weil die Indexierung nach festem Zeitplan läuft. Vectorize beobachtet Ihre verbundenen Quellen und schiebt Änderungen in den Vektorspeicher, sobald sie auftreten, eine neue Richtlinienseite oder ein gelöstes Ticket landen also kurz nach ihrem Erscheinen im Index. Antworten bleiben damit an das gebunden, was heute tatsächlich in Ihren Systemen steht.
Erweiterter Retrieval-Endpoint
Der Retrieval-Endpoint bündelt mehrere Schritte in einem Aufruf. Er vektorisiert die eingehende Anfrage, führt eine k-ANN-Suche über Ihren Index aus, schreibt die Anfrage optional anhand des Gesprächsverlaufs um und wendet ein eingebautes Reranking an. Die Ergebnisse kommen mit Relevanzwerten, Kosinus-Ähnlichkeit und Metadaten zurück, was hilft, wenn Sie Quellen anzeigen oder nach Dokumentattributen filtern müssen statt nur einen Textblock zu bekommen.
Vektordatenbank-Integrationen
Vectorize legt die Embeddings in einer Datenbank Ihrer Wahl ab, statt Daten in einen eigenen Speicher einzusperren. Fertige Konnektoren decken Pinecone, Qdrant, Weaviate, PostgreSQL, Elastic, Azure AI Search, Neo4j, Milvus und weitere ab. Sie behalten die Abfragewerkzeuge, Zugriffskontrollen und Sicherungen, auf die Sie sich verlassen, und können die Daten verschieben oder gemischte Lasten auf demselben Speicher fahren.
Quell-Konnektoren
Die Konnektorliste reicht dorthin, wo echte Inhalte liegen: Cloud-Speicher wie Amazon S3 und Google Cloud Storage, Produktivitäts-Apps wie Google Drive und Dropbox, Gesprächswerkzeuge wie Discord und Plattformen wie Confluence, GitHub und Intercom. Direkt von dort zu importieren erspart es, alles erst in einen Zwischenordner zu exportieren, was sowohl Einrichtungsaufwand als auch Abweichungen verringert.
Wahl des Embedding-Modells
Sie sind nicht an einen Embedding-Anbieter gebunden. Die Plattform unterstützt Modelle von OpenAI, Voyage AI, Amazon Bedrock, Vertex AI und weiteren KI-Plattformen, sodass Sie Kosten gegen Abrufqualität abwägen und je Pipeline wählen können. Ein späterer Anbieterwechsel ist eine Konfigurationsänderung und kein Neuschreiben, was hilft, wenn ein besseres oder günstigeres Modell auftaucht.
Bildverarbeitung mit Iris
Vectorize Iris bewältigt komplexe PDFs, an denen einfache Textextraktion scheitert, etwa gescannte Seiten, dichte Tabellen und Layouts, bei denen die Bedeutung von der Struktur abhängt. Es liest das visuelle Layout, damit die eingebetteten Abschnitte die Tabellen- und Seitenbezüge behalten, die für genaue Treffer wichtig sind, genau dort, wo einfache Parser oft scheitern.
Vor- und Nachteile
Vorteile
- Behält Ihre Vektoren in einer Datenbank, die Sie steuern, bestehende Zugriffsregeln und Sicherungen gelten also weiter.
- Der Echtzeit-Abgleich verringert die manuelle Neuindexierung, von der veraltete RAG-Konfigurationen abhängen.
- Fertige Konnektoren für gängige Speicher-, SaaS- und Wissensquellen verkürzen die Einrichtung.
- Der Retrieval-Endpoint bündelt Abfrage-Umschreibung und Reranking, Sie schreiben also weniger Verbindungscode.
- Ein kostenloser Tarif existiert für einzelne Entwickler und Nebenprojekte.
Nachteile
- Sie brauchen weiterhin Ihr eigenes LLM und Ihre Vektordatenbank, es ist also kein vollständiger Anwendungsstapel.
- Ungewöhnliche oder hausinterne Datenquellen können Arbeit außerhalb der fertigen Konnektoren erfordern.
- Der Preis richtet sich nach verarbeiteten Seiten, große Dokumentmengen treiben die Kosten also schnell hoch.
- Der Pipeline-Builder läuft über die Oberfläche, Teams, die code-orientierte Werkzeuge bevorzugen, finden ihn womöglich begrenzt.
Häufige Fragen
Vectorize baut und betreibt RAG-Pipelines, die einem Sprachmodell privaten, aktuellen Kontext aus Ihren eigenen Daten geben. Sie verbinden Quellen, wählen eine Vektordatenbank und fragen den Index über einen Retrieval-Endpoint ab.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Vectorize.
Alternativen zu Vectorize

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

GitGlow
GitGlow · Coding · ProduktivitätGitGlow ist ein Git-Client für den Desktop, der Ihren Code und die Änderungen Ihrer KI-Agenten in einer Review bündelt, damit Sie vor dem Ausliefern sehen, was die Maschine verlässt.