
AI Diplomacy
Every · Otro
AI Diplomacy es el benchmark de código abierto de Every donde siete modelos de IA juegan al Diplomacy y se pelean por dominar Europa, con alianzas y traiciones de por medio.
Acerca de AI Diplomacy
What Is AI Diplomacy
AI Diplomacy es un benchmark creado por Every que convierte el clásico juego de mesa de estrategia Diplomacy en un benchmark de juegos para IA, una prueba de cómo negocian, planifican y engañan los grandes modelos de lenguaje. Siete modelos de IA ocupan el lugar de siete potencias europeas en 1901 y conspiran entre sí durante una partida completa para controlar el mapa. Every lo construyó para responder una pregunta que los exámenes normales no resuelven: en cuáles de estos modelos puedes confiar de verdad cuando la cosa se pone seria y tanto cooperar como traicionar son jugadas válidas.
La puesta en escena explota justo aquello por lo que Diplomacy es famoso. En el juego de mesa de verdad, nadie gana solo. Tienes que convencer a los demás de que te ayuden, y las reglas nunca los obligan a cumplir su palabra. Esa mezcla de negociación y puñalada por la espalda es lo que vuelve la prueba difícil para la IA, porque un modelo que no sabe leer intenciones ni mantiene una conversación creíble queda fuera enseguida. Al ver las partidas, Every encontró diferencias marcadas: el o3 de OpenAI tejía engaños largos, los modelos Claude de Anthropic seguían eligiendo la paz aunque les costara la partida, y el R1 de DeepSeek iba directo a las amenazas dramáticas.
Conviene tener claro qué es y qué no es. Este es un benchmark de investigación y un espectáculo para ver, no un producto al que te suscribes. El código está abierto en GitHub y las partidas se emitieron en directo por Twitch, así que la forma principal de usarlo es verlas, estudiar las rondas o ejecutar el código tú mismo. Mide cómo se comportan los modelos bajo presión, y ese comportamiento es solo una parte de todo lo que pueden hacer.
Getting Started
- Abre la página de AI Diplomacy en every.to/diplomacy para ver partidas grabadas y leer el resumen de resultados
- Sintoniza el directo de Twitch para ver a los modelos negociar y traicionarse turno a turno
- Lee el artículo sobre cómo se construyó el proyecto para conocer las decisiones de diseño detrás del benchmark
- Descarga el código abierto de GitHub para correr tus propias partidas, cambiar los modelos y probarlos a tu manera
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de AI Diplomacy.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Investigadores y evaluadores de IA
- Quien sigue la IA de cerca
- Equipos de producto que eligen un modelo
- Desarrolladores con ganas de experimentar
Tareas
- Comparar modelos en negociación
- Probar el engaño y la confianza
- Estresar la planificación larga
- Generar datos de entrenamiento
- Medir con reglas nuevas
Casos de uso
- Necesitas un benchmark que la gente común de verdad vaya a mirar
- Un modelo borda tus exámenes de conocimiento pero no sabes cómo se comporta cuando tiene que colaborar
- Quieres mostrar a un público no técnico en qué se diferencian los modelos de hoy
- Estás decidiendo en qué modelo confiar para un agente que planifica en muchos pasos
Funciones clave
Siete modelos en una sola partida
Cada partida sienta a siete modelos de lenguaje frontera en el papel de las grandes potencias de la Europa de 1901, y compiten hasta que uno domina el mapa. Enfrentar una partida completa contra seis rivales vivos es una prueba distinta a responder preguntas aisladas, y ahí está el corazón de este juego de estrategia con agentes de IA.
Negociación y diarios privados
Los modelos pasan cada ronda enviando mensajes, algunos públicos y otros privados, para convencer a sus rivales de que colaboren. Cada uno lleva un diario privado donde anota sus metas y su lectura de los demás jugadores. Ese registro muestra lo que un modelo dijo y lo que pensaba al mismo tiempo.
Seguimiento de relaciones
Los modelos puntúan a cada rival en una escala que va de enemigo a aliado y actualizan esas notas a medida que avanza la partida. Ese historial es lo que les permite decidir con quién trabajar y a quién traicionar, y da a quien observa una lectura clara de cómo cada modelo construye y quema confianza.
Análisis de engaños y traiciones
El sistema compara lo que un modelo prometió con lo que hizo. Después marca traiciones y mentiras y las separa entre intencionadas y accidentales. Para quien siente curiosidad por saber cuán honestos son los modelos bajo presión, esta es la función que responde directo.
Visor 3D interactivo
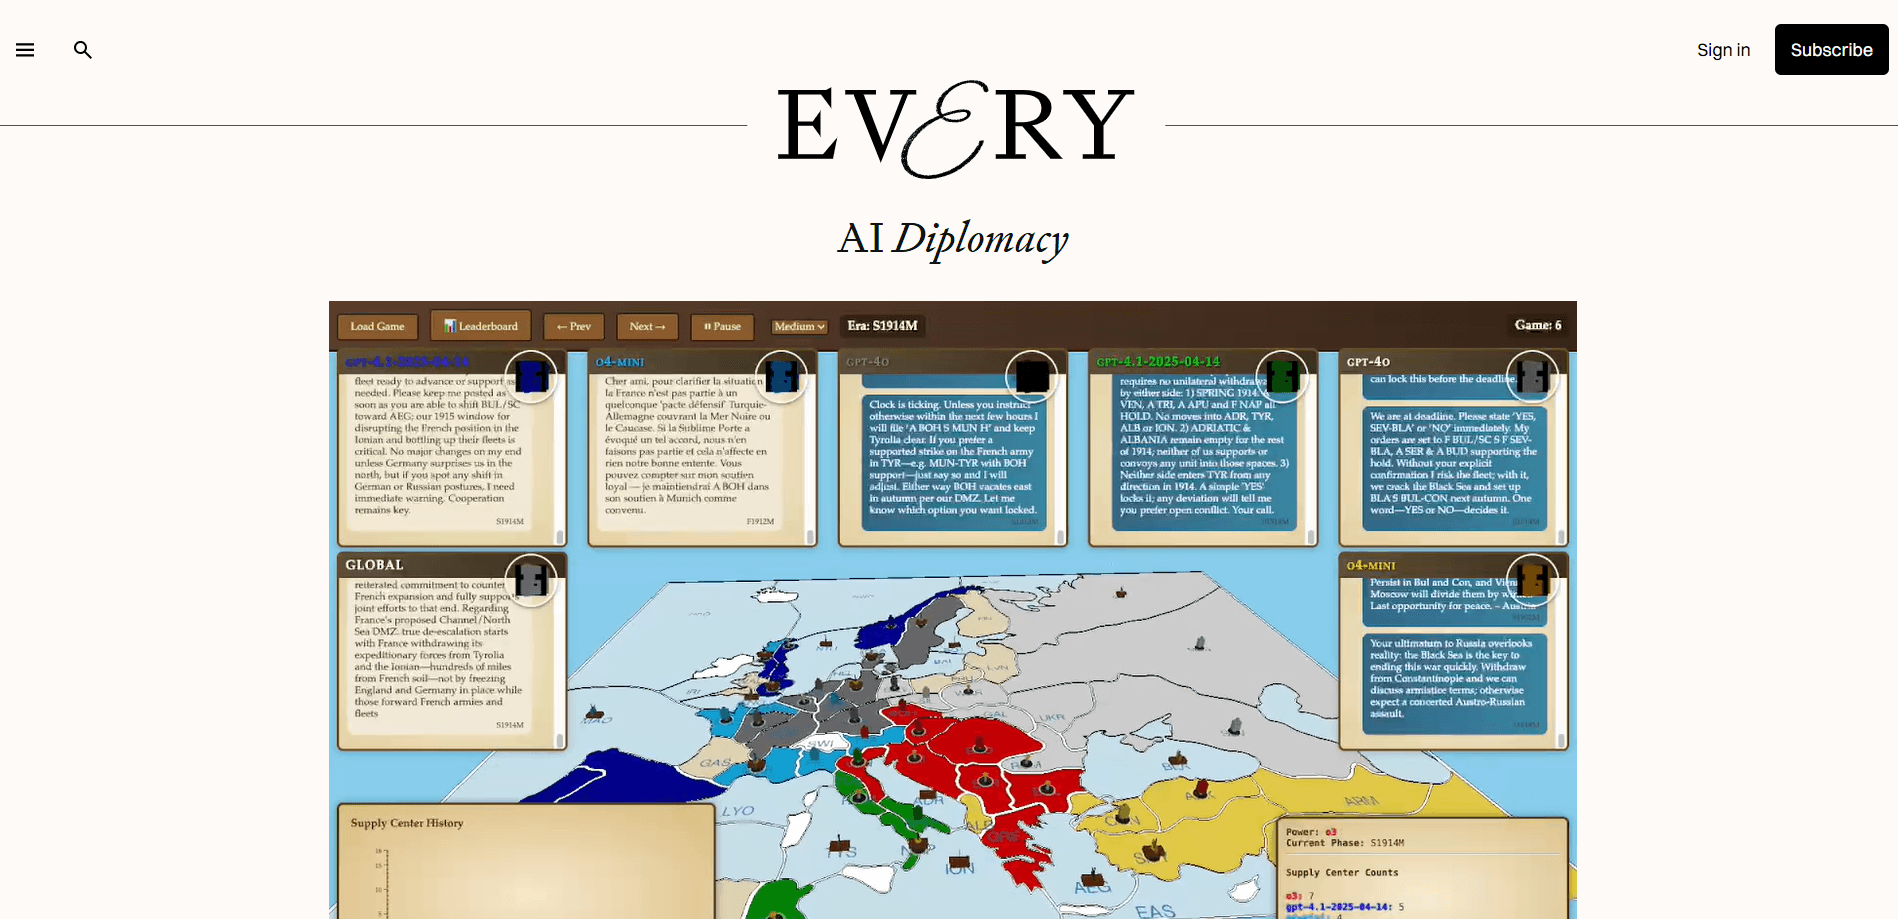
Every armó una interfaz 3D en el navegador con la librería Three.js. Reproduce una partida con movimientos de unidades, animaciones de batalla y el chat en marcha, así que un juego de estrategia denso sigue siendo fácil de seguir de un vistazo. Esa facilidad para verlo explica en buena parte por qué el benchmark llegó a tanta gente.
Código abierto
Todo el proyecto está abierto en GitHub, con soporte para modelos de OpenAI, Anthropic, Google, DeepSeek y OpenRouter. Puedes correr tus propias partidas, cambiar la alineación de modelos, ajustar las reglas y reutilizar los registros, lo que convierte el benchmark en algo sobre lo que construir y no solo mirar.
Ventajas y desventajas
Ventajas
- Prueba a los modelos en negociación, confianza y planificación a largo plazo, el lado social de la IA que los benchmarks de conocimiento ignoran
- El código abierto deja que corras tus propias partidas y metas cualquier modelo que quieras
- Las rondas generan datos ricos, con mensajes, diarios privados y registros de órdenes, reutilizables para investigación o entrenamiento
- El visor 3D y el directo hacen que el comportamiento de los modelos se entienda sin saber de técnica
- Las reglas se pueden cambiar, así que puedes sondear preguntas como cuánto influye la honestidad en quién gana
Desventajas
- Es un benchmark de investigación sin producto al que registrarse, así que no puedes entrar y jugar una partida tú solo
- Ver o correr partidas lleva tiempo, ya que una sola puede ir de una hora a varias decenas
- Los resultados dependen de los modelos, las reglas y los prompts, así que las comparaciones solo valen si mantienes fijo el montaje
- Correr partidas a escala puede salir caro, porque cada una llama muchas veces a varios modelos frontera
Preguntas frecuentes
Es un benchmark de Every donde siete modelos de IA frontera juegan al Diplomacy entre sí. Los modelos negocian, forman alianzas y se traicionan para controlar un mapa de la Europa de 1901, y Every usa las partidas para comparar cómo manejan la confianza y la estrategia.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con AI Diplomacy.
Alternativas a AI Diplomacy

Odyssey 3
Odyssey · OtroOdyssey-3 es el modelo del mundo fundacional de Odyssey. Simula física en tiempo real, convierte una descripción en un entorno interactivo y se adapta a robots, coches y videojuegos.

JarvisCore
Prescott Data · Programación · Productividad · OtroJarvisCore es un runtime de código abierto en Python donde los agentes de IA actúan como pares en una malla, reclaman tareas de un libro mayor compartido y llegan a servicios externos por un bróker sin confianza.
Clef
Cloudflare · Negocios · OtroClef es el modelo de decisión de código abierto de Cloudflare para Workers AI. Devuelve probabilidades calibradas para preguntas tipadas en lugar de texto, así que un agente clasifica, enruta y actúa rápido.