

Confident AI
Confident AI · Otro
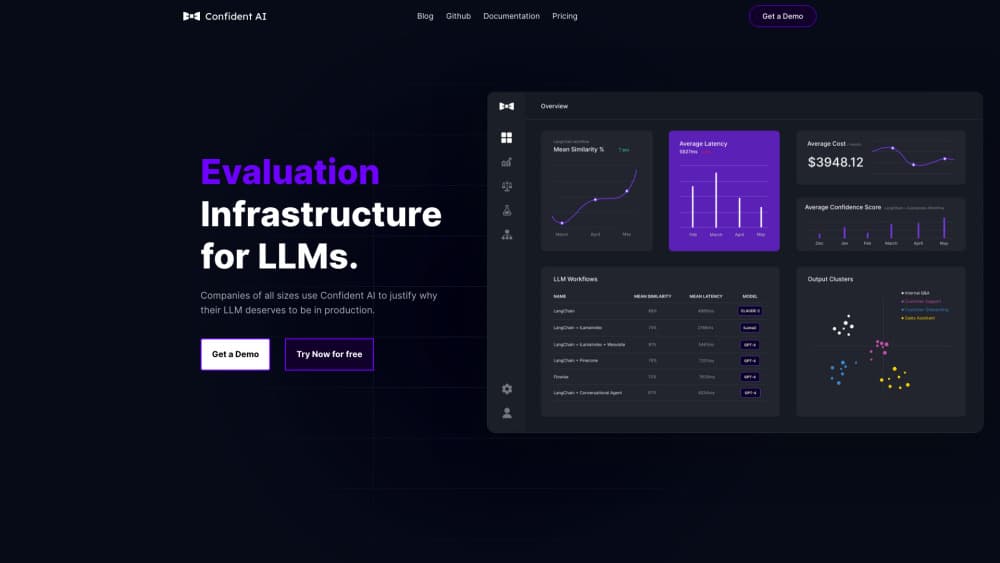
Confident AI es una plataforma de evaluación de LLM montada sobre el marco open source DeepEval. Sirve para probar una aplicación de IA antes de publicarla, puntuar sus respuestas con métricas respaldadas por investigación y vigilar el tráfico real después.
Acerca de Confident AI
About
Qué es Confident AI
Confident AI es una plataforma web para probar y monitorizar aplicaciones basadas en modelos de lenguaje. Resuelve la parte que más cuesta en los equipos: demostrar que un chatbot, un pipeline RAG o un agente sigue funcionando después de tocar un prompt o cambiar de modelo. Escribes los casos de prueba en Python o desde el navegador, los lanzas contra tu aplicación y obtienes una puntuación por métrica con una explicación escrita de cada resultado.
La empresa también mantiene DeepEval, el marco de evaluación open source que alimenta las métricas de la plataforma. Ese detalle importa. Puedes ejecutar las mismas comprobaciones en tu portátil con DeepEval y subir los resultados a Confident AI para que el equipo los revise; nada queda encerrado en la caja negra de un proveedor.
El límite más duro es el precio. La cuenta gratuita cubre un proyecto, dos usuarios y cinco ejecuciones por semana. El uso serio arranca en Starter, 200 dólares al mes. Para quien solo hace comprobaciones puntuales, es una factura difícil de justificar.
Cómo empezar
- Crea una cuenta gratuita en confident-ai.com y copia la clave de API desde los ajustes del proyecto.
- Instala el SDK con
pip install -U deepevaly ejecutadeepeval loginpara enlazar el marco local con tu proyecto en la nube. - Define métricas y casos de prueba en un archivo de Python, o créalos en el navegador con el flujo sin código si tienes un plan de pago.
- Lanza las pruebas, revisa las puntuaciones por métrica en el panel y comparte el enlace del informe con tu equipo.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Confident AI.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Ingenieros de IA que construyen pipelines RAG o agentes
- Product managers responsables de funciones de IA
- Equipos de QA que se pasan a las pruebas de LLM
Tareas
- Detectar alucinaciones antes de publicar
- Comparar dos configuraciones de modelo o de prompt
- Convertir fallos de producción en casos de prueba
- Hacer red teaming de un chatbot de cara al cliente
Casos de uso
- Una startup que cambia de modelo cada semana
- Una empresa que unifica criterios entre varios equipos de producto
- Un bot de soporte ya en producción
Funciones clave
Biblioteca de métricas con base académica
La plataforma incluye más de 50 métricas de evaluación de IA construidas sobre DeepEval, para casos de un turno y de varios. Hay relevancia de respuesta, fidelidad, precisión y recuperación de contexto, alucinación, sesgo, toxicidad y comprobaciones propias de agentes como el uso correcto de herramientas. Si nada estándar encaja, las métricas G-Eval personalizadas permiten describir el criterio en lenguaje natural.
Simulación de conversaciones multiturno
En lugar de juzgar una respuesta suelta, el simulador mantiene una conversación completa contra tu aplicación y puntúa el hilo entero. Así aparecen fallos que solo surgen tras varios intercambios, como un bot que olvida una restricción que aceptó antes. Defines la persona y el objetivo, y la plataforma genera los turnos.
Pruebas de regresión en CI/CD
Las pruebas de regresión de LLM se ejecutan dentro de GitHub Actions, GitLab CI, Jenkins o cualquier pipeline que pueda llamar a la API. Una métrica fallida puede bloquear un merge igual que una prueba unitaria rota. Cada ejecución queda guardada, así que puedes comparar versiones y ver el momento exacto en que bajó una nota.
Observabilidad de IA sobre tráfico real
El trazado registra cada petición, span e hilo de tu aplicación en producción y le adjunta las puntuaciones de las métricas. Puedes filtrar trazas por nota baja, detectar desviaciones con el tiempo y activar alertas por respuestas repetidas o señales de frustración del usuario. Los spans de OpenTelemetry se conservan si vienes de otra herramienta.
Anotación humana y alineación de métricas
Las colas de anotación dejan que expertos de dominio revisen salidas con tus propios criterios. Después la plataforma compara sus etiquetas con las puntuaciones y muestra dónde discrepan. Esa diferencia es la parte útil: indica si una métrica es demasiado benévola antes de confiar en ella para frenar un release.
Flujos sin código y acceso por MCP
En los planes de pago puedes apuntar las evaluaciones a un endpoint en vivo, remodelar la respuesta y programar ejecuciones recurrentes sin escribir código. Un servidor MCP permite además que los agentes de Cursor o Claude Code lancen evaluaciones y consulten resultados desde el propio editor.
Ventajas y desventajas
Ventajas
- DeepEval es open source, así que puedes correr las comprobaciones en local e inspeccionar el código de las métricas en vez de confiar en un motor de puntuación cerrado.
- Cada nota viene con su explicación, y eso hace que los fallos sean depurables por gente que no escribió la prueba.
- El trazado y la evaluación viven en el mismo sitio, de modo que los datos de producción se convierten en casos de prueba sin fricción.
- Las integraciones cubren el stack habitual: OpenAI, Claude, Gemini, Bedrock, LangChain, LlamaIndex, CrewAI y OpenTelemetry.
- Los controles empresariales incluyen SSO, RBAC personalizado, SOC 2, HIPAA y despliegue on premise.
Desventajas
- El plan gratuito limita a un proyecto, dos usuarios y cinco ejecuciones por semana, suficiente para probar el producto y poco más.
- El uso real en equipo empieza en 200 dólares al mes, una cifra difícil para desarrolladores solos o proyectos pequeños.
- La evaluación sin código, las evaluaciones en línea y las alertas son de pago, así que el nivel gratuito sigue dando por hecho que te manejas en Python.
- Las llamadas al modelo juez las pagas tú, y un conjunto de datos grande con un modelo potente dispara la factura.
Preguntas frecuentes
Prueba y monitoriza aplicaciones de LLM. Defines casos de prueba y métricas, las lanzas contra tu aplicación y recibes puntuaciones con explicación. La misma plataforma después vigila el tráfico real y puntúa las peticiones que llegan.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Confident AI.
Alternativas a Confident AI

Odyssey 3
Odyssey · OtroOdyssey-3 es el modelo del mundo fundacional de Odyssey. Simula física en tiempo real, convierte una descripción en un entorno interactivo y se adapta a robots, coches y videojuegos.

JarvisCore
Prescott Data · Programación · Productividad · OtroJarvisCore es un runtime de código abierto en Python donde los agentes de IA actúan como pares en una malla, reclaman tareas de un libro mayor compartido y llegan a servicios externos por un bróker sin confianza.
Clef
Cloudflare · Negocios · OtroClef es el modelo de decisión de código abierto de Cloudflare para Workers AI. Devuelve probabilidades calibradas para preguntas tipadas en lugar de texto, así que un agente clasifica, enruta y actúa rápido.