

HunyuanVideo-Avatar
Tencent Hunyuan · Imagen · Vídeo
HunyuanVideo-Avatar es el modelo abierto de Tencent que convierte una imagen y un audio en un vídeo hablado o cantado, con control de emoción y varias personas en escena.
Acerca de HunyuanVideo-Avatar
What Is HunyuanVideo-Avatar
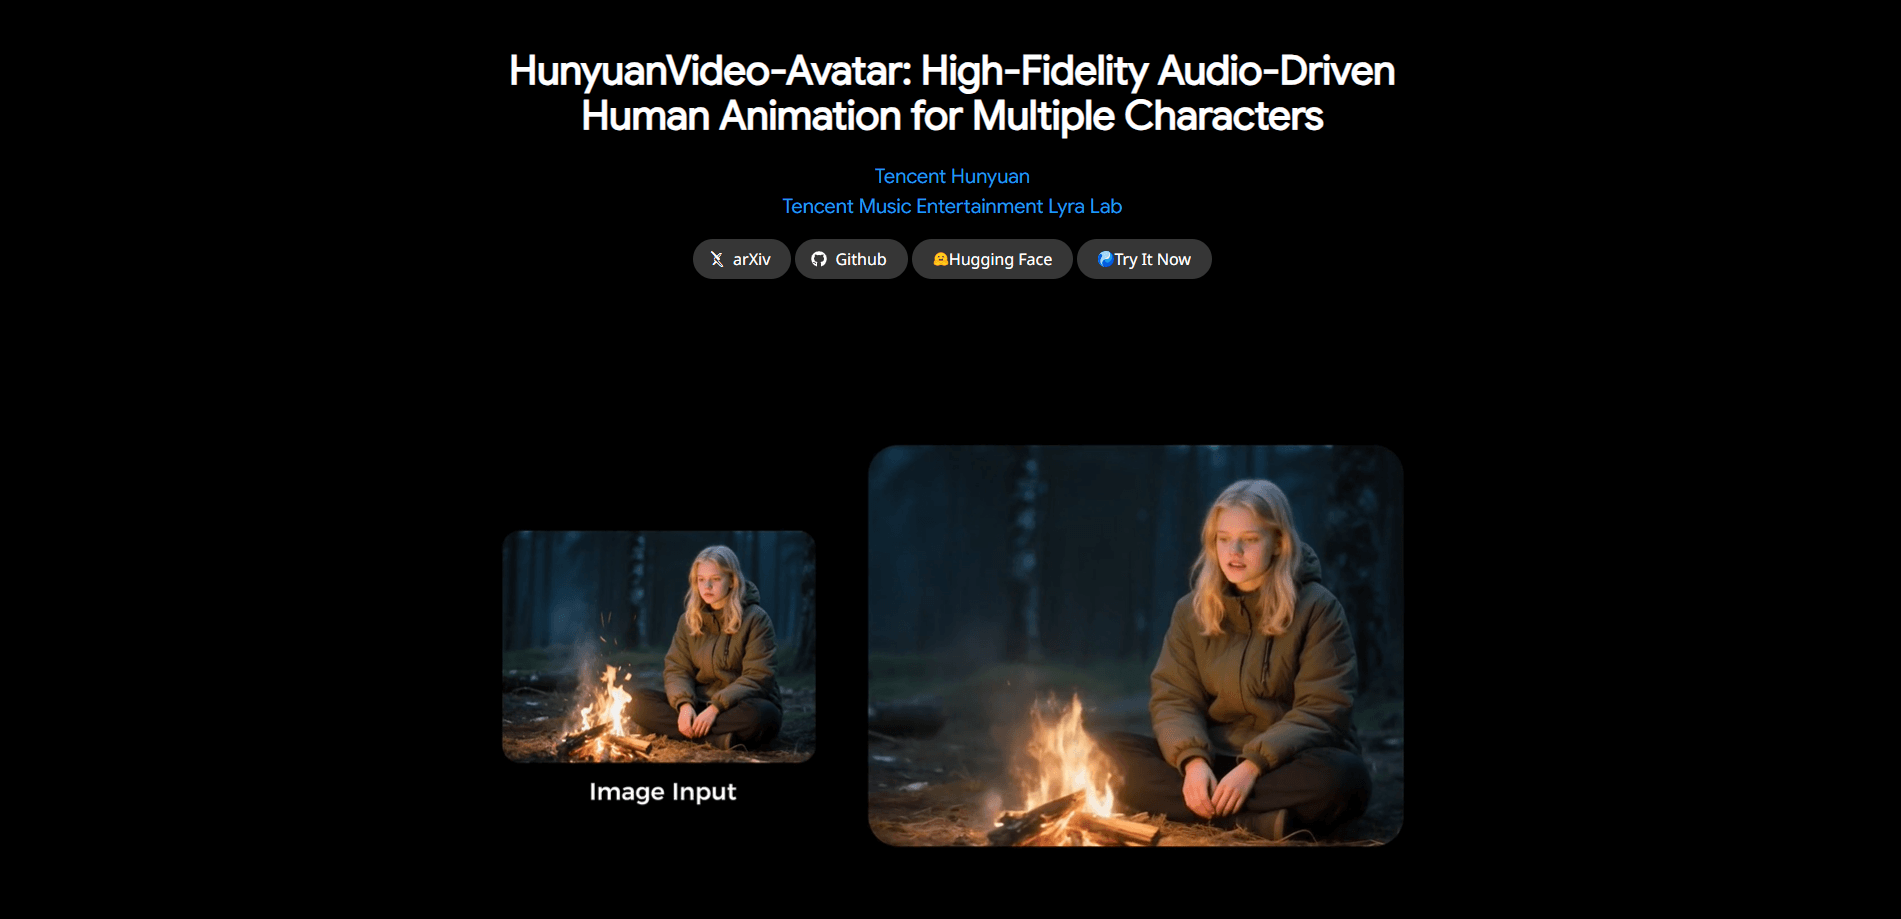
HunyuanVideo-Avatar es un modelo abierto de animación humana guiada por audio, creado por Tencent Hunyuan junto al equipo MuseV del Lyra Lab de Tencent Music y publicado en mayo de 2025. Le das un solo retrato y una pista de audio, y devuelve un vídeo donde la cara se mueve, los labios siguen el habla y el personaje mantiene la misma identidad del primer al último fotograma.
Casi todas las herramientas de sincronía labial se quedan en la boca. Esta mueve el fotograma completo, desde cabeza y hombros hasta cuerpo entero, y además lee la emoción de una imagen de referencia, así que el mismo clip puede salir alegre o serio. También resuelve varias personas en una escena, cada una atada a su propia pista de audio, que es justo donde los modelos anteriores mezclaban las caras. La salida llega hasta 720p, y el laboratorio oficial limita las subidas a unos 14 segundos de audio.
No es una web de un clic para cualquiera. El modelo se distribuye como código y pesos que descargas y ejecutas tú, así que para usarlo directo necesitas una GPU NVIDIA y un entorno de Python en condiciones. Hay una vista previa alojada en el sitio de Hunyuan de Tencent, pero las funciones a fondo con varios personajes viven en la versión abierta. Los derechos y el consentimiento de cualquier cara o voz que animas son tuyos, no del modelo.
Getting Started
- Entra en el repositorio oficial de GitHub y clónalo, luego monta un entorno Python 3.10 con una GPU NVIDIA compatible con CUDA.
- Instala las dependencias de PyTorch y FlashAttention que lista el README y descarga los pesos preentrenados.
- Elige un retrato nítido y de frente como imagen del personaje, y prepara un audio limpio de voz o canto.
- Ejecuta el script de inferencia y elige el modo de una o varias GPU según tu equipo y tu memoria.
- Revisa el vídeo renderizado, ajusta la resolución o el encuadre si hace falta y exporta el resultado.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de HunyuanVideo-Avatar.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Creadores de vídeo corto
- Desarrolladores e investigadores
- Equipos de comercio electrónico y directos
- Artistas de dibujo y 3D
Tareas
- Convertir un retrato en vídeo hablado
- Producir un clip cantado
- Controlar la emoción
- Animar una escena de dos personas
- Construir un pipeline propio
Casos de uso
- Renovar vídeos de producto rápido
- Sacar un corte en otro idioma
- Convertir un pódcast en vídeo
- Prototipar un concepto de avatar
Funciones clave
One Image Plus Audio
El truco de fondo es fácil de decir y difícil de lograr: le entregas un solo retrato y una pista de audio, y el modelo devuelve un vídeo donde el personaje habla o canta con los labios a tono y un movimiento corporal natural. Acepta imágenes de distintos tamaños y resoluciones, de modo que tanto un recorte cerrado como un plano de cuerpo entero sirven como entrada. Esta es la función que te ahorra un día de rodaje, porque una foto fija sustituye a una actuación filmada.
Emotion-Controllable Expression
Un módulo de emoción de audio lee las señales emocionales y las lleva a la cara del personaje, así que la expresión sigue el ánimo del audio en vez de quedarse plana. Una imagen de referencia orienta esa emoción, lo que significa que la misma línea de voz puede sonar alegre o seria según lo que le des. Para quien ha visto a un avatar rígido leer un guion, esta es la parte que hace que el resultado se sienta vivo.
Multi-Character Dialogue
El modo multipersonaje deja que varias personas compartan una escena, cada una movida por su propio audio, algo que a los modelos anteriores les costaba mantener separado. Un adaptador de audio sensible a la cara enmascara cada rostro para que la voz de un personaje no se cuele en la boca de otro. Eso convierte un pódcast de dos anfitriones o una entrevista de ida y vuelta en un solo vídeo, en lugar de dos clips que alineas a mano. Es la razón más fuerte para elegir este modelo por encima de una simple herramienta de intercambio de caras.
Multi-Style and Multi-Scale Characters
El modelo funciona igual con caras fotorrealistas, dibujos, renders 3D y personajes antropomorfos, así que una mascota estilizada recibe el mismo trato de labios y movimiento que un presentador real. También genera en encuadres de retrato, medio cuerpo y cuerpo entero, algo que importa cuando una cabeza parlante no basta. Menos concesiones en la entrada significan que mantienes el estilo de tu proyecto en lugar de adaptarte a la herramienta.
High-Dynamic Video Output
Los clips generados llevan movimiento tanto en el primer plano como en el fondo, no solo una cara pegada sobre una imagen quieta. El personaje se mueve, la escena cambia y el resultado se sostiene hasta 720p. El precio es el peso: la generación de alta dinámica es lo que vuelve al modelo tragón de memoria de GPU, así que las escenas más cargadas piden la mejor tarjeta que tengas.
Open Code and Weights
El código de inferencia y los pesos del modelo se publican abiertamente, con licencia de uso personal y comercial según los términos de Tencent. Puedes correr todo en tu propio hardware, revisar cómo funciona y ajustarlo con tus datos. Esa apertura es el gran atractivo para los equipos que no quieren mandar caras y voces a un servicio de terceros, y por eso el modelo se extendió rápido en la comunidad investigadora.
Ventajas y desventajas
Ventajas
- Con una foto y un audio basta, así que una imagen fija reemplaza a una actuación filmada.
- El módulo de emoción de audio le da al personaje un ánimo que sigue el sonido, no una expresión fija.
- El soporte multipersonaje mantiene a cada hablante en su propio audio, lo que evita coser clips a mano.
- El modelo corre con caras fotorrealistas, dibujos, 3D y animales, así que tu estilo artístico se mantiene.
- El código y los pesos abiertos dejan que los equipos lo corran en local y lo ajusten en vez de alquilar un servicio cerrado.
Desventajas
- Correrlo por tu cuenta exige una GPU NVIDIA, y la mejor calidad recomienda una tarjeta de 96GB, lo que deja fuera a casi cualquier equipo de consumo.
- El laboratorio alojado limita el audio a unos 14 segundos y es lento para trabajo en vivo, así que los clips largos piden el montaje local.
- Los renders son lentos en hardware modesto, de modo que los plazos cortos en trabajos grandes no son realistas sin tarjetas potentes.
- No hay una API pública anunciada para la versión abierta, así que los desarrolladores tienen que construir ellos mismos la capa de servicio.
Preguntas frecuentes
HunyuanVideo-Avatar es un modelo abierto de Tencent para animación humana guiada por audio. Toma una imagen de retrato y un audio y produce un vídeo donde el personaje habla o canta con movimiento de labios y expresión a tono, y puede manejar más de un personaje en una escena. Viene de Tencent Hunyuan y del equipo MuseV de Lyra Lab de Tencent Music, y salió en mayo de 2025.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con HunyuanVideo-Avatar.
Alternativas a HunyuanVideo-Avatar

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

Tractionwave
TractionWave · Imagen · MarketingTractionWave genera mapas de calor de atención con IA para anuncios estáticos. Subes un PNG o JPG y obtienes la atención prevista, puntos calientes ordenados y correcciones antes de invertir presupuesto.

Imejis.io
Imejis.io · Imagen · MarketingImejis.io es un estudio de diseño con IA para agentes y equipos de marketing. Describes una imagen con tus palabras y la herramienta escribe el texto, arma la maqueta, la adapta a cada tamaño y exporta el archivo final.