
LFM2
Liquid AI · Otro
LFM2 es una familia de modelos de lenguaje pequeños de Liquid AI hecha para funcionar en el propio dispositivo. Los checkpoints de 350M, 700M y 1.2B corren rápido en cualquier CPU.
Acerca de LFM2
What Is LFM2
LFM2 es la segunda generación de los modelos fundacionales de Liquid AI, lanzada en julio de 2025. La empresa salió del laboratorio CSAIL del MIT y construye modelos que cambian tamaño bruto por velocidad y eficiencia de memoria. LFM2 llega en tres checkpoints densos: 350M, 700M y 1.2B de parámetros. Cada uno es lo bastante pequeño como para correr en un teléfono, un portátil o el sistema de un coche sin un centro de datos detrás.
La propuesta es sencilla. Los modelos en la nube son potentes, pero lentos y caros de mantener a escala, y mandan tus datos fuera del dispositivo. LFM2 busca que la IA útil se quede local, donde las respuestas vuelven en milisegundos y nada sale de la máquina. Según Liquid AI, los modelos decodifican y hacen prefill el doble de rápido que Qwen3 sobre una CPU, y su pipeline de entrenamiento es 3 veces más eficiente que el de la primera generación LFM.
El problema es que un modelo pequeño tiene poco conocimiento. Liquid AI recomienda afinar LFM2 para tareas concretas como extracción de datos, RAG o chat de varios turnos, y avisa de que no sirve para trabajo cargado de conocimiento, como razonamiento profundo o programación compleja. Trata LFM2 como una pieza rápida y privada, no como un asistente que lo sabe todo.
Getting Started
- Elige un checkpoint en Hugging Face que encaje con tu hardware, desde 350M para dispositivos diminutos hasta 1.2B para un portátil o una GPU suelta
- Descarga los pesos o usa un formato cuantizado como GGUF para llama.cpp si quieres una huella aún menor
- Ejecútalo en local con un framework compatible, como llama.cpp, ExecuTorch o las herramientas estándar de Transformers
- Ajusta el modelo con un framework como TRL sobre tus propios datos si un checkpoint general no cubre tu tarea, y luego lleva esa versión a tu dispositivo
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de LFM2.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores de apps que integran funciones locales
- Equipos con restricciones de privacidad
- Aficionados y curiosos
- Startups por debajo de 10 M$ de ingresos
Tareas
- Flujos agénticos
- Extracción de datos
- Generación aumentada por recuperación
- Chat de varios turnos
- Apoyo a la escritura creativa
Casos de uso
- Una app de móvil necesita responder sin conexión
- Un usuario de portátil quiere redactar en local
- Un fabricante lleva IA a un dispositivo ajustado
- Un equipo regulado debe retener los datos en casa
- Un desarrollador prototipa un agente en el sistema del coche
Funciones clave
Arquitectura híbrida de convolución y atención
LFM2 combina convoluciones cortas con atención de consultas agrupadas en lugar de apoyarse solo en la atención. Cada modelo apila 16 bloques: 10 de convolución de corto alcance con doble compuerta y 6 de atención de consultas agrupadas. El diseño captura patrones locales a bajo costo y recurre a la atención solo donde renta, y así mantiene bajas la latencia y la memoria en el hardware que de verdad llevan teléfonos y portátiles.
Velocidad en CPUs corrientes
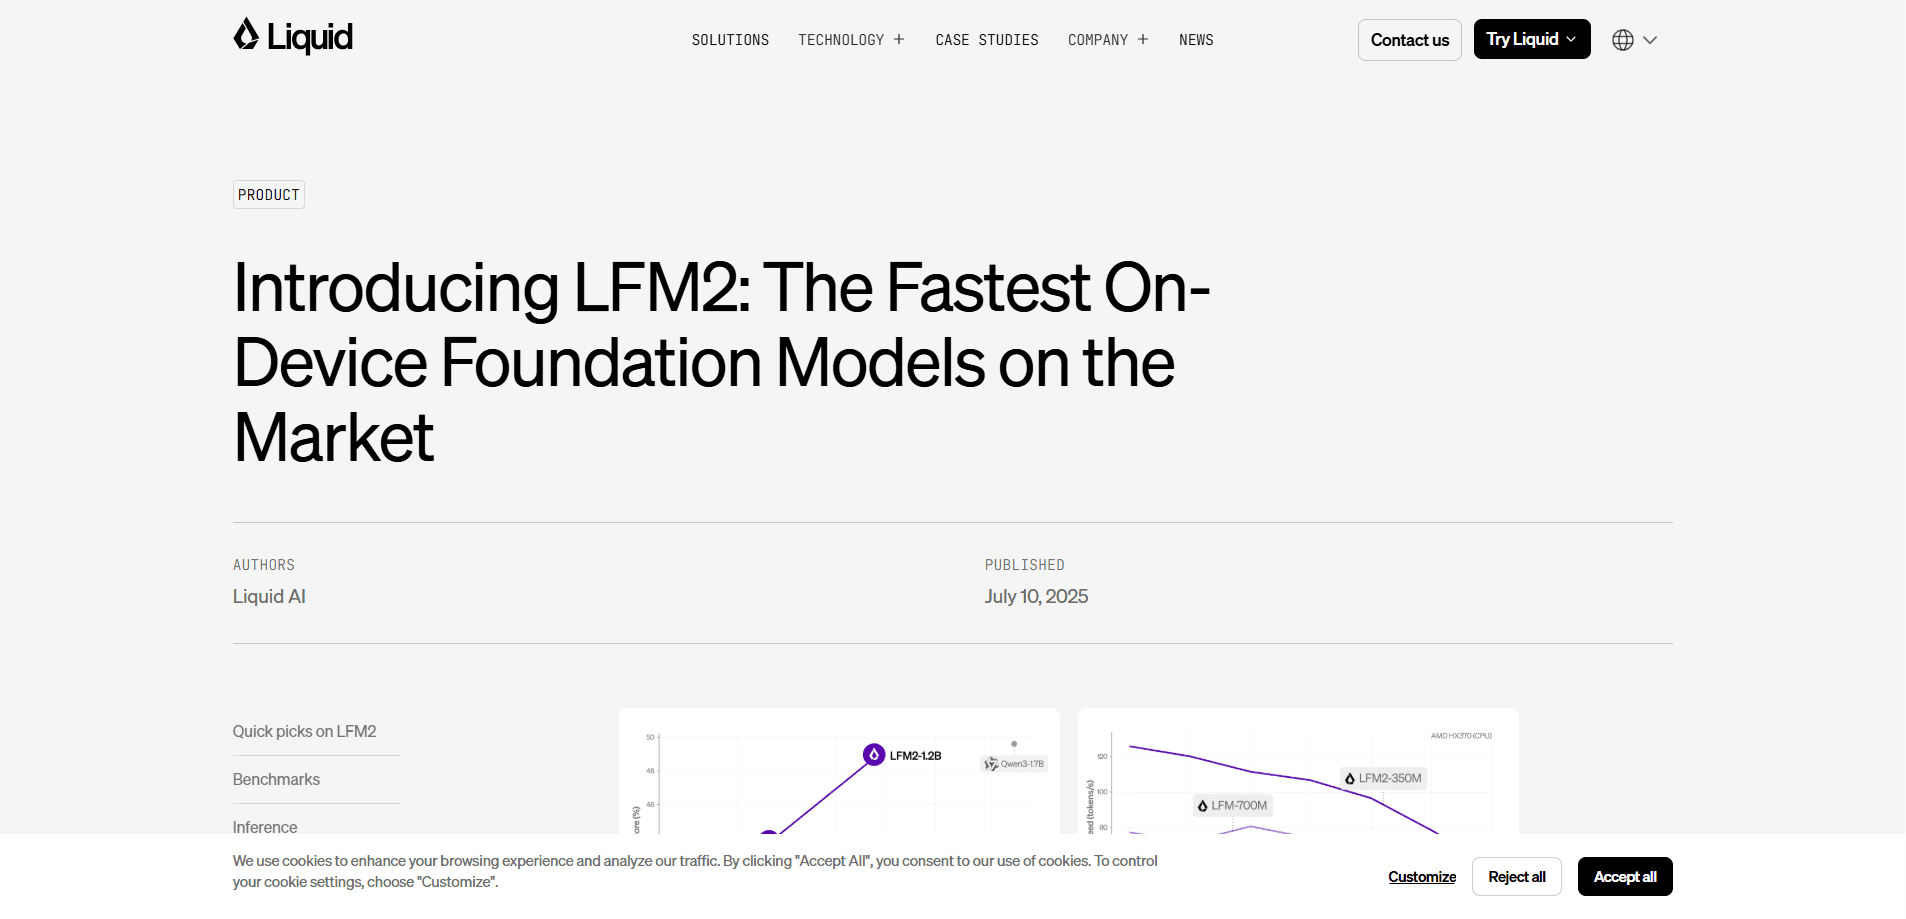
La gran promesa es el rendimiento, no la precisión bruta. Según Liquid AI, LFM2 decodifica y hace prefill el doble de rápido que Qwen3 en una CPU, y el modelo pequeño de 700M se mantiene más rápido que un Qwen 0.6B tanto en llama.cpp como en ExecuTorch pese a cargar más parámetros. Esa diferencia pesa en un teléfono o un portátil fino, donde la CPU es el único chip con el que puedes contar.
Cuatro tamaños para distintos equipos
La familia abarca 350M, 700M, 1.2B y 2.6B de parámetros, así que ajustas el modelo al dispositivo. La versión de 350M entra en wearables y objetivos embebidos ajustados, mientras que el checkpoint de 1.2B corre en un portátil o una GPU suelta y compite con modelos que llevan muchos más parámetros. Al ser una familia pensada para el borde, una sola arquitectura para varios tamaños te deja subir o bajar una función sin reescribirla.
Benchmark LFM2 competitivo a pequeña escala
Según Liquid AI, LFM2-1.2B rinde a la altura de Qwen3-1.7B, un modelo con un 47% más de parámetros, y sus puntuaciones quedan cerca de modelos muchas veces más grandes. El checkpoint de 700M supera a Gemma 3 1B IT, y el de 350M pelea de tú a tú con Qwen3-0.6B y Llama 3.2 1B Instruct. En las pruebas de varios turnos de la propia empresa, los jueces prefirieron el modelo de 1.2B frente a Llama 3.2 1B Instruct y Gemma 3 1B IT.
Pesos abiertos y licencia flexible
Liquid AI publica los pesos en Hugging Face bajo una licencia abierta basada en Apache 2.0. El uso académico y de investigación es gratis, y las empresas con menos de 10 M$ de ingresos pueden usar los modelos con fines comerciales sin pagar nada. Por encima de ese umbral, contactas con Liquid AI para una licencia comercial, lo que mantiene los términos simples para equipos pequeños y deja margen para acuerdos con empresas grandes.
Compatibilidad amplia de herramientas
LFM2 se exporta a los frameworks que los desarrolladores ya usan. Corre en llama.cpp para inferencia local, en PyTorch vía ExecuTorch para móvil y con las herramientas estándar de Transformers para entrenar. El ajuste con TRL es una vía soportada, y las versiones GGUF hacen fácil meter los modelos en apps de inferencia que ya tienes.
Contexto de 32K y entrenamiento multilingüe
Cada checkpoint maneja una ventana de contexto de 32.768 tokens, suficiente para documentos largos y chats extensos. El entrenamiento usó 10 billones de tokens repartidos en un 75% de inglés, 20% multilingüe y 5% de código, con atención extra al japonés, árabe, coreano, español, francés y alemán. Eso convierte a LFM2 en una opción razonable para apps que atienden a más de un idioma.
Ventajas y desventajas
Ventajas
- Corre rápido en las CPU que ya llevan teléfonos, portátiles y coches, así que no necesitas GPU ni servicio en la nube
- Los checkpoints pequeños mantienen baja la memoria, algo que encaja con wearables y otros objetivos embebidos ajustados
- Sus resultados igualan o superan a modelos más grandes como Qwen3-1.7B y Gemma 3 1B IT con una fracción del tamaño
- Pesos abiertos y licencia comercial gratis para empresas por debajo de 10 M$ de ingresos abaratan el arranque
- Funciona con herramientas conocidas como llama.cpp, ExecuTorch y TRL, así que adoptarlo no implica reescribir nada
Desventajas
- Los modelos pequeños manejan menos conocimiento del mundo, así que el razonamiento profundo o la programación compleja quedan fuera de su terreno
- Liquid AI recomienda afinar para casos concretos, lo que añade trabajo previo antes de ver los mejores resultados
- La licencia comercial exige un acuerdo de pago cuando tu empresa pasa de 10 M$ de ingresos, así que escalar tiene un costo
- Ya existen checkpoints LFM2.5 más nuevos y variantes de mayor tamaño, así que los tres tamaños originales ya no son la opción más reciente
Preguntas frecuentes
LFM2 está hecho para IA en el dispositivo, donde un modelo pequeño corre en local en vez de en la nube. Sus usos típicos incluyen flujos agénticos, extracción de datos, generación aumentada por recuperación, chat de varios turnos y apoyo a la escritura creativa. Liquid AI orienta a los desarrolladores hacia tareas concretas y bien definidas, no hacia razonamiento de propósito general.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con LFM2.
Alternativas a LFM2

Odyssey 3
Odyssey · OtroOdyssey-3 es el modelo del mundo fundacional de Odyssey. Simula física en tiempo real, convierte una descripción en un entorno interactivo y se adapta a robots, coches y videojuegos.

JarvisCore
Prescott Data · Programación · Productividad · OtroJarvisCore es un runtime de código abierto en Python donde los agentes de IA actúan como pares en una malla, reclaman tareas de un libro mayor compartido y llegan a servicios externos por un bróker sin confianza.
Clef
Cloudflare · Negocios · OtroClef es el modelo de decisión de código abierto de Cloudflare para Workers AI. Devuelve probabilidades calibradas para preguntas tipadas en lugar de texto, así que un agente clasifica, enruta y actúa rápido.