
LLM Gateway
The Open Co · Otro
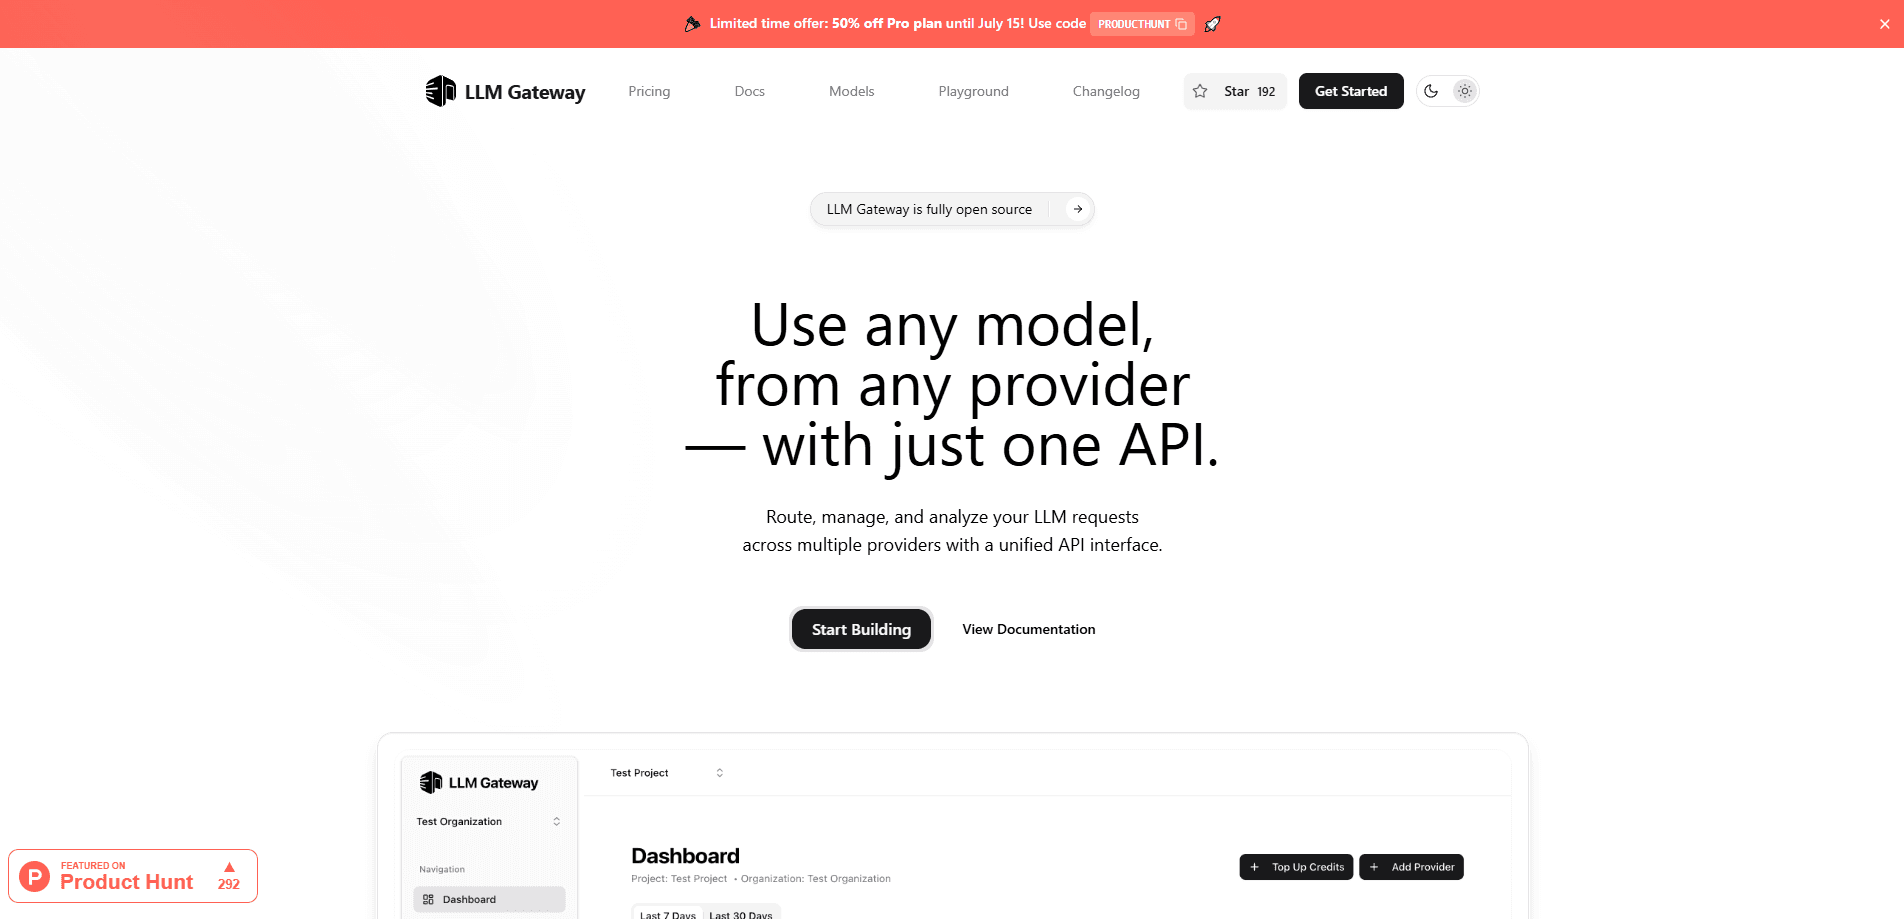
LLM Gateway es un gateway de IA de código abierto que envía peticiones a más de 250 modelos de 40 proveedores por un endpoint compatible con OpenAI, con conmutación, caché y control de costes.
Acerca de LLM Gateway
What Is LLM Gateway
LLM Gateway es una capa intermedia que se coloca entre tu aplicación y los proveedores de modelos. Apuntas tu SDK de OpenAI a una única URL base, conservas una sola clave de API y llamas al modelo que quieras. El gateway reenvía la petición a un proveedor y devuelve la respuesta en el mismo formato que tu código ya espera.
El problema que resuelve es la dispersión de proveedores. Cuando un proyecto toca OpenAI, Anthropic, Google y algún proveedor de modelos abiertos, acabas con claves, SDK y facturas por separado. LLM Gateway funciona como un API gateway de IA único para dar acceso a modelos de varios proveedores, así que cambiar de modelo es cuestión de tocar una cadena, no de reescribir código.
Es código abierto bajo AGPLv3, algo que importa si prefieres mantener los prompts dentro de tu propia red. Puedes usar la nube gestionada o ejecutar el mismo código por tu cuenta como proxy LLM autoalojado con Docker, Compose o Kubernetes. La contrapartida: al autoalojarlo, la disponibilidad y las actualizaciones pasan a tu equipo, y el plan gratuito depende del soporte de la comunidad.
Getting Started
- Entra al panel, crea un proyecto y copia la clave de API que genera.
- Exporta la clave como
LLM_GATEWAY_API_KEYen tu shell o en un archivo.env. - Cambia la URL base de tu SDK de OpenAI a
https://api.llmgateway.io/v1y conserva tu código. - Llama a un modelo por su nombre, como
gpt-4o, y deja que el gateway elija el proveedor. - Revisa latencia, coste y desglose por proveedor en el panel, y añade caché o conmutación a medida que crece el tráfico.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de LLM Gateway.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores backend y de plataforma
- Equipos de producto de IA
- Equipos de ingeniería celosos de su privacidad
Tareas
- Cambiar de modelo sin reescribir código
- Sobrevivir a las caídas de un proveedor
- Controlar el gasto en IA
Casos de uso
- Mantener un chatbot con varios proveedores en producción
- Prototipar con modelos gratuitos
- Conservar los datos en casa
Funciones clave
One OpenAI-Compatible Endpoint
El gateway habla el formato de la API de OpenAI, así que las completaciones de chat, los embeddings, las imágenes, la voz y la transcripción funcionan con tu SDK actual. El enrutamiento de modelos por precio, latencia o disponibilidad se configura desde el panel. Cambias la URL base y el nombre del modelo, nada más. Para quien ya usa el SDK de OpenAI, esa es toda la migración.
Smart Routing and Automatic Fallback
Las peticiones se pueden enrutar por precio, latencia, rendimiento o disponibilidad, y puedes fijar un proveedor concreto con la forma proveedor/modelo. Una petición que solo nombra un modelo se reintenta en otro proveedor que lo sirva cuando el primero falla. Puedes bloquearlo con la cabecera X-No-Fallback: true si prefieres ver un error limpio.
Response Caching
Las peticiones repetidas se sirven desde una caché sobre Redis, lo que recorta latencia y gasto en prompts idénticos. Los controles de caché del proveedor también pasan de largo, así conservas su propio comportamiento. Las apps de gran volumen lo notan antes que nada en la factura.
Guardrails and PII Protection
El gateway aplica protección contra inyección de prompts, detección y borrado de datos personales, detección de secretos y un motor de reglas propio en el borde. La política se ejecuta en el mismo punto por el que pasa cada petición, no en cada app. Quien maneja datos sensibles gana un único punto de control.
Centralized Key Management
Las claves de proveedor se guardan cifradas y se emparejan con claves de API por proyecto que llevan topes de uso y gasto y trazabilidad completa. Rotas las claves sin tocar el código de la aplicación. Es la función que evita que un equipo en crecimiento pase claves de proveedor en crudo.
Cloud or Self-Hosted Deployment
Puedes usar el gateway gestionado o ejecutar el código AGPLv3 en tu propia infraestructura con Docker, Compose o Kubernetes. El autoalojamiento es gratis y todo, del enrutamiento a las analíticas, funciona igual. La decisión se reduce a quién quieres que asuma la disponibilidad.
Ventajas y desventajas
Ventajas
- Un solo endpoint compatible con OpenAI cubre más de 250 modelos de 40 proveedores, así que cambiar de modelo es tocar una cadena.
- La conmutación y el reintento automáticos mantienen vivas las peticiones cuando un proveedor está limitado o caído.
- La caché de respuestas y los topes de gasto por clave dan control directo sobre el coste de la IA.
- El núcleo AGPLv3 se puede autoalojar, lo que mantiene prompts y respuestas dentro de tu propia red.
- Las barreras contra inyección de prompts, datos personales y secretos se ejecutan en el gateway, no en cada app.
Desventajas
- Los créditos de pago por uso llevan una comisión fija del 5% sobre las tarifas por token del proveedor, así que el uso gestionado cuesta más que llamar a los proveedores directamente.
- Autoalojar traslada disponibilidad, actualizaciones y escalado a tu propio equipo, lo que implica trabajo operativo real.
- El plan gratuito es limitado y depende del soporte de la comunidad, así que los equipos de producción acaban pagando o autoalojando.
Preguntas frecuentes
Sirve para llamar a muchos modelos de IA con una sola API. En vez de integrar OpenAI, Anthropic, Google y otros uno a uno, envías peticiones a un único endpoint compatible con OpenAI y dejas que el gateway se encargue del enrutamiento.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con LLM Gateway.
Alternativas a LLM Gateway

Odyssey 3
Odyssey · OtroOdyssey-3 es el modelo del mundo fundacional de Odyssey. Simula física en tiempo real, convierte una descripción en un entorno interactivo y se adapta a robots, coches y videojuegos.

JarvisCore
Prescott Data · Programación · Productividad · OtroJarvisCore es un runtime de código abierto en Python donde los agentes de IA actúan como pares en una malla, reclaman tareas de un libro mayor compartido y llegan a servicios externos por un bróker sin confianza.
Clef
Cloudflare · Negocios · OtroClef es el modelo de decisión de código abierto de Cloudflare para Workers AI. Devuelve probabilidades calibradas para preguntas tipadas en lugar de texto, así que un agente clasifica, enruta y actúa rápido.