
LM Studio
Element Labs (LM Studio) · Otro · Chatbot
LM Studio es una aplicación de escritorio para ejecutar modelos de IA abiertos en tu propio ordenador. Su agente Bionic trabaja con documentos, código y voz, y un servidor local publica esos modelos mediante una API compatible con OpenAI.
Acerca de LM Studio
About
Qué es LM Studio
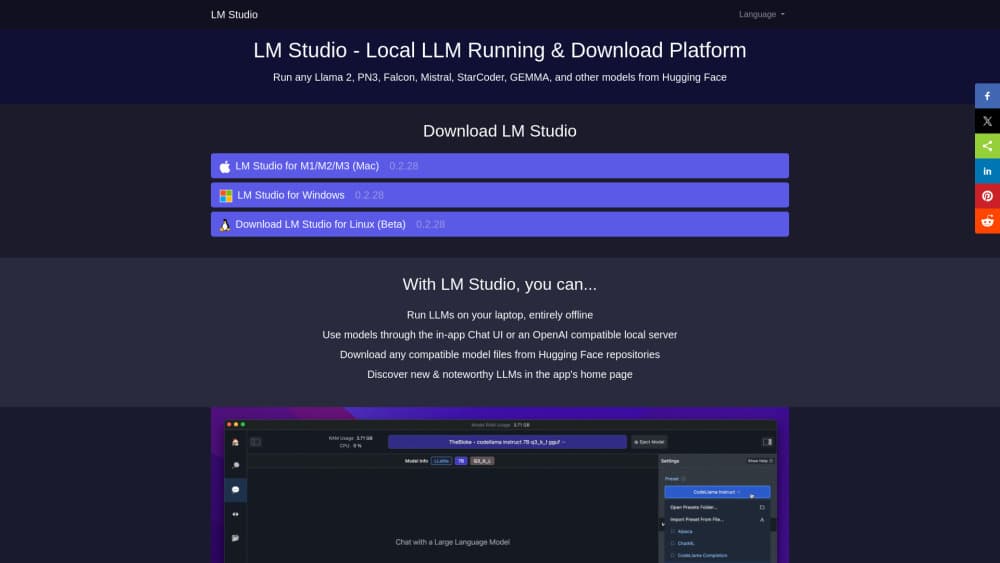
LM Studio es una app de escritorio que descarga modelos de lenguaje abiertos y los ejecuta en tu propio hardware. Buscas en un catálogo conectado a Hugging Face, eliges un modelo que quepa en tu memoria y en tu tarjeta gráfica, y empiezas a chatear. El LLM local funciona entero en tu máquina en cuanto los pesos están en el disco.
La versión más reciente, LM Studio Bionic, convierte esa misma app en un espacio de trabajo con agente. Abres un proyecto, le das una tarea y el agente lee archivos, edita documentos, escribe código o controla partes del escritorio. Debajo siguen los modelos locales. Si un trabajo se queda grande para tu GPU, puedes pasar esa sesión a un modelo abierto alojado en Estados Unidos sin cambiar de herramienta.
Lo que engancha es el trabajo de configuración que desaparece. No hay entorno de Python que montar, ni toolkit de CUDA que cuadrar, ni archivo de configuración que editar a mano. LM Studio mira tu equipo y te dice qué modelos van a ir cómodos y cuáles van a arrastrarse. Esa sola comprobación, hecha antes de una descarga de 20 GB, le ahorra a un principiante una tarde perdida.
Los límites también cuentan. La aplicación es de código cerrado, así que no puedes auditarla ni crear una bifurcación. El tamaño del modelo lo marca tu RAM y tu VRAM, y eso deja fuera los modelos abiertos más grandes en un portátil. Y está pensada para una persona sentada delante de un escritorio, no para un equipo que machaca el mismo endpoint todo el día.
Primeros pasos
- Descarga LM Studio desde lmstudio.ai para macOS, Windows o Linux y ábrelo. Para mirar el catálogo no hace falta cuenta.
- Busca un modelo por nombre o usa la lista recomendada, que se filtra según la memoria y la GPU que detecta la app. Empieza por uno más pequeño de lo que crees necesitar.
- Descarga los pesos y carga el modelo. La app elige el motor por ti, MLX en Apple Silicon y llama.cpp en el resto, y muestra qué parte del modelo queda en la GPU.
- Chatea en la ventana integrada, o mete un PDF y una hoja de cálculo en un proyecto y pregunta sobre ellos.
- Activa el servidor local cuando un script necesite acceso. Escucha en el puerto 1234 por defecto y habla el formato de chat completions de OpenAI, así que las librerías cliente que ya usas funcionan cambiando la URL base.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de LM Studio.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Profesionales que cuidan la privacidad
- Desarrolladores que prueban prompts
- Estudiantes y aficionados que quieren ver cómo se comporta un LLM
Tareas
- Resumir documentos largos sin conexión
- Escribir y refactorizar código
- Redactar y corregir documentos de trabajo
- Alimentar otra aplicación con un endpoint local
Casos de uso
- Trabajar en un avión o en una oficina con la red cerrada
- Mantener material sensible de clientes dentro de casa
- Servir un modelo desde un equipo de casa en lugar del escritorio
Funciones clave
Catálogo de modelos con comprobación de hardware
La app trae un índice searchable de modelos abiertos, tomado de Hugging Face y filtrado por lo que tu equipo puede mover de verdad. Cada ficha muestra el tamaño del archivo, la cuantización y una etiqueta de comodidad, así distingues una ejecución fluida de 8B de un modelo de 70B que acabará tirando de disco y atascándose. Las descargas se reanudan y se reintentan solas. Para la mayoría de la gente, esta función es la que separa LM Studio de una compilación pelada de llama.cpp.
Agente Bionic para documentos y código
Bionic es una capa de agente por proyectos que se apoya en el modelo. Abres un proyecto, inicias una sesión para una tarea y dejas que lea archivos, escriba en ellos y ejecute comandos. Las sesiones de documentos crean y revisan textos y diapositivas con guardado automático. Las de código trabajan sobre un repositorio entero. Puedes tener varias sesiones abiertas en un mismo proyecto, algo útil cuando una tarea de investigación y otra de compilación no deben compartir contexto.
Servidor local compatible con OpenAI
Un interruptor convierte el modelo cargado en un endpoint HTTP en localhost:1234, con la misma forma de petición que la API de chat completions de OpenAI. Los SDK y clientes que ya tienes funcionan cambiando la URL base y poniendo una clave de relleno. También hay un SDK y una herramienta de línea de comandos para automatizar, además de salidas estructuradas y llamadas a herramientas en los modelos que las soportan. Para prototipar en local te ahorra montar un servidor simulado.
Motores MLX y llama.cpp
LM Studio incluye dos motores de inferencia y elige entre ellos según la plataforma. Los Mac con Apple Silicon usan MLX, afinado para la memoria unificada, y suelen responder más rápido en los chips de la serie M. Las máquinas Windows y Linux ejecutan llama.cpp con descarga a GPU en tarjetas Nvidia, AMD o Intel. Puedes ajustar cuántas capas van a la GPU cuando un modelo entra por poco, cambiando velocidad por margen.
Chat con documentos sin conexión
Puedes darle a la app un PDF, un archivo de Word o un conjunto de notas y preguntar sobre el contenido. La recuperación ocurre en tu máquina contra un índice local, así que el documento nunca se sube. Es la versión práctica del discurso de la privacidad para quien se pasa el día leyendo contratos o artículos científicos.
Entrada de voz local
Bionic transcribe lo que dices con un modelo que corre en el dispositivo. El audio no viaja a ningún servidor. Dictar un párrafo en un documento o en un prompt funciona sin conexión, y hay varios idiomas disponibles. La precisión queda por debajo de la transcripción en la nube de pago con acentos marcados, y ese es el precio de no sacar el audio de casa.
Ventajas y desventajas
Ventajas
- Un solo instalador cubre descubrimiento de modelos, chat, preguntas sobre documentos y API, sin pelearse con Python ni con CUDA.
- La comprobación de hardware antes de descargar evita el error más común del principiante, que es bajar un modelo que no cabe en memoria.
- El soporte de MLX lo coloca entre las formas más rápidas de mover modelos abiertos en un Mac con Apple Silicon.
- El servidor local sustituye a los clientes de OpenAI sin tocar código, incluidas llamadas a herramientas y salidas estructuradas en los modelos que las admiten.
- El plan gratuito sirve de verdad para trabajo local, y los planes de pago solo importan si quieres modelos alojados o un uso más intenso.
Desventajas
- La calidad del modelo local la pone tu hardware. Un portátil de 16 GB se queda en modelos pequeños y medianos, y los mejores pesos abiertos siguen fuera de alcance.
- La app es de código cerrado, así que un equipo que necesite auditar, parchear o redistribuir su pila de inferencia debería mirar llama.cpp o vLLM.
- El servicio está pensado para un usuario. La concurrencia y el batching son limitados frente a una pila de producción, y eso se nota en peticiones en cola cuando dos o tres clientes llaman al mismo puerto.
- El producto cambia rápido, y la división entre el LM Studio clásico y Bionic hace que algunos tutoriales y ajustes ya no coincidan con lo que ves en pantalla.
Preguntas frecuentes
Sí. El plan Free no cuesta nada e incluye descarga de modelos locales, chat, el agente y el servidor local. El precio de LM Studio empieza por encima: Bionic+ cuesta 20 dólares al mes con modelos abiertos alojados y búsqueda web, y Pro son 100 dólares al mes con cinco veces más cuota y acceso anticipado.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con LM Studio.
Alternativas a LM Studio

Odyssey 3
Odyssey · OtroOdyssey-3 es el modelo del mundo fundacional de Odyssey. Simula física en tiempo real, convierte una descripción en un entorno interactivo y se adapta a robots, coches y videojuegos.

JarvisCore
Prescott Data · Programación · Productividad · OtroJarvisCore es un runtime de código abierto en Python donde los agentes de IA actúan como pares en una malla, reclaman tareas de un libro mayor compartido y llegan a servicios externos por un bróker sin confianza.
Clef
Cloudflare · Negocios · OtroClef es el modelo de decisión de código abierto de Cloudflare para Workers AI. Devuelve probabilidades calibradas para preguntas tipadas en lugar de texto, así que un agente clasifica, enruta y actúa rápido.