
Ollama
Ollama · Imagen · Otro
Ollama es un entorno de IA local para ejecutar grandes modelos de lenguaje en tu propio equipo. Descarga modelos abiertos como Gemma 4, Qwen o gpt-oss, con una opción en la nube si el modelo no cabe.
Acerca de Ollama
What Is Ollama
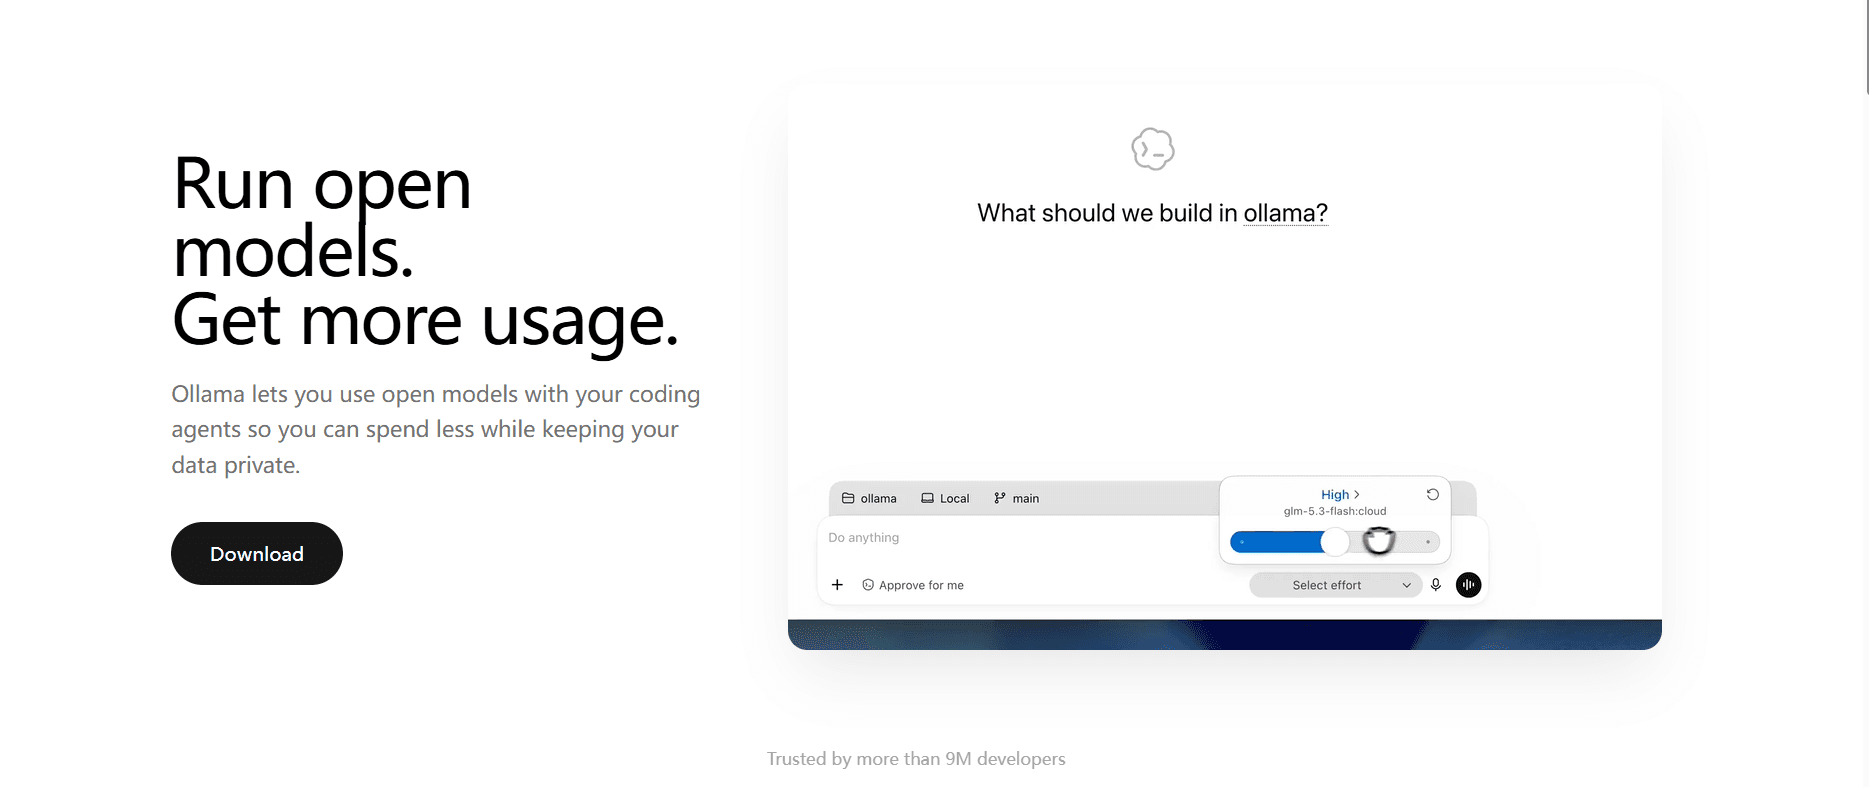
Ollama es un entorno de código abierto que ejecuta grandes modelos de lenguaje en tu propio ordenador. En lugar de alquilar un modelo a través de una API, descargas los pesos una vez y conversas sin conexión. Un solo comando baja y arranca el modelo, y la aplicación se encarga de lo complicado: formatos de cuantización, uso de GPU o de los chips Apple Silicon, límites de memoria y el proceso servidor que responde a las peticiones.
El proyecto arrancó en julio de 2023 y creció con rapidez. Hoy supera los 9 millones de instalaciones al mes y los 1.000 millones de descargas de modelos. En 2026 la empresa levantó 88 millones de dólares con Benchmark, Y Combinator y otros inversores, y añadió una capa en la nube para modelos demasiado grandes para un portátil.
Esa capa es la principal disyuntiva que conviene entender. Ejecutar modelos en local es siempre gratis e ilimitado, pero lo marca tu hardware: un modelo de 7B corre en un portátil modesto y uno de 200B exige una máquina con GPU de verdad. Los modelos en la nube quitan ese techo y se cobran por tokens, así que Ollama es a la vez una herramienta local gratuita y un servicio de pago según uso, en función del modelo que elijas.
Getting Started
- Descarga Ollama para macOS, Windows o Linux, o usa la imagen oficial de Docker, y abre la aplicación.
- Baja un modelo con
ollama pull gemma4:e2b(la descarga ronda los 7,2 GB), o elige Local durante la configuración si no quieres crear cuenta. - Ejecuta
ollama run gemma4:e2bpara chatear en la terminal, o lanza un agente de código conollama launch claude. - Para tus propias apps, envía peticiones a la API REST local en el puerto 11434, o apunta un cliente de OpenAI o Anthropic a los endpoints compatibles de Ollama.
- Inicia sesión y crea una clave cuando quieras modelos en la nube, y deja las peticiones pesadas fuera de tu equipo.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Ollama.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores que prueban modelos abiertos sin factura de nube
- Usuarios preocupados por la privacidad
- Equipos que despliegan agentes de código
- Investigadores que comparan familias de modelos
Tareas
- Tener un modelo de chat sin conexión
- Integrar IA en una aplicación
- Ajustar el comportamiento con un Modelfile
- Conectar agentes y editores
- Obtener datos estructurados de un modelo
Casos de uso
- Un portátil en un avión
- Una empresa con reglas estrictas de datos
- Un prototipo rápido antes de comprometerse con una factura de nube
- Una sesión de código con un agente local
Funciones clave
Modelos locales con un solo comando
La promesa central cabe en una línea: ollama pull trae los pesos y ollama run abre el chat. Ollama gestiona la cuantización, el reparto de memoria y el servidor por detrás, así que te ahorras el baile habitual de versiones de CUDA y entornos de Python. Los modelos salen de una biblioteca propia que cubre Gemma, Qwen, gpt-oss, DeepSeek, Kimi, MiniMax, GLM, Mistral y Nemotron.
Modelos en la nube con precio por token
No todos los modelos caben en un portátil, así que Ollama añadió una capa en la nube que ejecuta modelos abiertos grandes en el hardware de los proveedores NVIDIA Cloud. Pagas por millón de tokens, con tarifas fuera de hora que recortan el precio casi a la mitad fuera del horario laboral de días laborables. Las cuentas gratuitas reciben créditos iniciales y los planes de pago incluyen una asignación mensual.
API REST y compatibilidad con OpenAI
Cada modelo local levanta un servidor HTTP en el puerto 11434, así que cualquier lenguaje puede hablar con él. Ollama también entiende los formatos OpenAI Chat Completions y Responses y el formato Anthropic Messages, lo que significa que las herramientas hechas para esas APIs funcionan cambiando la URL base, casi siempre sin tocar el código.
Motor MLX en Apple Silicon
En los Mac, Ollama ejecuta los modelos compatibles mediante el marco MLX de Apple en lugar de un entorno traducido. El cambio trajo grandes mejoras de velocidad en 2026, entre ellas la predicción de varios tokens que la empresa midió como hasta un 90 % más rápida en agentes de código. El consumo de memoria también bajó, algo que importa en Macs con memoria unificada, donde la RAM es el límite real.
Integraciones con agentes y escritorio
ollama launch claude, ollama launch codex y comandos similares conectan los agentes de código a tus modelos. En el escritorio, Claude y ChatGPT (Desktop) se pueden apuntar a Ollama, lo que abre modelos como Muse Glimmer y Nemotron dentro de herramientas que ya usas.
Modelfiles y creación de modelos
Un Modelfile es una receta breve que define un modelo propio: pesos base, prompt de sistema, parámetros y plantilla. Lo construyes con ollama create y la definición viaja con el modelo, así las instrucciones compartidas se mantienen iguales en todo un equipo en lugar de vivir en notas sueltas.
Embeddings y salidas estructuradas
Ollama ejecuta modelos de embeddings como EmbeddingGemma y devuelve vectores para búsqueda o agrupación. El parámetro format acepta un esquema JSON para que el modelo responda con un objeto tipado, lo que convierte texto libre en datos que un programa puede leer sin adivinar la forma.
Modelos de decisión
Las versiones más recientes suman modelos de decisión que devuelven opciones, puntuaciones y probabilidades en lugar de prosa. Basados en la API Jev de TypeSafe, sirven para tareas como clasificar tickets o etiquetar contenido, y Ollama los ejecuta en un endpoint propio junto a los modelos de chat de siempre.
Ventajas y desventajas
Ventajas
- Los modelos locales son gratis e ilimitados, sin cuenta, clave ni conexión a internet.
- La instalación es un solo comando y la biblioteca integrada te ahorra la configuración del entorno.
- La API REST y los endpoints compatibles con OpenAI y Anthropic permiten que los clientes existentes cambien con solo tocar la URL.
- El soporte de Apple Silicon vía MLX trae notables mejoras de velocidad para los usuarios de Mac.
- Los modelos en la nube te dejan usar modelos abiertos grandes sin tener una GPU.
Desventajas
- El rendimiento local depende de tu hardware, así que los modelos grandes piden VRAM real y un portátil sufre con ellos.
- El precio en la nube varía según el modelo y la hora, lo que hace más difícil prever la factura mensual.
- Algunas funciones avanzadas de la nube, como correr varios modelos a la vez, están limitadas en el plan gratuito por los topes de concurrencia.
- La biblioteca de modelos, aunque amplia, es menor que la oferta completa de Hugging Face o de los grandes proveedores de nube.
Preguntas frecuentes
Ollama es un entorno para ejecutar grandes modelos de lenguaje abiertos en tu ordenador o en la nube. Descarga los modelos, arranca un servidor local y te da una línea de comandos, una app de escritorio y una API para trabajar con ellos.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Ollama.
Alternativas a Ollama

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

Tractionwave
TractionWave · Imagen · MarketingTractionWave genera mapas de calor de atención con IA para anuncios estáticos. Subes un PNG o JPG y obtienes la atención prevista, puntos calientes ordenados y correcciones antes de invertir presupuesto.

Imejis.io
Imejis.io · Imagen · MarketingImejis.io es un estudio de diseño con IA para agentes y equipos de marketing. Describes una imagen con tus palabras y la herramienta escribe el texto, arma la maqueta, la adapta a cada tamaño y exporta el archivo final.