
Preprocess
Preprocess · Productividad · Negocios
Preprocess era una API de fragmentación que dividía PDF, archivos de Office y HTML en fragmentos listos para RAG. El servicio ya no está disponible.
Acerca de Preprocess
What Is Preprocess
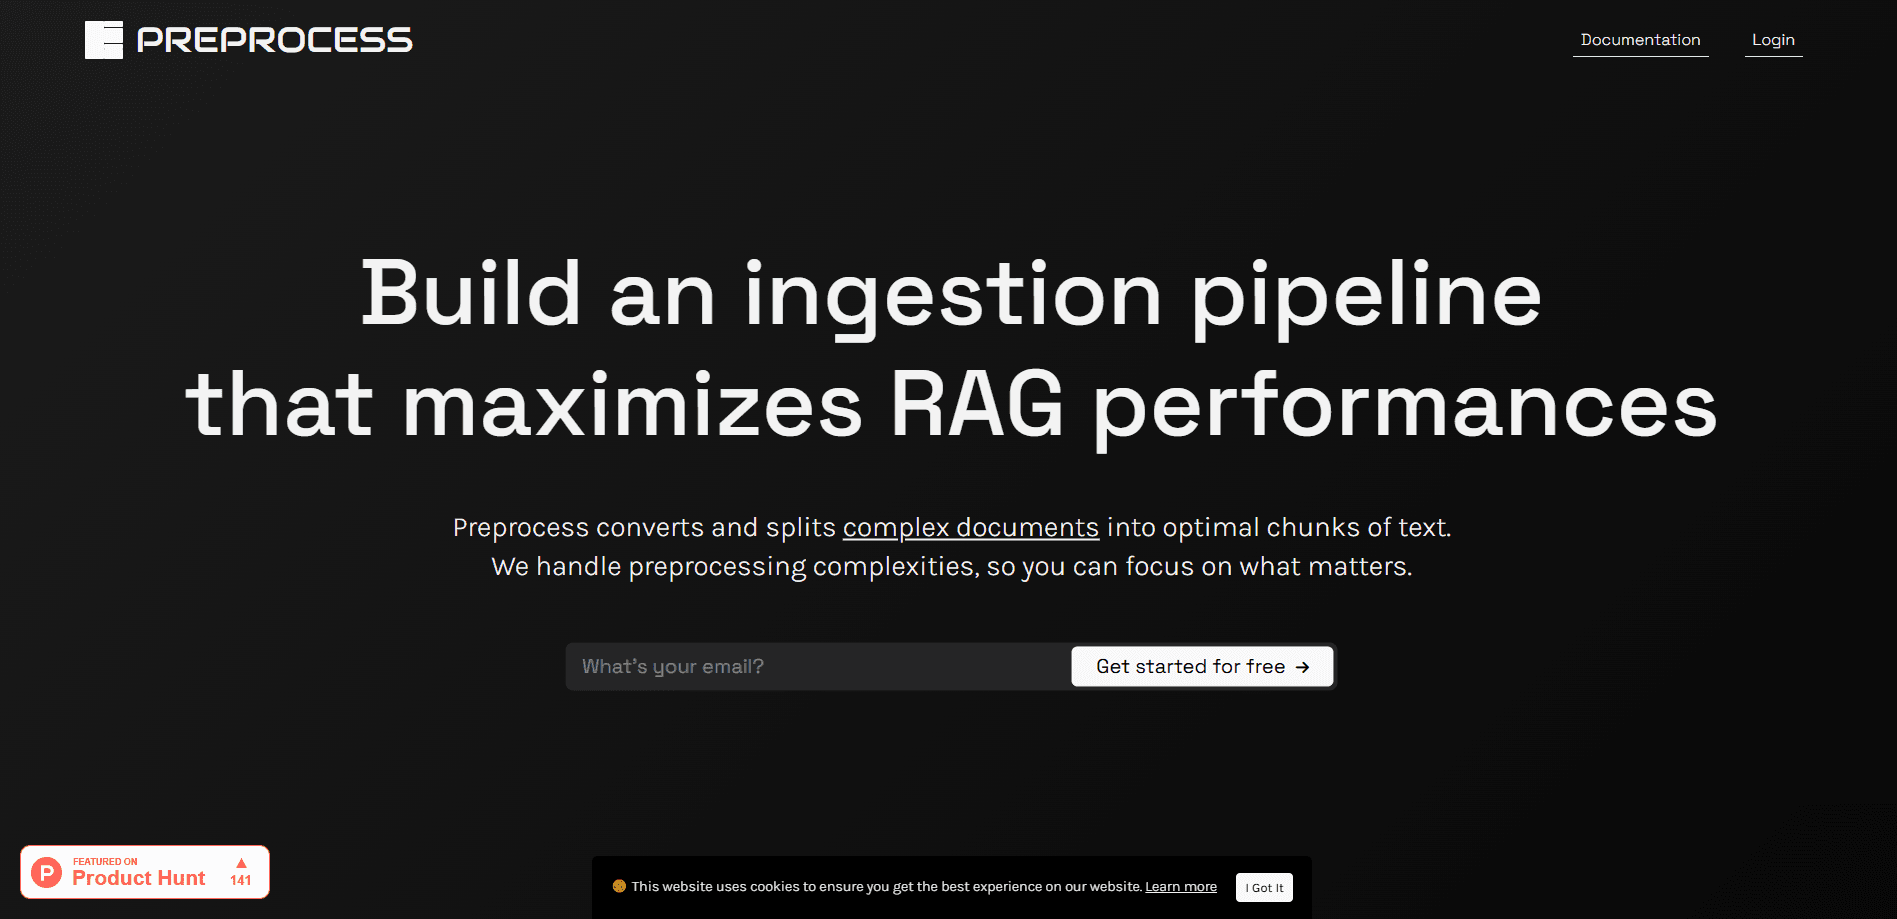
Preprocess era un servicio de API que convertía documentos largos y complejos en fragmentos de texto pensados para la recuperación. En lugar de cortar un archivo cada pocos cientos de palabras, leía títulos, secciones, párrafos, tablas, imágenes y listas, y después partía el contenido siguiendo la estructura y el sentido del propio documento. La empresa presentaba la salida como datos listos para RAG: piezas limpias que podías vectorizar, indexar y meter en una base de datos vectorial sin retocarlas antes.
El problema que atacaba el preprocesamiento de datos para RAG era real. Casi todos los equipos parten los documentos por un número fijo de palabras, y ese método le entrega al modelo lo que caiga dentro de la ventana. Una fila de tabla queda pegada a un título que no tiene que ver, una definición pierde su lista y el modelo responde con fragmentos sueltos. Preprocess afirmaba que la vía consciente de la estructura podía mejorar el rendimiento de RAG hasta 10 veces, una cifra de la propia empresa y no de una prueba independiente.
Hay algo que hoy pesa más que cualquier función. El servicio de preprocess.co ya no está disponible. La web oficial sirve un directorio vacío, la empresa cerró el servicio y tanto el SDK de Python como el lector de LlamaIndex llevan un aviso de que el proyecto está discontinuado y conviene quitarlo de los proyectos.
Getting Started
Estos eran los pasos cuando el servicio seguía activo.
- Regístrate en la app de Preprocess y compra un paquete de créditos para obtener tu clave de API
- Envía el documento al endpoint de análisis por carga directa o con el SDK de Python
- Deja que el análisis asíncrono termine y recibe el resultado en tu webhook o recógelo con una llamada GET durante 24 horas
- Lleva los fragmentos devueltos directo a tu base vectorial, sin un separador de texto aparte
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Preprocess.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Ingenieros de IA que armaban pipelines RAG
- Desarrolladores de backend sin parser propio
- Equipos de producto que lanzaban un asistente de IA
Tareas
- Fragmentar PDF largos
- Extraer tablas y listas
- Tratar documentos escaneados
- Procesar archivos de Office y HTML
Casos de uso
- Un equipo legal o financiero que metía contratos densos en una herramienta de búsqueda
- Un bot de soporte hecho con manuales y páginas de ayuda
- Una startup sin equipo de parseo
- Un proceso de ingesta por lotes
Funciones clave
Chunking inteligente consciente de la estructura
La función central partía los documentos siguiendo títulos, secciones, párrafos, tablas, imágenes y listas, y luego agrupaba los pasajes largos por sentido. Así cada fragmento apuntaba a un solo tema y la vectorización capturaba una idea única. La empresa sostenía que esto por sí solo subía la calidad de la recuperación y bajaba las alucinaciones, porque el modelo dejaba de recibir trozos desalineados.
Soporte amplio de formatos
La API aceptaba PDF, archivos de Microsoft Office, archivos de OpenOffice, HTML y texto plano por un único endpoint. Los PDF escaneados también entraban, porque la extracción de texto corría antes de fragmentar. Para equipos con fuentes mezcladas, eso era una sola integración en vez de un parser por tipo de archivo.
API asíncrona y webhooks
Analizar un documento largo lleva tiempo, así que la API trabajaba de forma asíncrona. Una llamada de análisis confirmaba la recepción y los fragmentos terminados llegaban a un webhook o se podían recuperar con una petición GET durante 24 horas. Ese diseño servía para procesos por lotes donde decenas de archivos se procesan a la vez y nada espera en cola.
SDK de Python e integración con LlamaIndex
Un SDK llamado pypreprocess envolvía la API en unas pocas líneas de Python, y un lector de LlamaIndex cargaba archivos ya fragmentados o recuperaba resultados anteriores por ID de proceso. El lector también devolvía el texto completo del documento cuando un equipo quería usar su propio pipeline. Hoy el SDK y el lector aparecen como discontinuados.
Precios por créditos, sin suscripción
Preprocess no cobraba cuota mensual. Comprabas un paquete de créditos y recargabas cuando se agotaban. Una página de un documento o una presentación costaba un crédito, una hoja de una hoja de cálculo costaba un crédito, y los archivos HTML o de texto se convertían a PDF antes de contar. Ese modelo encajaba con equipos de carga desigual.
Controles para empresas
Los planes altos añadían exportación de imágenes, control de los límites del fragmento, acuerdos de retención cero de datos, despliegue en servidores propios y pipelines de procesamiento a medida. Esas opciones apuntaban a sectores regulados donde los datos de documentos no pueden salir de la infraestructura de la empresa.
Ventajas y desventajas
Ventajas
- Fragmentaba por estructura y sentido, así la recuperación traía pasajes que no se salían del tema
- Un solo endpoint cubría PDF, archivos de Office, HTML y texto plano, escaneados incluidos
- Sin suscripción: solo paquetes de créditos que se ajustaban a cargas irregulares
- Los webhooks y el SDK de Python encajaban en pipelines de ingesta ya montados, sin pegamento extra
- El lector de LlamaIndex lo metía en una pila RAG habitual
Desventajas
- El servicio está discontinuado, así que hoy no hay forma de registrarse, comprar créditos ni llamar a la API
- La mejora de hasta 10 veces venía de la empresa, sin prueba independiente que la respaldara
- El precio eran créditos prepago y no un plan medido, lo que obligaba a pagar por adelantado capacidad que quizá no usarías
- Controles avanzados como los límites del fragmento y el despliegue propio quedaban en el plan de empresa
Preguntas frecuentes
Preprocess era una API de fragmentación de documentos para pipelines RAG. Leía PDF, archivos de Office, HTML y texto plano, y los partía en fragmentos de texto que seguían la estructura y el sentido del documento, para que cada pieza se pudiera vectorizar e indexar por su cuenta.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Preprocess.
Alternativas a Preprocess

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Knocket
Knocket (Tencent RTC team) · Productividad · Negocios · ChatbotKnocket es una herramienta gratuita de chat en vivo y página de contacto: los visitantes escriben desde tu web, tu app o un enlace, y tú respondes desde Telegram o una sola bandeja.

FloorGen
Vinit Kumar (FloorGen) · Productividad · IA chinaFloorGen es un creador de planos que funciona en el navegador y convierte una frase o un boceto en un plano 2D editable y un recorrido en 3D. Exporta a PDF, DXF o vídeo, y dibujar no exige cuenta.