

Query Memory
Query Memory · Productividad · Aprendizaje
Query Memory es una plataforma de espacio de trabajo unificada para analizar documentos, gestionar datos y desplegar agentes de IA mediante una sola pila basada en API. Reúne el análisis de documentos, la indexación de conocimiento, los endpoints de agentes y el análisis web detrás de una única clave de API, así que los equipos pueden enviar PDF, hojas de cálculo, contratos y correos a sus aplicaciones sin conectar docenas de herramientas sueltas. El público objetivo son desarrolladores y equipos que quieren una capa de memoria central para sus productos de IA, no otro chatbot más.
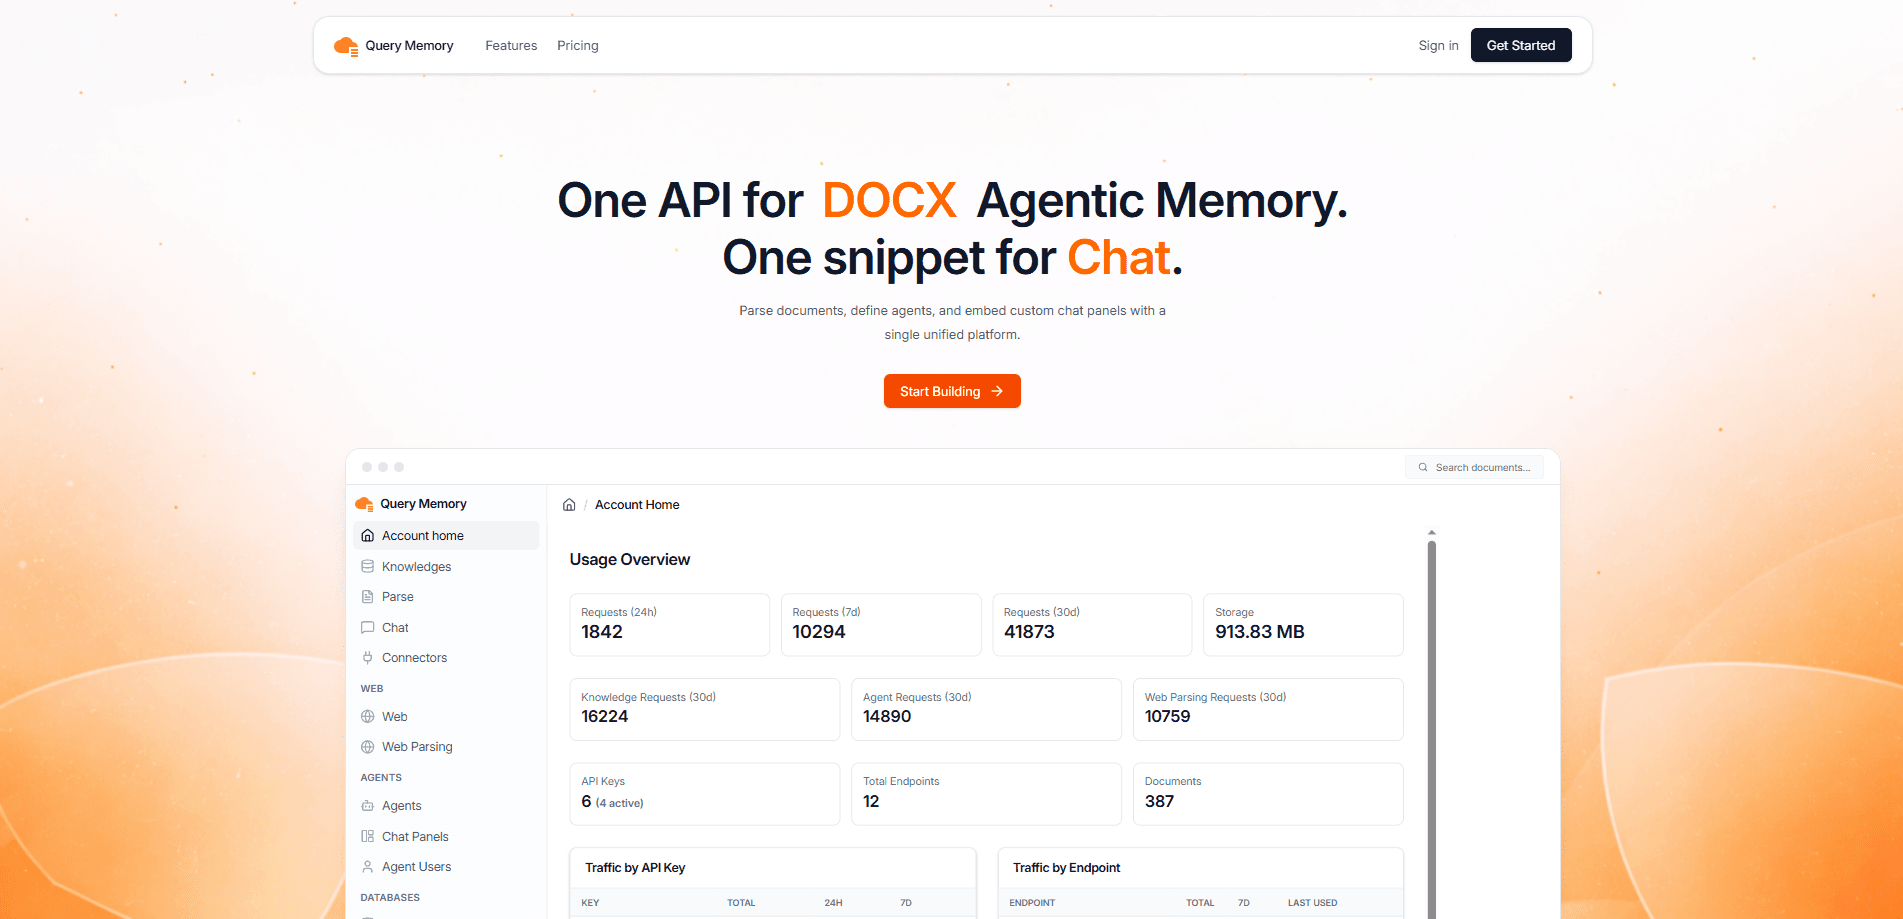
Acerca de Query Memory
Qué es Query Memory
Query Memory es una plataforma basada en API que da a las aplicaciones de IA una capa de memoria. En vez de combinar servicios de OCR, bases de datos vectoriales y entornos de agentes separados, conectas un SDK y llegas a todas las capacidades desde el mismo cliente. La propuesta en su propio sitio es directa: analizar documentos, consultar bases de datos y extraer datos de la web a través de una API unificada.
El problema que resuelve es la fragmentación. Una función de IA típica necesita ingesta de archivos, troceado, recuperación y una respuesta con base documental. Cada uno de esos pasos suele implicar un proveedor distinto y una relación de facturación distinta. Eso se acumula rápido. Query Memory los mete en un solo espacio de trabajo con seguimiento de uso, claves de API y endpoints compartidos entre servicios.
La limitación más clara es la escala y el precio. El plan gratuito es pequeño, con un tope de 25 análisis de documentos y 100 solicitudes de API al mes, y el tráfico real de producción te empuja al plan Pro de 99 $/mes o a un acuerdo Enterprise a medida. También es una plataforma para desarrolladores, así que si no escribes código, todavía no hay mucho aquí para ti.
Primeros pasos
- Crea una cuenta de Query Memory desde la página de registro y abre el panel.
- Genera una clave de API y luego inicializa el SDK con tu URL base y tu clave.
- Sube documentos a una base de conocimiento o envíalos al endpoint de análisis para obtener una salida estructurada.
- Consulta tu conocimiento indexado, llama a un endpoint de agente o lanza una solicitud de análisis web desde el mismo cliente.
- Sigue el uso, el almacenamiento y el tráfico de endpoints desde el panel de la cuenta a medida que crece el volumen.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Query Memory.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores backend y de IA que necesitan ingesta y recuperación de documentos sin montar varios proveedores.
- Equipos de producto que crean asistentes con base documental capaces de citar los documentos de origen.
- Equipos de datos y operaciones que quieren contratos, informes y registros consultables en un solo centro con permisos.
Tareas
- Analizar PDF, archivos DOCX, hojas de cálculo, HTML e imágenes y convertirlos en elementos estructurados limpios.
- Indexar una colección de documentos en una base de conocimiento y consultarla con lenguaje natural.
- Desplegar endpoints de agentes con base documental que responden con fuentes enlazadas.
- Ejecutar extracción web acotada por dominio para llevar contexto externo en vivo a una aplicación.
Casos de uso
- Un equipo fintech que quiere hacer preguntas sobre abstracciones de leasing y archivos de suscripción.
- Un producto de soporte que necesita resumir siniestros y documentos de contratos a demanda.
- Un flujo de investigación que mezcla artículos subidos con páginas web en vivo en una sola consulta.
Funciones clave
API y SDK unificados
Un solo cliente cubre conocimiento, agentes y análisis web, así que inicializas el SDK una vez y reutilizas la misma clave de API en todas partes. El propio enfoque de la empresa es que esto sustituye una pila de herramientas fragmentadas por un único endpoint. Eso importa sobre todo para equipos que, de otro modo, mantendrían tres integraciones y tres juegos de credenciales. Menos piezas móviles. Menos claves que rotar.
Análisis de documentos
Query Memory analiza PDF, DOCX, hojas, HTML, imágenes y texto plano y los convierte en elementos estructurados. El sitio afirma que sus modelos multimodales especializados alcanzan más del 98 % de precisión en diseños complejos, por encima del OCR tradicional y de los LLM genéricos. Toma ese número como una afirmación del proveedor hasta que lo pruebes con tus propios documentos.
Indexación de conocimiento
Los archivos se conectan a bases de conocimiento consultables que admiten recuperación semántica rápida. Las consultas devuelven fragmentos clasificados y el contexto que los rodea, así que puedes dar material con base documental a un modelo en lugar de volcar texto en bruto, y cada centro mantiene permisos para que los documentos sensibles queden acotados a los usuarios correctos.
Endpoints de agentes
Puedes desplegar agentes de IA con base documental con controles de modelo, prompts y respuestas conscientes de las fuentes. Las consultas de los agentes pasan por la misma superficie del SDK. Eso mantiene la integración superficial. Para equipos que lanzan asistentes, elimina la necesidad de alojar y escalar un entorno de agentes aparte.
Análisis web
El análisis web ejecuta extracción acotada por dominio y recuperación clasificada para traer contexto externo en vivo. Usa los mismos formatos de salida que el lado de los documentos. Una página web y un PDF llegan con la misma forma. Esa consistencia es la ventaja práctica cuando combinas fuentes internas y externas.
Conectores e integraciones
La plataforma lista conectores con Microsoft SharePoint, Google Drive, Snowflake, Databricks, Oracle Cloud Infrastructure y Dropbox, además de afirmar que hay 400 más. Esa cobertura deja que los equipos indexen los datos donde ya viven en lugar de migrarlo todo antes. La profundidad de cada conector merece comprobarse por fuente antes de comprometerte.
Uso y visibilidad operativa
El panel muestra solicitudes de 24 horas, 7 días y 30 días, el almacenamiento usado, el tráfico desglosado por clave de API y endpoint, y la actividad reciente del servicio. Para equipos que lo ejecutan en producción, esa visibilidad responde a una pregunta simple. ¿Qué endpoint está subiendo y qué clave lo está haciendo? No es una suite completa de observabilidad. Aun así cubre lo básico que necesitas para ver qué servicio te está costando dinero de verdad.
Ventajas y desventajas
Ventajas
- Una sola clave de API y un solo SDK cubren análisis, conocimiento, agentes y consultas web, lo que recorta el trabajo de integración.
- La salida estructurada se mantiene consistente entre tipos de documentos y páginas web.
- El plan gratuito te deja evaluar la API de análisis de documentos y la API de base de conocimiento antes de pagar.
- Los centros de conocimiento con permisos mantienen los registros sensibles acotados.
- Los conectores con SharePoint, Drive, Snowflake y fuentes similares reducen la migración de datos.
Desventajas
- El plan gratuito es ajustado, con 25 análisis y 100 solicitudes de API al mes, y no aguanta pruebas reales.
- Pro salta a 99 $/mes, y los excesos se facturan según consumo, así que los costos escalan con el uso intenso.
- Es una plataforma para desarrolladores sin una vía no-code relevante, así que los usuarios no técnicos quedan fuera.
- Las afirmaciones de precio y precisión vienen del proveedor, y no hay benchmarks independientes publicados.
Preguntas frecuentes
Es una capa de memoria para aplicaciones de IA. Le envías documentos, bases de datos y fuentes web, y devuelve datos estructurados, conocimiento consultable y respuestas de agentes con base documental a través de una sola API.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Query Memory.
Alternativas a Query Memory

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Knocket
Knocket (Tencent RTC team) · Productividad · Negocios · ChatbotKnocket es una herramienta gratuita de chat en vivo y página de contacto: los visitantes escriben desde tu web, tu app o un enlace, y tú respondes desde Telegram o una sola bandeja.

FloorGen
Vinit Kumar (FloorGen) · Productividad · IA chinaFloorGen es un creador de planos que funciona en el navegador y convierte una frase o un boceto en un plano 2D editable y un recorrido en 3D. Exporta a PDF, DXF o vídeo, y dibujar no exige cuenta.