
StepFun
StepFun · Otro · IA china
Step 3.5 Flash es un modelo fundacional de código abierto de StepFun, construido como un sistema disperso de mezcla de expertos (MoE) que activa solo 11B de sus 196B parámetros por cada token. Ese diseño mantiene fuerte el razonamiento mientras empuja la velocidad de generación a 100–300 tokens por segundo. ¿Quién quiere esperar a un modelo lento? Nadie. Como modelo de agente de IA, encaja en asistentes de programación y trabajo de contexto largo donde la velocidad decide si de verdad usas la herramienta.
Acerca de StepFun
Qué es StepFun Step 3.5 Flash
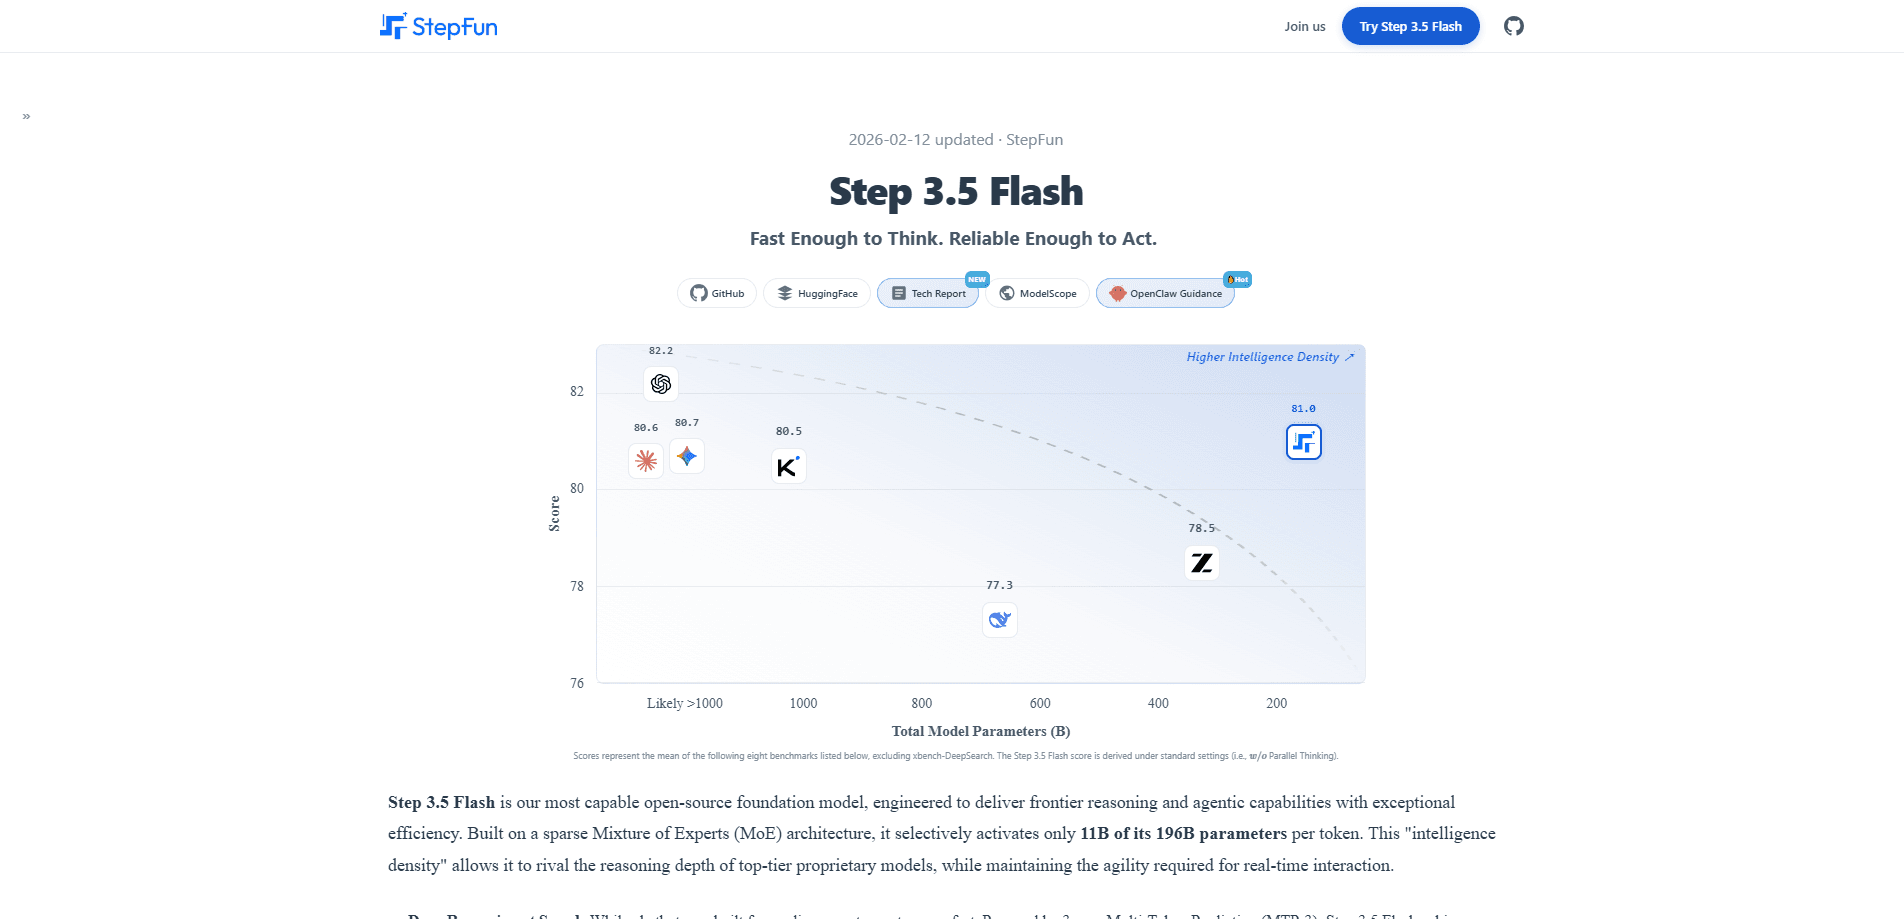
Step 3.5 Flash es un modelo de IA basado en texto que StepFun publicó con pesos abiertos, así que cualquiera puede descargar los archivos y ejecutarlos en local o a través de una API en la nube. Como modelo de IA de código abierto, lo que atrae es la eficiencia sin una gran caída de calidad. En vez de disparar los 196B parámetros en cada token, una capa de enrutamiento elige la pequeña porción de expertos que cada token necesita. StepFun llama a esto "densidad de inteligencia", y los números respaldan la afirmación: una puntuación media de 81,0 en ocho benchmarks, por delante de varios modelos mucho más grandes en la misma comparación.
Para quien construye agentes, las partes prácticas importan más que la diapositiva de arquitectura. Maneja una ventana de contexto de 256K, así que puede sostener una base de código larga o una pila de documentos en una sola pasada. Según StepFun, alcanza el 74,4% en SWE-bench Verified y el 51,0% en Terminal-Bench 2.0, que es el tipo de resultado que quieres cuando un modelo tiene que planificar a lo largo de muchos pasos y llamar herramientas sin desviarse.
Los límites conviene decirlos claramente. Las cifras publicadas de los benchmarks vienen de la propia StepFun. Tómalas como afirmaciones del fabricante hasta que pruebas independientes las confirmen. Además, no tiene comprensión de imágenes integrada en esta versión, así que cualquier cosa visual tiene que pasar por un modelo aparte. Y aunque corre en hardware de consumo de gama alta, "gama alta" hace mucho trabajo ahí: un Mac Studio M4 Max o un NVIDIA DGX Spark, no un portátil típico.
Primeros pasos
- Elige una vía de acceso. Usa la API alojada de StepFun para el arranque más rápido, o baja los pesos abiertos desde GitHub o ModelScope si quieres ejecutarlo en tu propia máquina.
- Consigue una clave de API en la consola de la plataforma StepFun, apunta tu cliente al endpoint compatible con OpenAI (URL base https://api.stepfun.com/v1) y pon el modelo en step-3.5-flash.
- Envía una primera petición con cualquier SDK de estilo OpenAI, empezando por un prompt corto para confirmar que la conexión funciona.
- Para trabajo de agente o de código, conecta el modelo a tu bucle de herramientas y deja que llame a funciones o ejecute código a lo largo de varios turnos.
- Escala. Sube la ventana de contexto para entradas largas y pasa al despliegue local si la privacidad de los datos es prioridad.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de StepFun.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores que construyen agentes
- Ingenieros con necesidades de privacidad
- Investigadores y curiosos
Tareas
- Programación agéntica
- Análisis de contexto largo
- Automatización de alto rendimiento
Casos de uso
- Ejecutar un agente de código toda la noche
- Analizar un conjunto grande de documentos
- Construir un asistente privado
Funciones clave
Arquitectura MoE dispersa con 11B parámetros activos
Step 3.5 Flash mantiene un grupo de 196B parámetros pero solo activa unos 11B por token. Porción pequeña, modelo grande. El resultado se acerca a la velocidad de un modelo pequeño con buena parte de la profundidad de razonamiento de uno grande, que es justo el equilibrio que necesitan las cargas de trabajo de agente.
Generación a alta velocidad con MTP-3
Con predicción de múltiples tokens de 3 vías, el modelo genera 100–300 tokens por segundo en uso normal, con picos cerca de 350 tokens por segundo en tareas de código de un solo flujo. Para quien espera cadenas largas de razonamiento, esa velocidad es la diferencia entre una herramienta que usas y una que evitas.
Contexto de 256K con atención híbrida
El modelo combina atención de ventana deslizante con atención completa en una proporción de 3:1, así que la mayoría de las capas miran una ventana local mientras unas pocas cubren toda la secuencia. Esto mantiene el rendimiento estable en entradas largas mientras recorta el cómputo que suele venir con una ventana de contexto grande.
Buenos benchmarks de código y de agente
Según StepFun, el modelo puntúa 74,4% en SWE-bench Verified y 51,0% en Terminal-Bench 2.0. Esas son las pruebas que siguen si un modelo de verdad termina trabajo de ingeniería real, no solo si responde a preguntas triviales.
Pesos abiertos y despliegue local
Los archivos del modelo están abiertos en GitHub y ModelScope, y corre en hardware como el Mac Studio M4 Max, el NVIDIA DGX Spark y el AMD AI Max+ 395. Ejecutarlo tú mismo significa que tus datos se quedan en local y esquivas del todo las tarifas por token.
API compatible con OpenAI
El endpoint alojado de StepFun habla el formato de la API de OpenAI, así que los SDK y clientes existentes funcionan cambiando la URL base. También hay un nivel gratuito en OpenRouter, que te deja probar configuraciones de agente antes de comprometerte con el uso de pago.
Ventajas y desventajas
Ventajas
- La generación rápida (100–300 tok/s, hasta 350 en código) encaja en agentes y herramientas interactivas.
- La ventana de contexto de 256K maneja bases de código y conjuntos de documentos grandes en una sola petición.
- Los pesos abiertos te dejan ejecutarlo en local y mantener los datos privados.
- Fuertes resultados publicados en benchmarks de código y de terminal.
- La API compatible con OpenAI simplifica la migración desde otros proveedores.
Desventajas
- Las cifras de los benchmarks vienen de StepFun, así que la verificación independiente aún es escasa.
- El despliegue local exige hardware de gama alta, no un portátil estándar.
- Sin comprensión de imágenes ni multimodal integrada en esta versión.
Preguntas frecuentes
Está hecho para tareas que necesitan razonamiento rápido y uso de herramientas, como agentes de código, flujos automatizados y análisis de contexto largo. Su velocidad y su ventana de contexto lo hacen apto para canalizaciones donde muchas peticiones van en secuencia.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con StepFun.
Alternativas a StepFun

Odyssey 3
Odyssey · OtroOdyssey-3 es el modelo del mundo fundacional de Odyssey. Simula física en tiempo real, convierte una descripción en un entorno interactivo y se adapta a robots, coches y videojuegos.

JarvisCore
Prescott Data · Programación · Productividad · OtroJarvisCore es un runtime de código abierto en Python donde los agentes de IA actúan como pares en una malla, reclaman tareas de un libro mayor compartido y llegan a servicios externos por un bróker sin confianza.
Clef
Cloudflare · Negocios · OtroClef es el modelo de decisión de código abierto de Cloudflare para Workers AI. Devuelve probabilidades calibradas para preguntas tipadas en lugar de texto, así que un agente clasifica, enruta y actúa rápido.