
Ultra AI
Ultra AI · Productividad
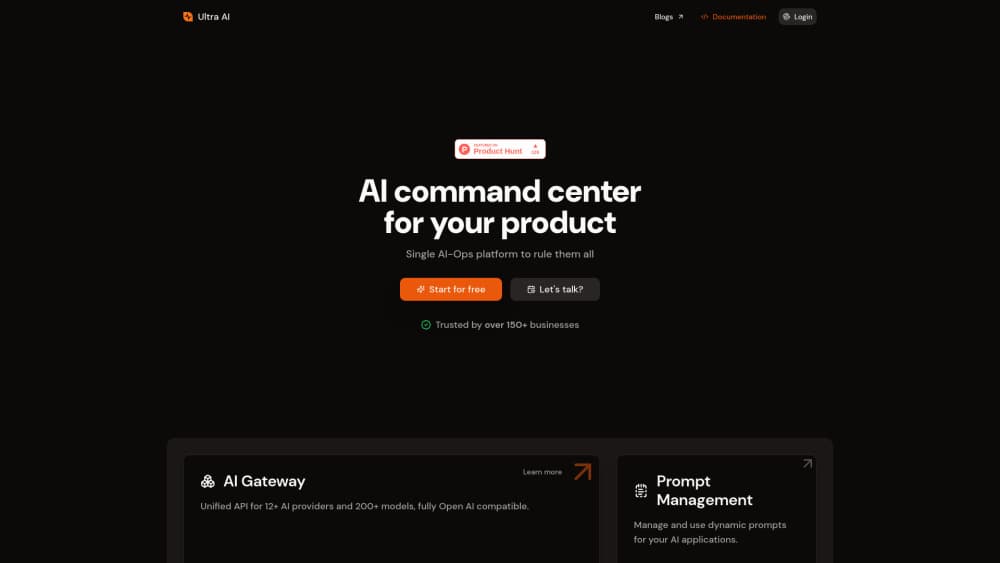
Ultra AI es un centro de control de IA para equipos de producto: una API compatible con OpenAI para varios proveedores, gestión de prompts, caché semántica, fallback de modelos y límites por usuario.
Acerca de Ultra AI
About
Qué es Ultra AI
Ultra AI (UltraAI.app) es una capa de control entre tu aplicación y los proveedores de modelos que llamas. Apuntas el SDK de OpenAI a un único endpoint, indicas qué modelo quieres en cada petición y la pasarela de IA se encarga del resto.
Nació como pasarela multi-proveedor, de esas que ahora se llaman pasarela de IA o LLM gateway, y con el tiempo sumó un pequeño conjunto de herramientas de operación. La gestión de prompts con historial de versiones, los registros y el análisis de uso, la caché semántica, el límite de peticiones por usuario y el failover automático viven en el mismo panel. Para un equipo que lanza una función de IA, eso sustituye una pila de código pegamento que nadie quiere mantener.
El alcance tiene un borde claro. Ultra AI está pensado para quien escribe código. No hay constructor visual de agentes ni interfaz de chat para el usuario final. Si buscas un asistente sin programar, esto no es lo tuyo.
Cómo empezar
- Crea una cuenta en dashboard.ultraai.app y copia una clave de API.
- Cambia la URL base de OpenAI por https://api.ultraai.app/v1. El SDK sigue siendo el mismo.
- Elige proveedor y modelo en cada petición, con una política de caché o un límite por usuario si lo necesitas.
- Revisa registros y gasto en el panel y ajusta el enrutado.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Ultra AI.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores backend
- Fundadores en solitario
- Ingenieros de plataforma
Tareas
- Cambiar de modelo o de proveedor
- Recortar el gasto repetido
- Frenar abusos
Casos de uso
- Un chat de cara al cliente que tiene que aguantar la caída de un proveedor
- Una app multiinquilino donde cada cliente necesita su propia cuota
- Comparar modelos antes de un lanzamiento
Funciones clave
Un endpoint compatible con OpenAI
Todas las peticiones van a https://api.ultraai.app/v1, así que los SDK oficiales de OpenAI funcionan sin cambios. El proveedor y el modelo se nombran dentro de la petición, no en el código. Ese único endpoint explica por qué cambiar de proveedor lleva minutos y no un sprint.
Gestión de prompts con versiones
Los prompts viven en el panel, no repartidos por archivos del repositorio. Los editas, los versionas y los referencias por clave, y los cambios de texto dejan de mezclarse con los despliegues. Quien reescribe instrucciones a diario le saca más partido.
Caché semántica
Hay dos modos y entre los dos cubren casi todo: caché exacta para peticiones idénticas y caché por similitud para prompts que dicen lo mismo con otras palabras. El umbral de similitud y la caducidad se fijan en cada llamada. La empresa habla de hasta 10 veces menos coste en API, una cifra que depende de cuánto se repita tu tráfico.
Registros y analítica
Cada llamada queda registrada con latencia, tokens, coste y la ruta que tomó. Las vistas agregadas muestran el gasto por modelo y la tasa de errores a lo largo del tiempo. Es la parte de observabilidad de IA que casi ninguna pasarela casera incluye, y suele ser el motivo por el que los equipos se quedan con la herramienta.
Fallback de modelos y enrutado
Pones varios modelos en orden de prioridad y la pasarela prueba el siguiente cuando una llamada falla. El failover cubre límites de proveedor, tiempos de espera y errores del servicio. Tus usuarios reciben una respuesta más lenta en lugar de una pantalla de error.
Límite de peticiones por usuario
Los topes se atan al identificador de usuario que envías en cada petición, junto con un número de peticiones y una ventana temporal. Puedes apretar una cuenta concreta sin tocar la configuración global. En productos freemium, eso separa un mal día de un susto en la factura.
Ventajas y desventajas
Ventajas
- Encaja sin fricción en código escrito para OpenAI: cambias la URL base y conservas el SDK.
- Las versiones de prompts y los registros están junto a la pasarela, así que depurar no exige tres herramientas.
- La caché semántica baja el coste del tráfico repetitivo sin tocar la lógica de la app.
- Los límites por usuario y el fallback se configuran por petición, algo que encaja con productos multiinquilino.
Desventajas
- La web pública muestra ahora una página de relleno, así que precios y documentación escasean. Para hablar de presupuesto hay que escribir al equipo.
- Solo para quien programa: no hay constructor visual, ni interfaz de chat, ni nada para compañeros sin perfil técnico.
- La caché y el enrutado añaden un salto, así que la latencia depende del proveedor al que apuntes.
- Los umbrales de caché piden ajuste fino antes de que el ahorro aparezca.
Preguntas frecuentes
Es una pasarela de IA con herramientas alrededor. Tu app manda una petición compatible con OpenAI y Ultra AI la enruta a un proveedor, cachea repeticiones, registra la llamada y aplica límites.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Ultra AI.
Alternativas a Ultra AI

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Knocket
Knocket (Tencent RTC team) · Productividad · Negocios · ChatbotKnocket es una herramienta gratuita de chat en vivo y página de contacto: los visitantes escriben desde tu web, tu app o un enlace, y tú respondes desde Telegram o una sola bandeja.

FloorGen
Vinit Kumar (FloorGen) · Productividad · IA chinaFloorGen es un creador de planos que funciona en el navegador y convierte una frase o un boceto en un plano 2D editable y un recorrido en 3D. Exporta a PDF, DXF o vídeo, y dibujar no exige cuenta.