
CambioML
CambioML · Productivité · Marketing
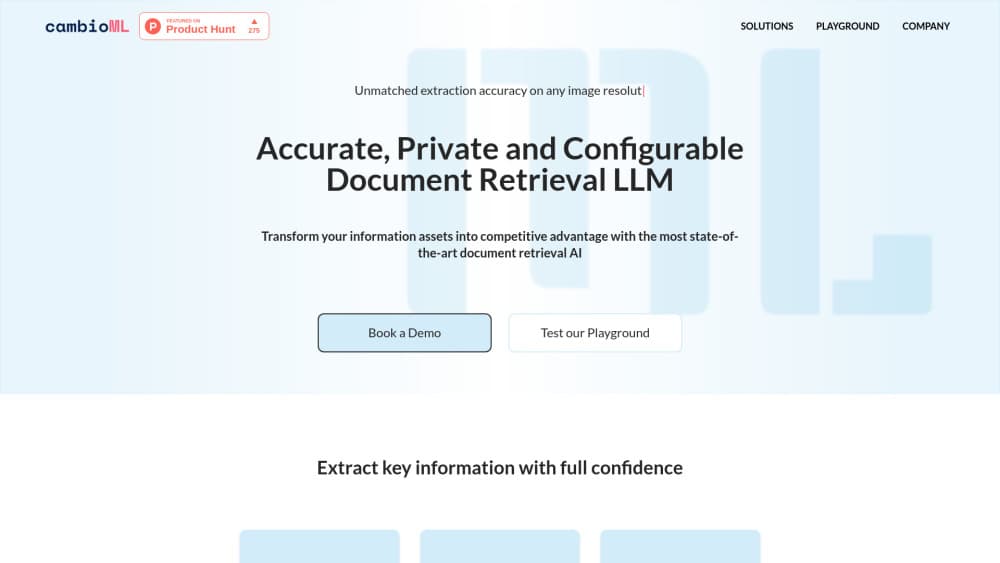
AnyParser est l'API d'analyse de documents de CambioML. Elle transforme PDF, fichiers Word, présentations et images en Markdown, en paires clé-valeur JSON ou en tableaux HTML grâce à des modèles de langage visuel.
À propos de CambioML
About
Qu'est-ce qu'AnyParser
AnyParser est une API doublée d'un SDK Python pour lire les documents que l'extraction de texte classique abîme. Vous envoyez un PDF, un fichier Word, une présentation ou la photo d'une page imprimée, et vous récupérez le contenu en Markdown, titres et ordre de lecture intacts. Vous demandez des tableaux, vous recevez du HTML. Vous demandez des champs, vous recevez du JSON.
Cette API d'analyse de documents repose sur un modèle de langage visuel plutôt que sur la chaîne habituelle OCR et gabarits. Ce choix explique presque tout ce qu'il réussit. Une facture scannée et un rapport né numérique passent par le même appel, sans règle de mise en page à écrire pour chaque nouveau type de document. Pour une équipe qui verse de la paperasse hétérogène dans un moteur de recherche, cela supprime beaucoup de paramétrage.
Les limites tiennent en trois points. La sortie reste une lecture du modèle, donc les tableaux denses et les scans pâles demandent une vérification avant que les chiffres n'atteignent une base de données. Le site anyparser.com affiche aujourd'hui une page d'attente, et le site principal de CambioML met désormais en avant l'automatisation documentaire pour l'assurance : la documentation reste le point d'entrée fiable. Au-delà du gratuit, le tarif se négocie avec le service commercial, pas sur une page de paiement, ce qui ralentit l'estimation du coût.
Pour démarrer
- Créez une clé d'API sur la page de compte CambioML. Chaque compte démarre avec 100 pages offertes, et la clé gratuite traite jusqu'à 10 pages par appel.
- Installez le SDK avec
pip install any-parseret placez la clé dans une variable d'environnement commeCAMBIO_API_KEY. L'API REST existe si vous préférez éviter Python. - Analysez un fichier court en synchrone avec
ap.parse(file_path=...). Le point d'entrée synchrone abandonne au bout de 30 secondes, ce qui convient à un document d'une ou deux pages. - Passez à
async_parsepuisasync_fetchpour les fichiers longs. Le premier appel renvoie un identifiant de fichier, le second rapporte le Markdown une fois le traitement terminé. - Choisissez la sortie utile : Markdown complet, tableaux HTML, clé-valeur JSON ou données personnelles. Surveillez votre solde avec
pageRemainingsur le point d'entrée/query.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de CambioML.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Ingénieurs IA et data
- Équipes opérationnelles noyées sous les formulaires
- Recrutement et RH
Tâches
- Convertir des PDF en Markdown pour une base de connaissances
- Extraire les tableaux de rapports
- Retirer les données personnelles d'un document
Cas d'usage
- Reprendre un fonds documentaire ancien
- Intégrer de l'IA documentaire dans un produit
- Auditer contrats et dossiers en série
Fonctionnalités clés
Analyse complète vers Markdown
L'appel d'analyse renvoie le document entier en Markdown, avec les niveaux de titre, la structure des listes et l'ordre de lecture préservés. Cela compte quand vous comptez découper le texte pour un moteur de recherche, car un export brut perd les frontières de section dont le modèle a besoin. Les appels synchrones prennent les fichiers courts, les asynchrones les longs.
Extraction de tableaux vers HTML
Les tableaux reviennent en HTML plutôt qu'en texte aplati, donc le lien entre lignes et colonnes tient. Vous convertissez ce balisage en dataframe ou l'affichez tel quel. Les tableaux complexes à cellules fusionnées méritent un coup d'œil avant que la donnée ne circule.
Extraction clé-valeur vers JSON
Au lieu du document complet, vous demandez des champs précis et recevez du JSON. Un point d'entrée général côtoie un point d'entrée dédié aux CV, calibré pour ces mises en page, qui renvoie les informations du candidat dans une structure prévisible. C'est le chemin le plus court d'un formulaire à une ligne de base de données.
Extraction des données personnelles
Un point d'entrée dédié sort les informations personnelles identifiantes : nom, téléphone, adresse, e-mail, URL LinkedIn, URL GitHub et un résumé court. Les équipes s'en servent pour repérer les champs sensibles avant de stocker, d'indexer ou de transmettre un document à un autre service. L'extraction ne fait que signaler. Le masquage reste votre étape.
Points d'entrée synchrone, asynchrone et par lots
Trois modes couvrent des tailles de fichier différentes. Le synchrone répond immédiatement et abandonne à 30 secondes. L'asynchrone accepte un envoi, renvoie un identifiant de fichier et livre le résultat lors d'une requête ultérieure. Le mode par lots accepte un dossier, reste en bêta, peut durer jusqu'à 12 heures et exige une autorisation sur votre clé.
SDK Python et accès REST
Le paquet any-parser enveloppe l'API dans un client qui lit la clé dans votre environnement et expose une méthode par tâche. Si vous préférez un autre langage, les points d'entrée REST acceptent le contenu du fichier en base64 et un en-tête x-api-key. La limite est d'une requête par seconde, alors mettez les gros travaux en file.
Avantages et inconvénients
Avantages
- Le gratuit offre 100 pages, de quoi mesurer la sortie sur vos propres documents avant de payer quoi que ce soit.
- Les sorties Markdown, JSON et HTML alimentent directement un moteur de recherche, ce qui réduit le code de liaison entre analyse et recherche.
- L'extraction des données personnelles est intégrée à la même API, sans service d'anonymisation à raccorder.
- Les modes asynchrone et par lots absorbent les fichiers longs que la fenêtre synchrone de 30 secondes ne termine pas.
- Le SDK Python laisse une intégration fonctionnelle en moins de 10 lignes de code.
Inconvénients
- Le tarif au volume se discute avec le service commercial, vous ne pouvez donc pas chiffrer le coût par page depuis le site seul.
- Le point d'entrée synchrone s'arrête à 30 secondes, ce qui renvoie presque tout le travail réel vers le flux asynchrone en deux temps.
- Le traitement par lots est en bêta, plafonné à 12 heures et bloqué tant que le support ne l'a pas activé sur votre clé.
- Une requête par seconde impose d'espacer une reprise massive, ce qui allonge les délais sur de gros fonds.
Questions fréquentes
Il lit des documents et renvoie leur contenu dans un format structuré. Vous choisissez le format : Markdown pour le texte intégral, HTML pour les tableaux ou JSON pour des champs précis et des données personnelles.
Contenus associés
Découvrez des outils, des compétences et des articles liés à CambioML.
Alternatives à CambioML

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Knocket
Knocket (Tencent RTC team) · Productivité · Entreprise · ChatbotKnocket est un outil gratuit de chat en direct et de page de contact : vos visiteurs écrivent depuis votre site, votre application ou un lien, et vous répondez depuis Telegram ou une seule boîte de réception.

FloorGen
Vinit Kumar (FloorGen) · Productivité · IA chinoiseFloorGen est un créateur de plans dans le navigateur qui transforme une phrase ou un croquis en plan 2D modifiable et en visite 3D. Export en PDF, DXF ou vidéo, sans compte pour dessiner.