

Confident AI
Confident AI · Autres
Confident AI est une plateforme d'évaluation de LLM bâtie sur le framework open source DeepEval. Elle sert à tester une application d'IA avant sa mise en ligne, à noter ses réponses avec des métriques issues de la recherche et à suivre le trafic réel ensuite.
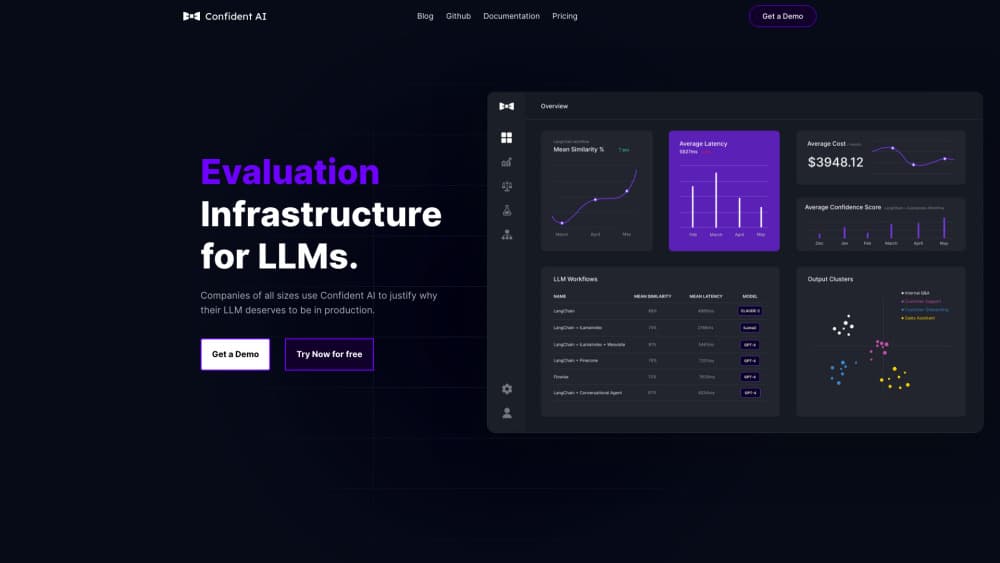
À propos de Confident AI
About
Qu'est-ce que Confident AI
Confident AI est une plateforme web pour tester et surveiller les applications fondées sur des modèles de langage. Elle s'attaque au point qui bloque le plus d'équipes : prouver qu'un chatbot, un pipeline RAG ou un agent fonctionne toujours après une modification de prompt ou un changement de modèle. Vous écrivez vos cas de test en Python ou depuis le navigateur, vous les lancez contre votre application, et vous obtenez une note par métrique avec une justification rédigée pour chaque résultat.
L'entreprise maintient aussi DeepEval, le framework d'évaluation open source qui fournit les métriques de la plateforme. Ce détail compte. Vous pouvez exécuter les mêmes contrôles en local avec DeepEval et envoyer les résultats à Confident AI pour que l'équipe les relise. Rien ne reste enfermé dans la boîte noire d'un fournisseur.
La contrainte la plus dure reste le prix. Le compte gratuit couvre un projet, deux utilisateurs et cinq exécutions par semaine. L'usage sérieux commence au plan Starter, à 200 dollars par mois. Pour des contrôles occasionnels, la facture est difficile à défendre.
Pour commencer
- Créez un compte gratuit sur confident-ai.com et copiez la clé d'API depuis les réglages du projet.
- Installez le SDK avec
pip install -U deepeval, puis lancezdeepeval loginpour relier le framework local à votre projet hébergé. - Définissez métriques et cas de test dans un fichier Python, ou créez-les dans le navigateur via le parcours sans code si vous avez un plan payant.
- Lancez les tests, consultez les notes par métrique dans le tableau de bord et partagez le lien du rapport avec votre équipe.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Confident AI.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Ingénieurs IA qui construisent des pipelines RAG ou des agents
- Chefs de produit responsables de fonctions d'IA
- Équipes QA qui passent aux tests de LLM
Tâches
- Repérer les hallucinations avant publication
- Comparer deux configurations de modèle ou de prompt
- Transformer les incidents de production en cas de test
- Mener un red teaming sur un chatbot client
Cas d'usage
- Une startup qui change de modèle chaque semaine
- Une entreprise qui harmonise les critères entre plusieurs équipes produit
- Un bot de support déjà en production
Fonctionnalités clés
Bibliothèque de métriques adossée à la recherche
La plateforme embarque plus de 50 métriques d'évaluation de l'IA construites sur DeepEval, pour les échanges simples comme pour les conversations à plusieurs tours. On y trouve la pertinence de la réponse, la fidélité, la précision et le rappel de contexte, l'hallucination, le biais, la toxicité et des contrôles propres aux agents comme le bon usage des outils. Si aucune métrique standard ne convient, les métriques G-Eval personnalisées vous laissent décrire le critère en langage naturel.
Simulation de conversations multi-tours
Plutôt que de juger une réponse isolée, le simulateur déroule une conversation entière contre votre application et note le fil complet. Cela fait ressortir les défaillances qui n'apparaissent qu'après plusieurs échanges, comme un bot qui oublie une contrainte acceptée plus tôt. Vous définissez le persona et l'objectif, la plateforme génère les tours.
Tests de régression en CI/CD
Les tests de régression de LLM s'exécutent dans GitHub Actions, GitLab CI, Jenkins ou tout pipeline capable d'appeler l'API. Une métrique en échec peut bloquer un merge comme un test unitaire cassé. Chaque exécution est conservée, ce qui vous permet de comparer les versions et de repérer le moment précis où une note a chuté.
Observabilité de l'IA sur le trafic réel
Le traçage enregistre chaque requête, span et fil de votre application en production, puis y attache les notes des métriques. Vous filtrez les traces par note faible, vous repérez les dérives dans le temps et vous posez des alertes sur les réponses répétées ou les signaux de frustration. Les spans OpenTelemetry sont conservés si vous venez d'un autre outil.
Annotation humaine et alignement des métriques
Les files d'annotation laissent vos experts métier relire les sorties selon vos propres critères. La plateforme compare ensuite leurs étiquettes aux notes et montre où les deux divergent. Cet écart est la partie utile : il indique si une métrique est trop indulgente avant que vous en fassiez un garde-fou de release.
Parcours sans code et accès MCP
Sur les plans payants, vous pouvez pointer les évaluations vers un endpoint en direct, remodeler la réponse et planifier des exécutions récurrentes sans écrire de code. Un serveur MCP autorise aussi les agents de Cursor ou de Claude Code à lancer des évaluations et à récupérer les résultats depuis l'éditeur.
Avantages et inconvénients
Avantages
- DeepEval est open source : vous exécutez les contrôles en local et inspectez le code des métriques au lieu de faire confiance à un moteur de notation fermé.
- Chaque note s'accompagne d'une explication, ce qui rend les échecs analysables par des personnes qui n'ont pas écrit le test.
- Traçage et évaluation cohabitent au même endroit, donc les données de production deviennent des cas de test sans friction.
- Les intégrations couvrent la pile courante : OpenAI, Claude, Gemini, Bedrock, LangChain, LlamaIndex, CrewAI et OpenTelemetry.
- Les contrôles entreprise incluent SSO, RBAC personnalisé, SOC 2, HIPAA et déploiement on premise.
Inconvénients
- Le plan gratuit plafonne à un projet, deux utilisateurs et cinq exécutions par semaine, de quoi essayer le produit et guère plus.
- L'usage réel en équipe démarre à 200 dollars par mois, un montant difficile pour un développeur seul ou un petit projet.
- L'évaluation sans code, les évaluations en ligne et les alertes sont payantes, donc le niveau gratuit suppose encore que vous êtes à l'aise en Python.
- Les appels au modèle juge sont à votre charge, et un gros jeu de données avec un modèle puissant fait vite monter la facture.
Questions fréquentes
Il teste et surveille des applications de LLM. Vous définissez des cas de test et des métriques, vous les lancez contre votre application et vous recevez des notes expliquées. La même plateforme surveille ensuite le trafic réel et note les requêtes entrantes.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Confident AI.
Alternatives à Confident AI

Odyssey 3
Odyssey · AutresOdyssey-3 est le modèle du monde fondationnel d'Odyssey. Il simule la physique en temps réel, transforme une consigne en environnement interactif et s'adapte aux robots, voitures et jeux.

JarvisCore
Prescott Data · Programmation · Productivité · AutresJarvisCore est un runtime Python open source où les agents IA travaillent en pairs sur un maillage, prennent les tâches dans un registre partagé et joignent les services externes via un broker zero trust.
Clef
Cloudflare · Entreprise · AutresClef est le modèle de décision open source de Cloudflare pour Workers AI. Il renvoie des probabilités calibrées pour des questions typées au lieu de texte, ce qui permet à un agent de classer, router et agir vite.