
Hasura
Hasura · Programmation
Hasura est une plateforme de supergraphe pilotée par les métadonnées qui relie vos bases de données, votre code et vos API et les expose comme des endpoints GraphQL rapides et sécurisés.
À propos de Hasura
What Is Hasura
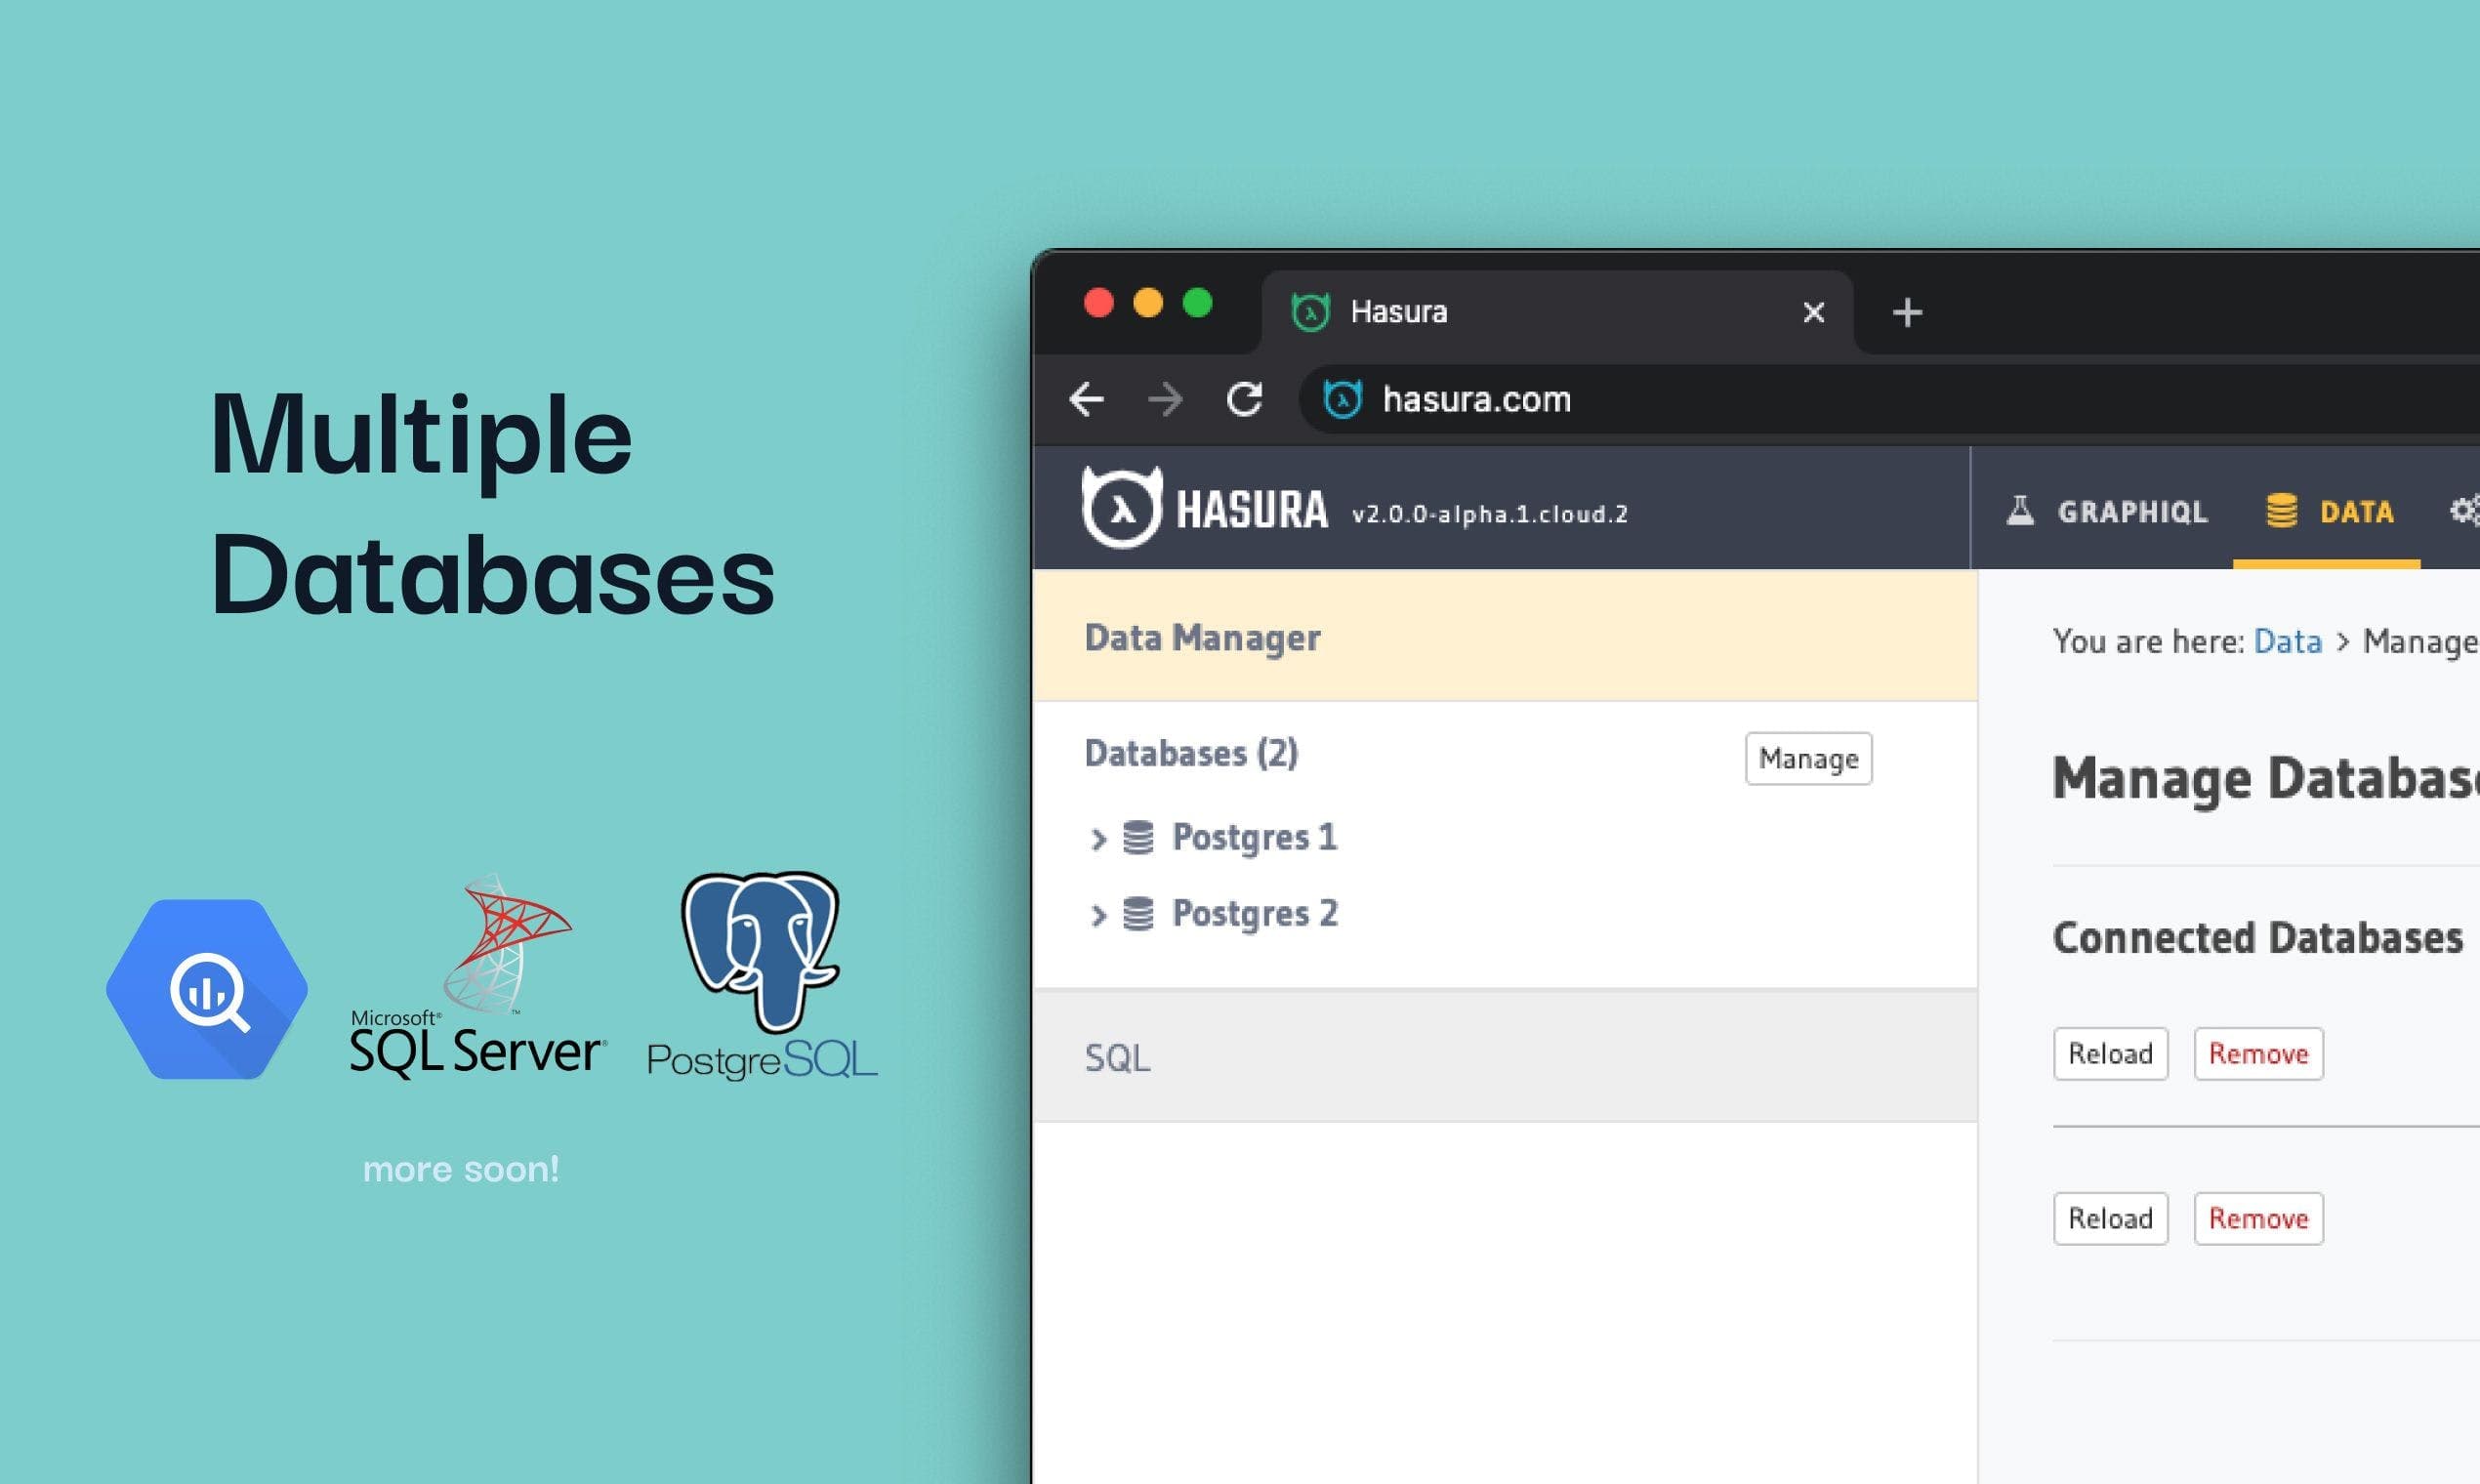
Hasura est une couche d'accès aux données placée entre vos sources de données et vos applications. Vous pointez ses connecteurs vers des bases de données, des microservices et des API tierces, vous décrivez dans les métadonnées la façon dont les données se relient, et Hasura compile le tout en une seule API GraphQL. Son produit phare aujourd'hui est la Hasura Data Delivery Network (DDN), un supergraphe qui réunit de nombreuses sources derrière un seul endpoint. L'entreprise développe aussi PromptQL, une couche d'IA pour interroger ces données en langage naturel, et elle maintient le moteur GraphQL Engine open source avec lequel le projet a démarré.
Le fonctionnement habituel vise les équipes qui stockent leurs données dans Postgres, MySQL, SQL Server, Snowflake, BigQuery ou Oracle et veulent une API sans écrire de resolver pour chaque table. Hasura prend en charge les filtres, la pagination, le tri, les agrégations et l'autorisation au-dessus de ces sources, et vous ajoutez les relations dans les métadonnées plutôt que dans le code. Cela débloque des choses plus pénibles à faire à la main. Les permissions au niveau du champ et de l'entité vivent dans le moteur, donc les règles d'accès restent au même endroit. L'API parle aussi Relay pour les clients fondés sur les connexions et gère le versionnement d'API et les builds hachés pour des changements de schéma sûrs.
Il y a des coûts à peser. La DDN est un produit cloud managé, et bien l'utiliser suppose d'apprendre son modèle de métadonnées et sa CLI, ce qui marque un vrai écart avec un simple client SQL. Le prix compte les modèles actifs, pas les sièges, donc un schéma large avec beaucoup de modèles interrogés peut faire grimper la facture. Le moteur écrit en Rust est rapide, mais la courbe d'apprentissage et le déploiement uniquement managé de la DDN restent les principaux compromis.
Getting Started
- Créez un compte Hasura Cloud gratuit et ouvrez la console
- Installez la CLI DDN et Docker, puis initialisez un supergraphe avec
ddn supergraph init - Ajoutez des connecteurs de données pour chaque source, comme une base Postgres ou une API REST
- Modélisez vos données dans les métadonnées, définissez les relations et les permissions, déployez et appelez l'endpoint GraphQL généré
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Hasura.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs backend et full-stack
- Équipes plateforme
- Équipes data en grande entreprise
- Équipes qui construisent des fonctions d'IA
Tâches
- Créer une API GraphQL
- Fédérer des sources de données
- Mettre en place l'autorisation
- Des changements de schéma sûrs
- Auto-héberger le moteur
Cas d'usage
- Une startup lance le backend de sa première app
- Une entreprise consolide l'accès
- Une équipe ajoute un assistant d'IA
- Un changement de schéma est risqué
- Une entreprise régulée a besoin de résidence des données
Fonctionnalités clés
Un supergraphe construit à partir des métadonnées
Hasura DDN est une couche d'accès aux données pilotée par les métadonnées. Vous décrivez la forme de vos données une fois et le moteur génère l'API à partir de cette description, pas d'un code écrit à la main. Le résultat est un supergraphe qui réunit de nombreuses sources derrière un endpoint, avec filtres imbriqués, pagination et tri, plus les agrégations prêtes à l'emploi. D'après Hasura, le compilateur et le runtime en Rust le rendent plus rapide que le moteur v2, que l'entreprise qualifiait déjà de moteur GraphQL le plus rapide.
Des connecteurs pour bases, code et API
Les connecteurs de données sont la façon dont la DDN atteint chaque source. Hasura fournit des connecteurs officiels pour PostgreSQL, Microsoft SQL Server, CockroachDB, ClickHouse, MongoDB, Snowflake et d'autres, ainsi que des connecteurs de code et d'API pour les fonctions Lambda et les services REST. Ils suivent la spécification ouverte Native Data Connector (NDC), donc vous pouvez créer votre propre connecteur et intégrer une source que l'ensemble officiel ne couvre pas. Héberger des connecteurs tiers et de code coûte 0,075 $ par vCPU-heure et 0,0075 $ par GiB-heure.
API GraphQL et Relay
Chaque modèle rejoint une API GraphQL compatible avec les filtres, la pagination et le tri, plus les agrégations, et la même couche expose une API Relay pour les clients fondés sur les connexions. Filtres imbriqués, agrégations imbriquées, pagination imbriquée et tri imbriqué sont de série, ce qui réduit les allers-retours d'un client. L'offre gratuite inclut déjà ces fonctions d'API sans limite de requêtes par mois.
Autorisation fine
Les permissions vivent dans le moteur à deux niveaux. Les règles au niveau du champ contrôlent les colonnes qu'un rôle peut lire ou écrire, et les règles au niveau de l'entité contrôlent les lignes visibles. Vous définissez la logique de façon déclarative dans les métadonnées, donc la table, la vue ou la fonction devant chaque champ de l'API est protégée de la même manière partout. Pour les équipes aux exigences d'accès strictes, une seule couche d'autorisation supprime la dérive qui s'installe quand chaque service impose ses propres règles.
Collaboration fédérée et CI/CD multi-dépôts
L'offre Advanced ajoute la collaboration fédérée et la CI/CD multi-dépôts, pour que plusieurs équipes travaillent sur des sous-graphes indépendants et les fusionnent en un supergraphe. La détection de changements incompatibles, les builds immuables et les URL de build permettent de tester un changement isolé avant qu'il n'atteigne la production. Le registre de schémas et le changelog gardent trace de ce qui a changé et quand, ce qui compte dès que plusieurs équipes possèdent l'API.
Observabilité et statistiques d'usage
Les traces, les métriques de performance de l'API et les statistiques d'usage des modèles et des champs font partie de la console. L'offre gratuite conserve traces et métriques pendant 15 minutes, tandis que les offres payantes portent la rétention à 30 jours. Les statistiques d'usage des modèles et des champs viennent avec les offres payantes et montrent quelles parties du schéma servent vraiment, ce qui aide à décider quoi garder. La mise à l'échelle automatique, le démarrage sans attente et un réseau mondial en périphérie avec routage géographique sont inclus dans toutes les offres.
Auto-hébergement et développement local
Tout n'a pas besoin de tourner dans le cloud Hasura. Vous pouvez auto-héberger le moteur GraphQL Engine v3, exécuter les mêmes outils en local avec Docker et développer contre un supergraphe sur votre machine avant le déploiement. La CLI DDN gère l'initialisation, la configuration des connecteurs et le déploiement dans un seul flux. Cela compte pour les équipes qui doivent garder des données sensibles sur leur propre infrastructure sans renoncer aux outils managés.
PromptQL pour l'accès aux données par IA
PromptQL est la couche d'IA de Hasura pour travailler avec le supergraphe. Au lieu de coder à la main des requêtes SQL ou GraphQL, vous posez vos questions en langage naturel et PromptQL planifie et exécute les requêtes nécessaires pour y répondre. Il s'appuie sur la même couche d'accès aux données, donc les permissions et les relations déjà définies continuent de s'appliquer. Pour les équipes qui ajoutent un assistant ou une app de données, cela transforme le supergraphe en quelque chose qu'un système d'IA peut appeler directement.
Avantages et inconvénients
Avantages
- Un supergraphe piloté par les métadonnées transforme de nombreuses sources en un endpoint GraphQL sans resolvers écrits à la main
- Les connecteurs officiels et communautaires couvrent les principales bases de données, plus le code et les API REST via la spécification ouverte NDC
- L'autorisation vit dans le moteur au niveau du champ et de l'entité, donc les règles sont au même endroit plutôt que dans chaque service
- La CI/CD avec détection de changements incompatibles et builds immuables rend la publication de changements de schéma plus sûre
- Une offre gratuite couvre les requêtes illimitées et les fonctions d'API de base, donc les petits projets démarrent sans payer
Inconvénients
- La DDN est un produit managé avec une vraie courbe d'apprentissage, et le modèle de métadonnées et la CLI demandent du temps
- Le prix compte les modèles actifs plutôt que les sièges, donc un schéma large avec beaucoup de modèles interrogés fait vite monter la facture
- Héberger des connecteurs tiers et de code est facturé à l'heure, ce qui pèse sur les services toujours actifs
- L'auto-hébergement utilise le moteur GraphQL Engine v3, donc les équipes qui veulent l'expérience DDN complète restent dans le cloud Hasura
Questions fréquentes
Hasura est une couche d'accès aux données qui transforme les bases de données, le code et les API en une seule API GraphQL. Les équipes s'en servent pour monter des backends d'applications, fédérer des données de nombreuses sources et appliquer les permissions au même endroit, sans écrire de resolvers pour chaque table.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Hasura.
Alternatives à Hasura

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.
Together Link
Together AI · ProgrammationTogether Link est un outil gratuit et open source de Together AI qui relie des agents de code comme Claude Code et Codex à des modèles ouverts, avec un routeur automatique et un reçu de coût par session.
HeyPi
Proactive Intelligence Ltd. · Programmation · Productivité · EntrepriseHeyPi est une plateforme de réunion IA où un assistant nommé Pi écoute l'appel, retient le contexte des séances précédentes, travaille dans vos applications connectées et construit pages, présentations et vidéos en direct.