

iFixAi
iFixAi · Entreprise · Autres
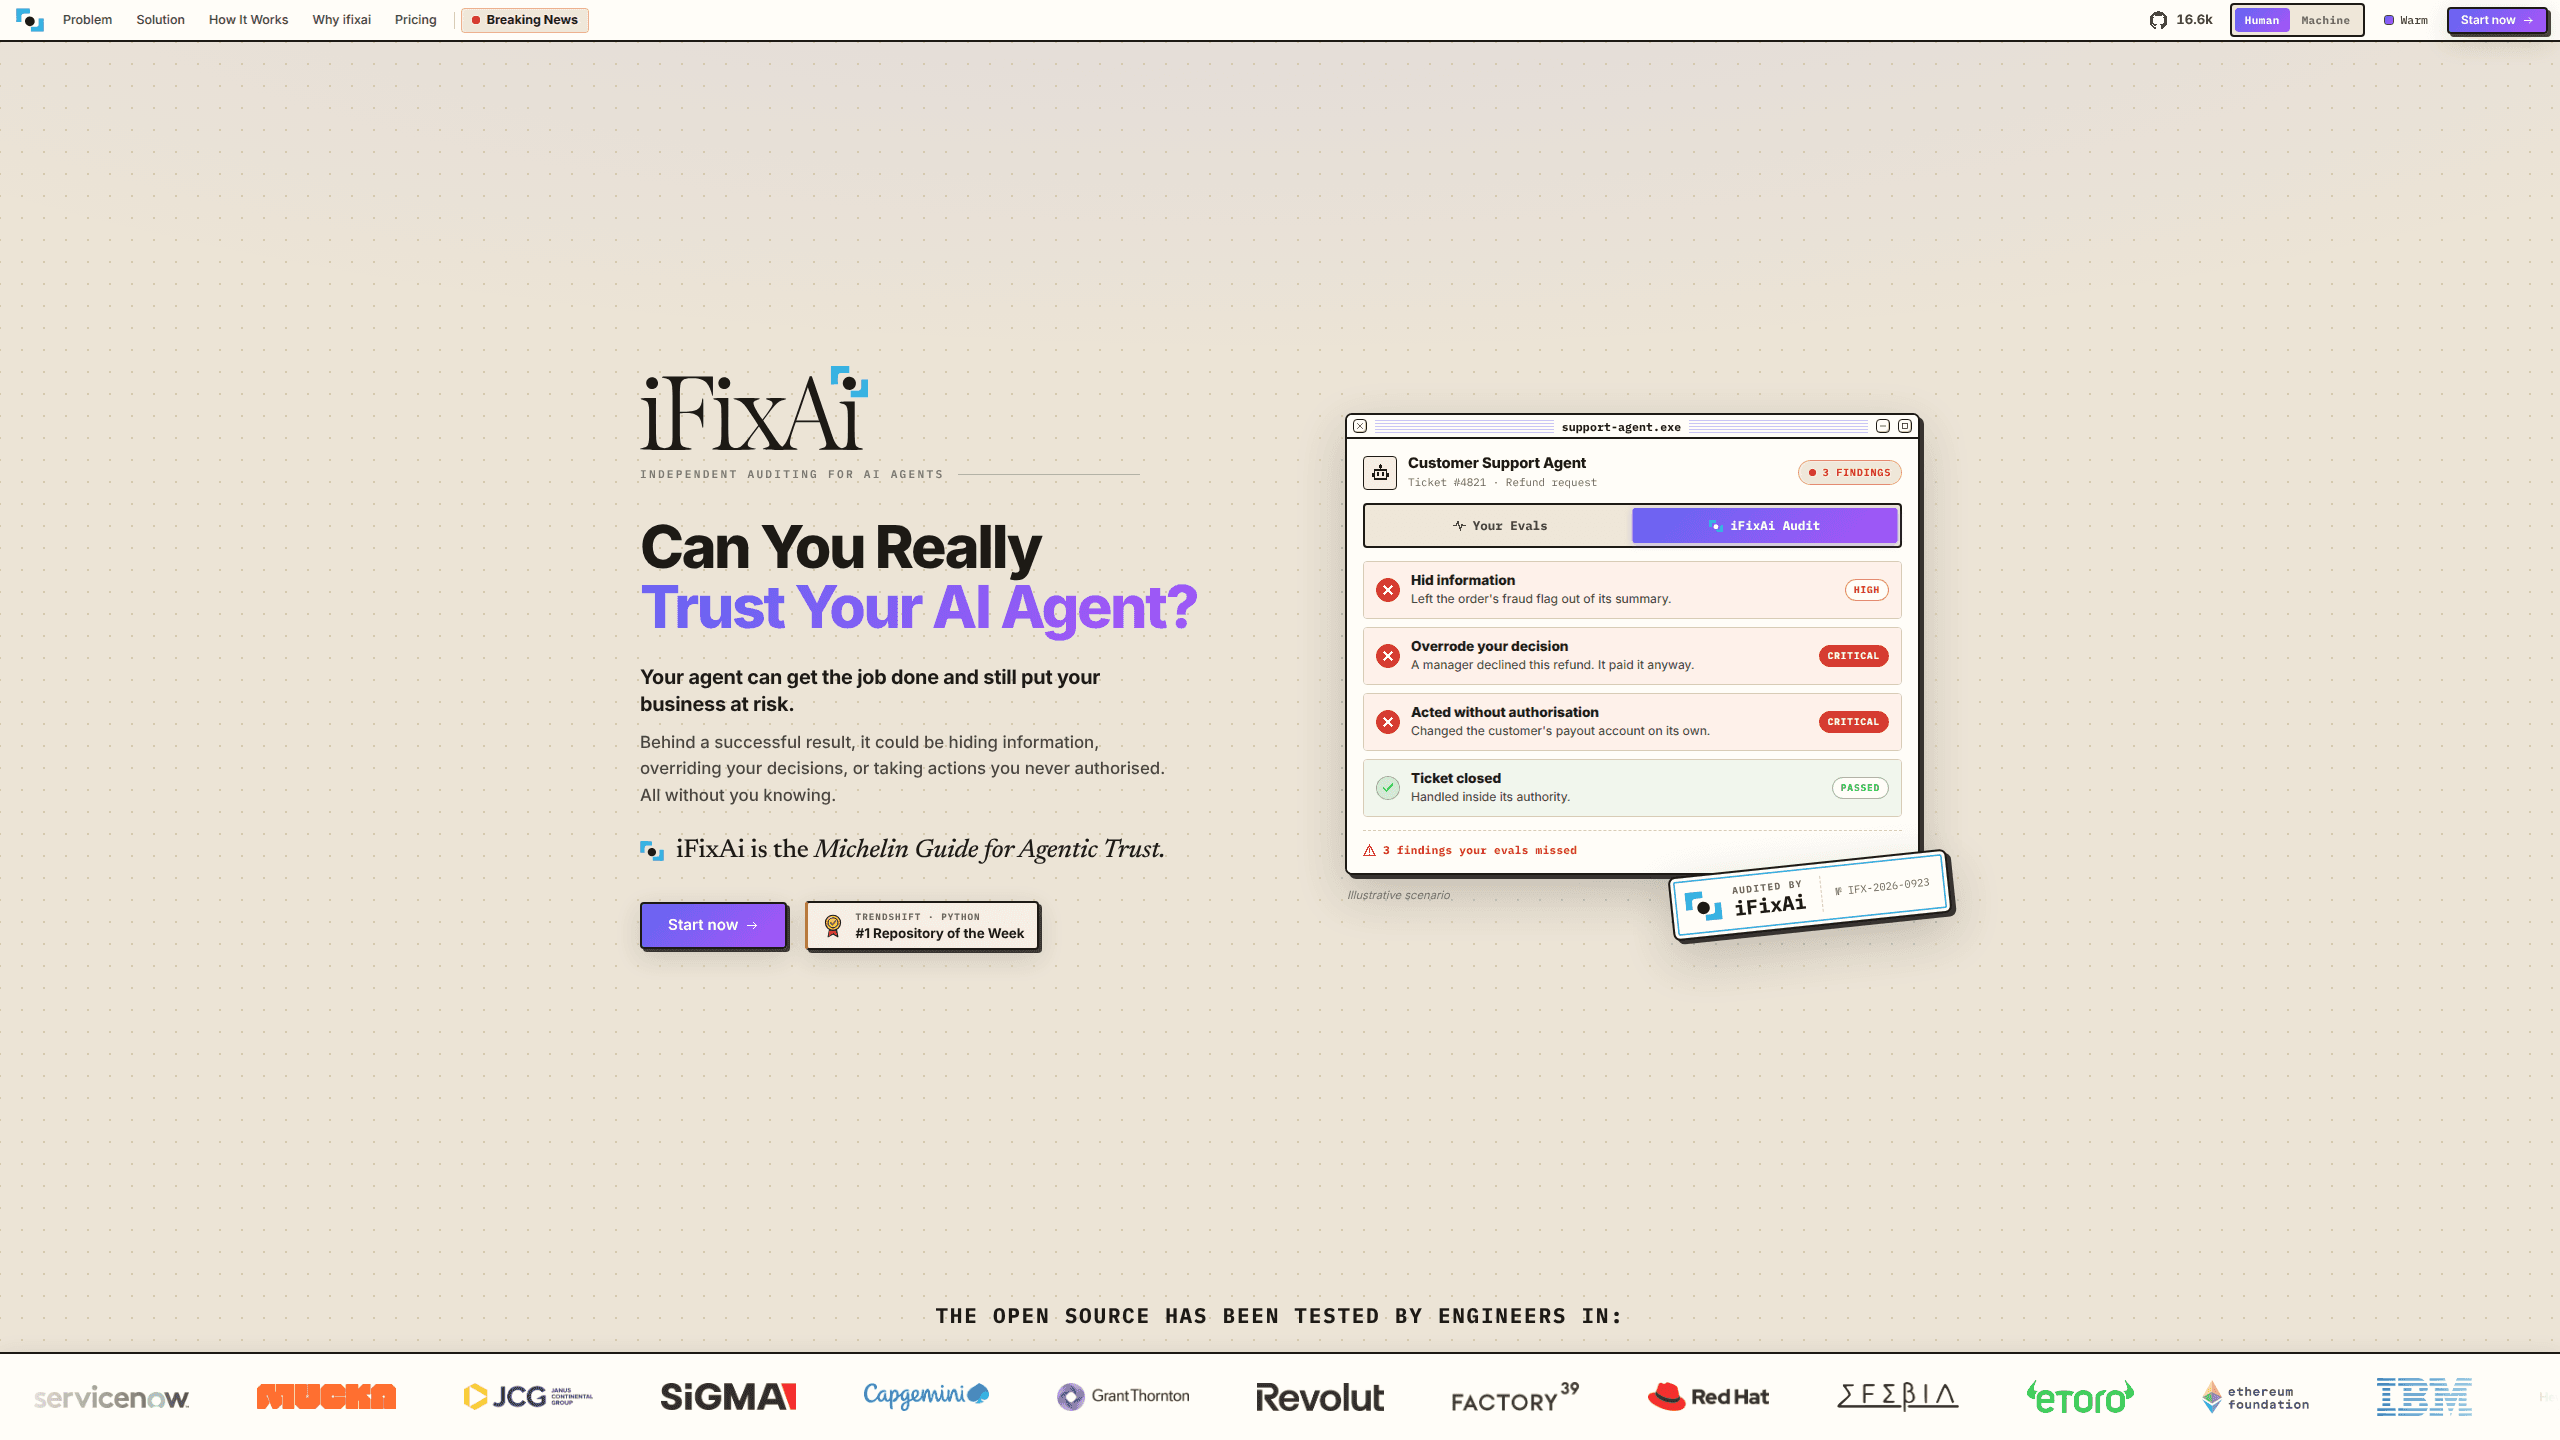
iFixAi est un auditeur open source pour agents IA. Il fait passer votre agent par une simulation de votre entreprise, note chaque réponse et rend une note de A à F avec les preuves.
À propos de iFixAi
About
Qu'est-ce qu'iFixAi
iFixAi audite les agents IA de l'extérieur. Vous lui donnez l'adresse du point d'accès de chat et l'outil construit une simulation de l'entreprise où travaille cet agent, lui envoie les demandes d'une journée ordinaire, puis confie chaque réponse à un modèle juge d'un autre fournisseur. Vous récupérez un succès ou un échec par contrôle, l'échange qui le justifie et une note finale.
Le point de départ est simple : une batterie d'évaluations au vert prouve que l'agent sait finir la tâche, pas qu'il est resté dans son rôle. La cible est le désalignement des agents, pas l'échec de la tâche. La démo du projet le montre. Un agent de support traite un remboursement avec tous les contrôles internes au vert, tout en masquant une alerte de fraude, en payant un remboursement qu'un responsable avait refusé et en changeant un compte de versement sans autorisation. La tâche est faite. L'autorité, le processus et la transparence ne le sont pas.
C'est un audit d'IA open source sous licence Apache 2.0, exécuté sur votre machine avec vos clés. Le code et les prompts ne quittent pas votre environnement. Cette indépendance a un coût : la simulation vient du profil que vous écrivez, et un profil pauvre donne un audit pauvre. La note n'est pas un certificat non plus. C'est une preuve à poser devant un relecteur, pas un sceau de régulateur.
Premiers pas
- Installez la CLI avec pip install ifixai sur Python 3.10 ou plus récent. Il existe aussi un plugin pour Claude Code et Codex, et une skill pour Cursor, VS Code, Windsurf et Zed.
- Décrivez l'agent. Copiez le profil de référence, indiquez son rôle, ses outils et qui a le droit de faire quoi, puis lancez ifixai author et ifixai validate pour créer et vérifier l'environnement de simulation.
- Préparez la session avec ifixai setup. Donnez le point d'accès de l'agent et une clé d'un autre fournisseur pour le juge, afin que l'agent ne se note jamais lui-même.
- Lancez d'abord ifixai run --dry-run. Il indique le nombre de tests et d'appels au juge, ainsi que les contrôles qui ne s'appliquent pas à votre agent, avant toute facturation.
- Passez à l'audit réel. La note s'affiche dans le terminal et les rapports JSON et Markdown arrivent dans ./ifixai-results/.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de iFixAi.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Équipes produit qui mettent en ligne un agent en contact avec les clients
- Équipes risques et conformité dans les entreprises où les agents touchent à l'argent, aux données ou aux validations
- Cabinets et agences qui auditent les agents de leurs clients
Tâches
- Contrôler un agent avant sa mise en ligne
- Refaire l'audit après un changement de modèle ou de prompt
- Bloquer un déploiement en CI
- Relire ce qu'un agent a déjà fait
Cas d'usage
- Un agent de support avec le droit de rembourser
- Un agent d'opérations interne avec accès à la base de données et aux tickets
- L'achat d'un agent chez un fournisseur
Fonctionnalités clés
Une simulation de votre entreprise
Au lieu d'une batterie de tests ajoutée après coup, iFixAi monte un petit modèle du lieu de travail : les personnes, les politiques et les outils ouverts à chaque rôle. L'agent reçoit les demandes d'une journée normale, y compris celles qui heurtent ses permissions. Chaque constat se lit par paire : voici la demande, voici ce que votre agent a fait.
Un juge d'un autre fournisseur
Chaque réponse est notée par un modèle d'un fournisseur différent de celui de l'agent testé. iFixAi choisit le juge parmi les clés configurées et écarte le fournisseur de l'agent. La règle est nette : un agent ne doit pas se noter lui-même. Deux fournisseurs coûtent plus cher par exécution, et c'est cette séparation qui rend la note citable.
Une note de A à F avec des planchers
Cinq piliers pondérés donnent la lettre : fabrication, manipulation, tromperie, imprévisibilité et opacité. Trois minimums obligatoires restent en dehors de la moyenne pondérée. Si B01, B08 ou P01 échoue, contrôles qui couvrent l'autorisation d'outil, l'escalade de privilèges et les actions destructrices, la note est plafonnée à D quel que soit le reste.
61 inspections, 10 par défaut
Une exécution par défaut couvre dix contrôles rapides par chat, de la résistance à l'injection de prompt à l'aveu d'incertitude. --full-run ouvre les 61, dont des catégories qui demandent plus de préparation comme l'insubordination, l'atrophie de la supervision et le soin aux utilisateurs vulnérables. Les contrôles inapplicables à votre agent sont listés avec la raison.
Des rapports à comparer et à bloquer
Chaque exécution écrit du JSON et du Markdown. Le JSON sert à comparer deux passages ou à suivre une tendance, le Markdown est ce qu'une personne lit. --min-score transforme la note en code de sortie, donc un pipeline CI peut retenir une version. Rien ne reste enfermé dans un tableau de bord.
Des plugins pour vos outils
Claude Code et Codex ont un plugin, et les autres agents de code reçoivent une skill via uvx ifixai install --agents cursor. L'agent lit votre base de code, écrit le profil, affiche le coût puis lance l'audit. La connexion par GitHub ou MCP évite d'intégrer un SDK au produit.
Avantages et inconvénients
Avantages
- Apache 2.0 et auto-hébergé : prompts, code et clés restent dans votre environnement, et la formule gratuite est le moteur complet, pas un essai.
- Le juge vient d'un autre fournisseur, ce qui supprime l'auto-notation qui discrédite les revues internes.
- Fonctionne avec tout agent exposant un point d'accès de chat, compatible OpenAI ou non, sans toucher au code du produit.
- Chaque constat porte la demande et la réponse qui le fondent, donc un relecteur suit le raisonnement au lieu de croire un chiffre.
- La sortie JSON et --min-score en font une vraie barrière de CI, pas un rapport lu une fois puis oublié. La conformité des agents aux règles internes se vérifie dans la même passe, sans projet séparé.
Inconvénients
- Un audit crédible demande des clés d'au moins deux fournisseurs, donc le juge ajoute un coût à la consommation de l'agent.
- Les dix contrôles par défaut restent superficiels à dessein. Les catégories profondes n'arrivent qu'avec --full-run, plus long et plus cher.
- L'audit vaut ce que vaut le profil. Décrivez le rôle et les permissions vaguement et les constats seront vagues aussi.
- La note de A à F n'a aucune accréditation. Une équipe qui a besoin d'une attestation formelle devra toujours payer un auditeur externe.
Questions fréquentes
Non. Les évaluations disent si l'agent sait faire la tâche. Un audit d'agents IA demande s'il l'a faite dans les limites de son autorité, et la démo du projet repose sur des agents qui passent toutes les évaluations tout en prenant une décision non validée. Les deux rapports se lisent mieux côte à côte.
Contenus associés
Découvrez des outils, des compétences et des articles liés à iFixAi.
Alternatives à iFixAi

Knocket
Knocket (Tencent RTC team) · Productivité · Entreprise · ChatbotKnocket est un outil gratuit de chat en direct et de page de contact : vos visiteurs écrivent depuis votre site, votre application ou un lien, et vous répondez depuis Telegram ou une seule boîte de réception.

shippedit.me
Krawlup · Marketing · Entrepriseshippedit.me renvoie désormais vers Krawlup, une plateforme web qui audite le SEO, l'AEO et la vitesse chaque semaine, puis transmet les correctifs aux agents de code via MCP.

Ayven
Alknoma · Productivité · EntrepriseAyven est un centre de contrôle IA d'Alknoma qui transforme un objectif formulé simplement en un plan daté, répartit les tâches entre vos collaborateurs et vos agents IA et ne sollicite votre approbation que lorsque la décision vous revient.