
LLM Gateway
The Open Co · Autres
LLM Gateway est une passerelle IA open source qui achemine les requêtes vers plus de 250 modèles de 40 fournisseurs via un point d'accès compatible OpenAI, avec bascule, cache et suivi des coûts.
À propos de LLM Gateway
What Is LLM Gateway
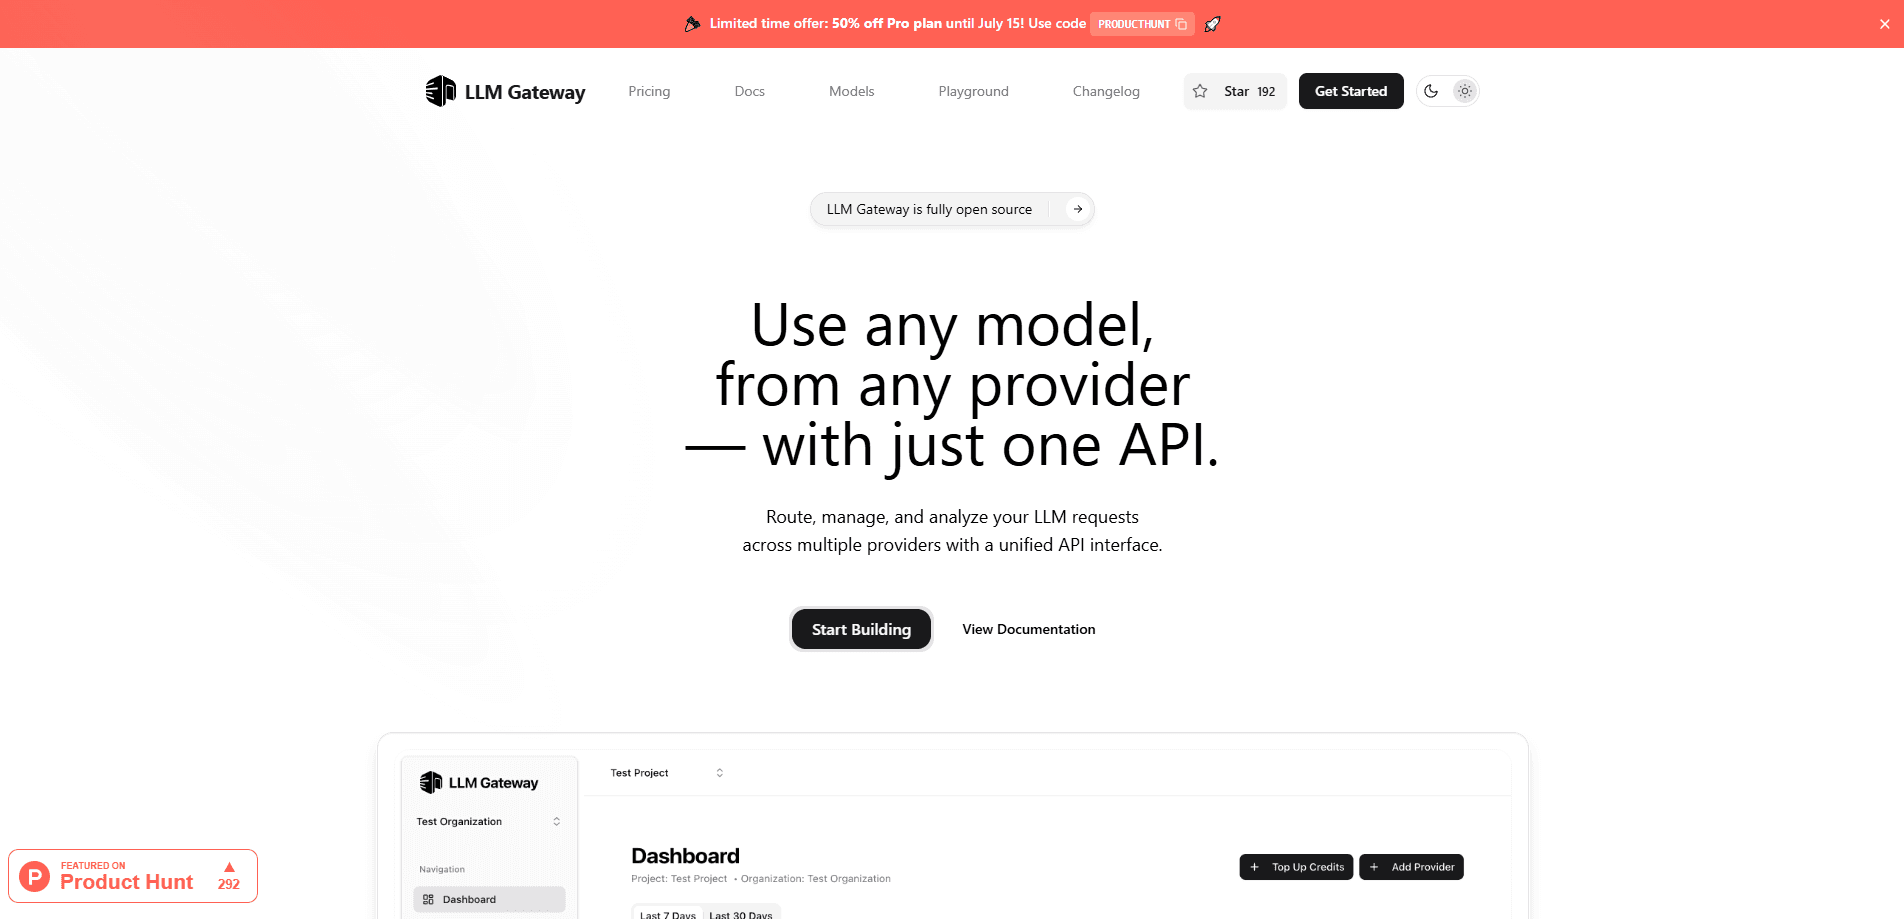
LLM Gateway est une couche intermédiaire placée entre votre application et les fournisseurs de modèles. Vous pointez votre SDK OpenAI vers une seule URL de base, gardez une seule clé d'API et appelez le modèle de votre choix. La passerelle transmet la requête à un fournisseur, puis renvoie la réponse dans le format que votre code attend déjà.
Le problème qu'elle résout, c'est la dispersion des fournisseurs. Dès qu'un projet touche OpenAI, Anthropic, Google et un hébergeur de modèles ouverts, vous vous retrouvez avec des clés, des SDK et des factures séparés. LLM Gateway agit comme une passerelle API IA unique qui donne un accès multi-fournisseurs aux modèles : changer de modèle devient une modification de chaîne, pas une réécriture.
Le projet est open source sous AGPLv3, ce qui compte si vous préférez garder les prompts dans votre propre réseau. Vous pouvez passer par le cloud géré ou exécuter le même code vous-même comme proxy LLM auto-hébergé, avec Docker, Compose ou Kubernetes. La contrepartie : en auto-hébergeant, la disponibilité et les mises à jour reviennent à votre équipe, et l'offre gratuite repose sur le support communautaire.
Getting Started
- Connectez-vous au tableau de bord, créez un projet, puis copiez la clé d'API générée.
- Exportez la clé sous
LLM_GATEWAY_API_KEYdans votre shell ou un fichier.env. - Remplacez l'URL de base de votre SDK OpenAI par
https://api.llmgateway.io/v1et gardez votre code. - Appelez un modèle par son nom, comme
gpt-4o, et laissez la passerelle choisir le fournisseur. - Suivez la latence, le coût et la répartition par fournisseur dans le tableau de bord, puis ajoutez cache ou bascule à mesure que le trafic grandit.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de LLM Gateway.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs backend et plateforme
- Équipes produit IA
- Équipes d'ingénierie soucieuses de la confidentialité
Tâches
- Changer de modèle sans réécrire le code
- Surmonter la panne d'un fournisseur
- Maîtriser les dépenses IA
Cas d'usage
- Faire tourner un chatbot multi-fournisseurs en production
- Prototyper sur des modèles gratuits
- Garder les données chez soi
Fonctionnalités clés
One OpenAI-Compatible Endpoint
La passerelle parle le format de l'API OpenAI, si bien que les complétions de chat, les embeddings, les images, la voix et la transcription passent par votre SDK actuel. Le routage de modèles selon le prix, la latence ou la disponibilité se règle depuis le tableau de bord. Vous changez l'URL de base et le nom du modèle, rien de plus. Pour une équipe déjà sur le SDK OpenAI, c'est toute la migration.
Smart Routing and Automatic Fallback
Les requêtes peuvent être routées selon le prix, la latence, le débit ou la disponibilité, et vous pouvez épingler un fournisseur précis avec la forme fournisseur/modèle. Une requête qui ne nomme qu'un modèle est réessayée chez un autre fournisseur qui le sert quand le premier échoue. Vous pouvez bloquer cela avec l'en-tête X-No-Fallback: true si vous préférez une erreur nette.
Response Caching
Les requêtes répétées peuvent être servies depuis un cache adossé à Redis, ce qui réduit à la fois la latence et la dépense sur des prompts identiques. Les contrôles de cache du fournisseur passent aussi, donc vous conservez son propre comportement. Les applications à fort volume le remarquent d'abord sur la facture.
Guardrails and PII Protection
La passerelle applique une protection contre l'injection de prompts, la détection et le masquage des données personnelles, la détection de secrets et un moteur de règles maison, en périphérie. La politique s'exécute au même endroit que traverse chaque requête, et non dans chaque app. Les équipes qui manipulent des données sensibles y gagnent un point de contrôle unique.
Centralized Key Management
Les clés de fournisseur sont stockées chiffrées et associées à des clés d'API par projet qui portent plafonds d'usage et de dépense et pistes d'audit complètes. Vous faites tourner les clés sans toucher au code de l'application. C'est la fonction qui évite qu'une équipe qui grandit se passe des clés de fournisseur en clair.
Cloud or Self-Hosted Deployment
Vous pouvez utiliser la passerelle gérée ou exécuter le code AGPLv3 sur votre propre infrastructure avec Docker, Compose ou Kubernetes. L'auto-hébergement est gratuit et tout, du routage aux analyses, fonctionne pareil. Le choix se résume à qui vous voulez voir assumer la disponibilité.
Avantages et inconvénients
Avantages
- Un seul point d'accès compatible OpenAI couvre plus de 250 modèles de 40 fournisseurs, donc changer de modèle revient à modifier une chaîne.
- La bascule et la nouvelle tentative automatiques gardent les requêtes en vie quand un fournisseur est limité ou hors service.
- Le cache de réponses et les plafonds de dépense par clé donnent un contrôle direct sur le coût de l'IA.
- Le cœur AGPLv3 peut être auto-hébergé, ce qui garde prompts et réponses dans votre propre réseau.
- Les garde-fous contre l'injection de prompts, les données personnelles et les secrets s'exécutent dans la passerelle, pas dans chaque app.
Inconvénients
- Les crédits à l'usage portent une commission fixe de 5% en plus des tarifs par token du fournisseur, donc l'usage géré coûte plus cher que d'appeler les fournisseurs en direct.
- L'auto-hébergement transfère disponibilité, mises à jour et montée en charge à votre équipe, ce qui représente un vrai travail d'exploitation.
- L'offre gratuite est limitée et repose sur le support communautaire, donc les équipes en production finissent par payer ou auto-héberger.
Questions fréquentes
Elle sert à appeler de nombreux modèles d'IA avec une seule API. Au lieu d'intégrer OpenAI, Anthropic, Google et les autres un par un, vous envoyez les requêtes à un unique point d'accès compatible OpenAI et laissez la passerelle gérer le routage.
Contenus associés
Découvrez des outils, des compétences et des articles liés à LLM Gateway.
Alternatives à LLM Gateway

Odyssey 3
Odyssey · AutresOdyssey-3 est le modèle du monde fondationnel d'Odyssey. Il simule la physique en temps réel, transforme une consigne en environnement interactif et s'adapte aux robots, voitures et jeux.

JarvisCore
Prescott Data · Programmation · Productivité · AutresJarvisCore est un runtime Python open source où les agents IA travaillent en pairs sur un maillage, prennent les tâches dans un registre partagé et joignent les services externes via un broker zero trust.
Clef
Cloudflare · Entreprise · AutresClef est le modèle de décision open source de Cloudflare pour Workers AI. Il renvoie des probabilités calibrées pour des questions typées au lieu de texte, ce qui permet à un agent de classer, router et agir vite.