

LLMWare.ai
LLMWare.ai · Programmation · Autres
LLMWare.ai conçoit Model HQ, une plateforme sans code pour exécuter des flux IA privés sur votre matériel avec plus de 250 petits modèles de langage, le RAG sur appareil et sans coût par token.
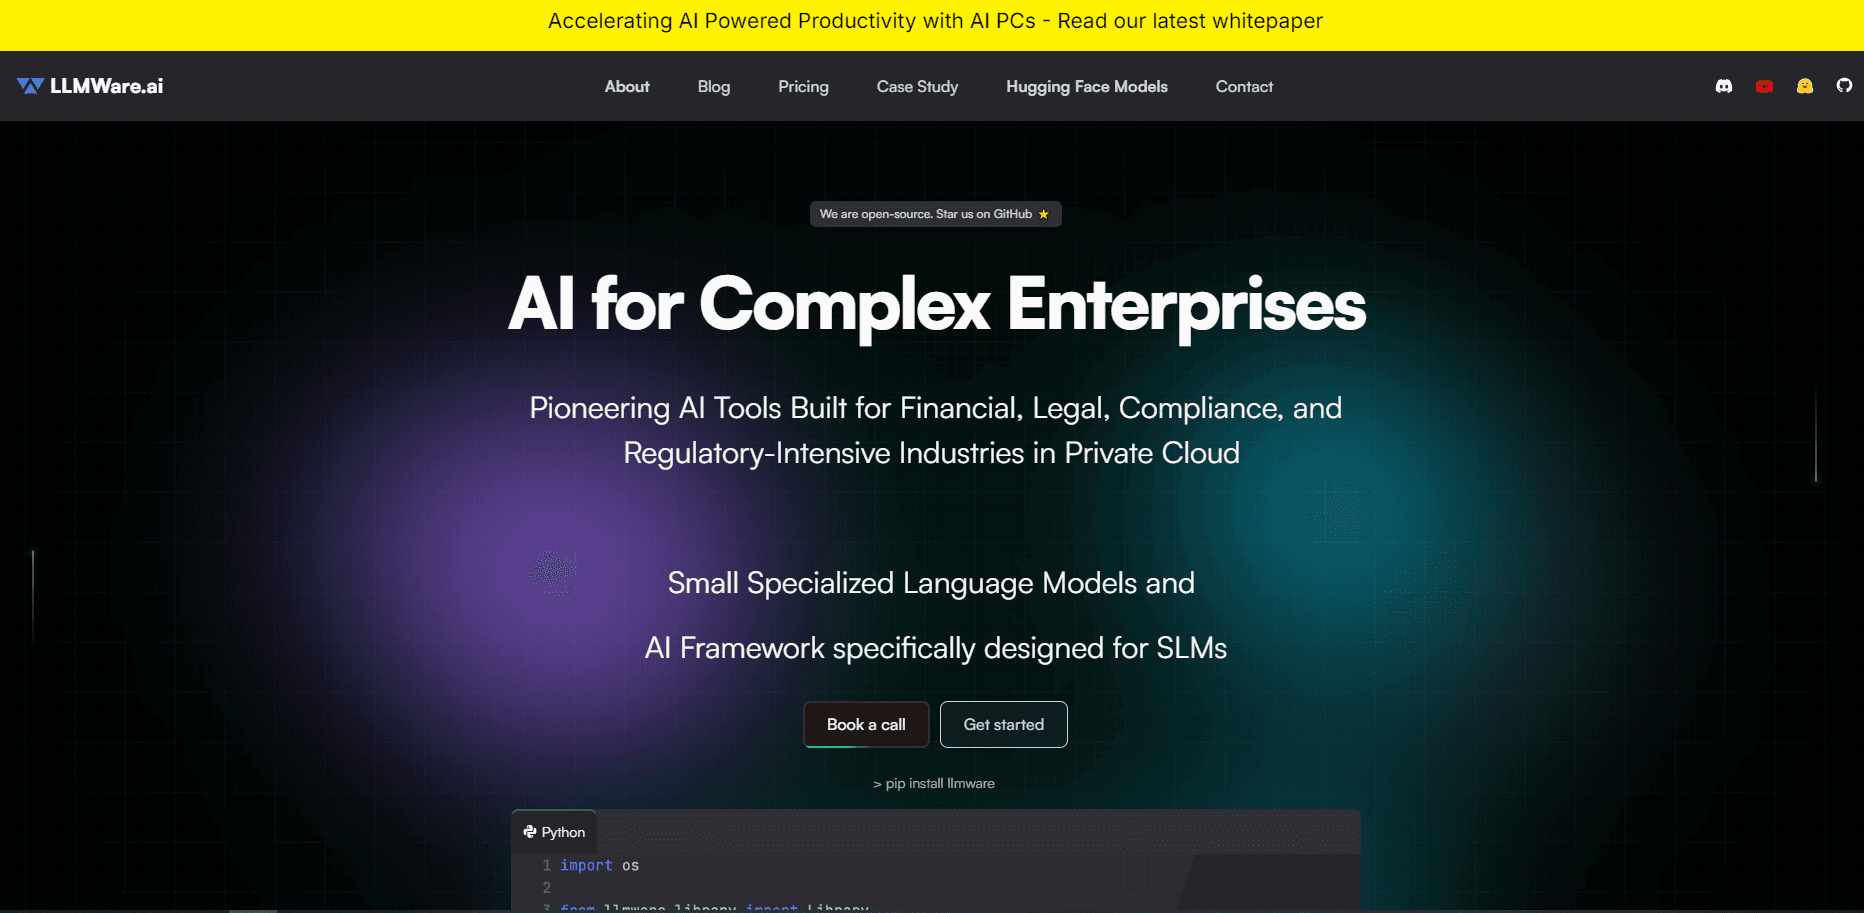
À propos de LLMWare.ai
What Is LLMWare.ai
LLMWare.ai est l'entreprise derrière Model HQ, un moteur de flux IA privés qui fait tourner des modèles de langage sur votre propre ordinateur portable, AI PC ou centre de données plutôt que dans le cloud d'un autre. Il est né du framework open source llmware, une bibliothèque Python pour construire des applications de génération augmentée par récupération (RAG) avec de petits modèles spécialisés. L'équipe maintient les deux : le framework pour les développeurs et Model HQ comme produit prêt à l'emploi.
L'argument du local est simple. Les documents sensibles restent dans votre périmètre de sécurité, il n'y a pas de facturation au token et le système fonctionne sans connexion pour la plupart des flux. Cela convient aux équipes de la finance, du juridique, de l'assurance et de la conformité, où envoyer des contrats ou des dossiers clients à une API publique est hors de question. L'entreprise le résume sans détour : possédez votre IA et gardez les données là où elles vivent.
Le revers, c'est que les modèles locaux sont plus petits. Model HQ fait tourner des modèles jusqu'à 32B paramètres sur les AI PC actuels, assez pour le travail documentaire, la classification et l'extraction structurée, mais pas le plafond des plus grands modèles du cloud. Vous installez aussi un agent client au lieu de vous connecter à un site, et les modes de déploiement les plus complets passent par un échange commercial.
Getting Started
- Téléchargez l'agent client Model HQ, environ 200 Mo, sur votre AI PC ou votre portable
- Lancez-le et choisissez un modèle dans le catalogue de plus de 250 petits modèles de langage
- Pointez-le vers vos fichiers ou connectez une source de données pour créer une base de connaissances sur l'appareil
- Enchaînez modèles, données et logique dans un flux de travail, puis lancez-le à la demande ou selon un planning
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de LLMWare.ai.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Équipes de secteurs réglementés
- Responsables sécurité et IT
- Développeurs d'apps RAG
- Petites et moyennes équipes
Tâches
- Traitement de documents
- Recherche documentaire sur l'appareil
- Extraction de données structurées
- Flux IT et support
- Automatisation planifiée
Cas d'usage
- Relecture juridique ou financière
- Sites isolés ou mal connectés
- Déploiement d'AI PC
- Dossiers RH ou médicaux sensibles
- Prototyper avant de passer à l'échelle
Fonctionnalités clés
Générateur de flux sans code
Model HQ vous laisse monter des flux IA à plusieurs étapes sans écrire de code. Vous enchaînez modèles, sources de données et logique dans un processus répétable, du simple résumé jusqu'à une chaîne qui lit un document, en extrait des champs et oriente un résultat. Le produit dépasse alors le chatbot : il exécute des tâches métier de bout en bout. L'entreprise présente ce générateur comme la pièce qui ouvre l'automatisation par l'IA à ceux qui ne touchent jamais à Python.
Plus de 250 petits modèles de langage
La plateforme embarque un catalogue de plus de 250 petits modèles de langage, conditionnés dans des formats quantifiés pour tourner sur le GPU et le NPU de l'appareil. On y trouve la famille SLIM (Structured Language Instruction Models) pour l'appel de fonctions et la classification, les modèles DRAGON réglés pour les questions-réponses en RAG, et les BLING pour les prototypes rapides. Elle prend aussi en charge les principaux modèles cloud d'OpenAI, Anthropic et Google, pour mixer local et cloud là où chacun a du sens.
RAG et recherche documentaire sur l'appareil
Model HQ intègre un pipeline de génération augmentée par récupération, la même technologie que le framework open source llmware. Vous pointez vers un dossier de PDF, de documents Word ou de tableurs ; le système les analyse, les découpe en segments et les indexe, puis répond en s'appuyant sur ce contexte. L'entreprise le relie à plusieurs bases de données vectorielles, dont FAISS, Milvus, Pinecone, Qdrant, Postgres (PG Vector), Redis et Chroma, pour les équipes qui en utilisent déjà une.
Tourne sur du matériel AI PC
L'agent client est conçu pour exploiter le silicium déjà présent dans un portable moderne. Il tourne sur CPU, GPU et NPU, et il est optimisé pour les puces d'Intel, AMD, Apple, NVIDIA et Qualcomm Snapdragon. L'entreprise cite des temps de téléchargement moyens d'environ 10 secondes pour l'app et de moins de 30 minutes pour un ensemble de modèles sur un appareil. Les modèles jusqu'à 32B paramètres tournent sur les AI PC les plus récents, donc vous obtenez des capacités utiles sans serveur.
Zéro coût par token et aucune dépendance au cloud
Comme l'inférence tourne sur votre matériel, il n'y a pas de facturation au token ni de facture d'API mesurée. L'entreprise estime le coût incrémental attendu par token sur un AI PC à $0. La plupart des flux tournent sans connexion réseau, ce qui compte pour les équipes terrain, les sites sécurisés et ceux qui préfèrent ne pas dépendre d'un service externe disponible. Vos données restent dans votre environnement par défaut.
Options de déploiement privé
Model HQ est pensé pour tourner à trois endroits : sur les AI PC, dans votre centre de données pour l'inférence par lots et le RAG sur données sensibles, ou dans un cloud privé pour les opérations importantes et sensibles au temps. Les trois peuvent se relier pour un montage mixte, de sorte que l'agent du portable puise dans un déploiement central quand il a besoin de modèles plus grands. Les entreprises peuvent créer des apps d'agents IA et les déployer sur les appareils de leurs équipes.
Outils de sécurité IA pour l'entreprise
La plateforme regroupe les contrôles qu'un acheteur réglementé réclame : explicabilité de l'IA, filtrage des données personnelles, suivi de la toxicité et des biais, et détection des hallucinations. Les déploiements en entreprise ajoutent la supervision, les mises à jour et la montée en charge sur un parc matériel varié. Avec l'exécution sur l'appareil, cela donne aux équipes de conformité de quoi répondre sur le parcours des données et ce que le modèle a vu.
Avantages et inconvénients
Avantages
- Tourne en local, donc les documents sensibles ne quittent jamais votre périmètre et il n'y a pas de frais au token
- Le générateur sans code ouvre les flux IA à plusieurs étapes à ceux qui ne programment pas, pour des agents IA sans code en IA privée et en IA locale
- Prend en charge à la fois de petits modèles locaux et de grands modèles cloud, pour mixer selon les besoins
- Fournit un large catalogue de modèles spécialisés pour le RAG, la classification et l'appel de fonctions
- Se déploie sur AI PC, centres de données et cloud privé depuis une seule plateforme, avec une porte d'entrée gratuite
Inconvénients
- Les modèles locaux plafonnent autour de 32B paramètres, donc les tâches de raisonnement les plus dures favorisent encore les grands modèles cloud
- Vous installez et gérez un agent client, ce qui demande plus de travail que d'ouvrir un site
- Le déploiement complet en centre de données et cloud privé passe par un échange commercial, donc le prix n'est pas public
- La plupart des flux fonctionnent sans réseau, mais les plus grands modèles et les intégrations cloud ont encore besoin d'une connexion
Questions fréquentes
LLMWare.ai est une entreprise d'IA qui conçoit Model HQ, un moteur de flux IA privés pour faire tourner des modèles de langage sur votre propre matériel. Elle maintient aussi le framework open source llmware en Python pour construire des applications RAG. Elle se concentre sur les secteurs sensibles aux données, comme les services financiers, le juridique et l'assurance.
Contenus associés
Découvrez des outils, des compétences et des articles liés à LLMWare.ai.
Alternatives à LLMWare.ai
Octri.dev
Octri, LLC · ProgrammationOctri.dev transforme une spécification OpenAPI en site de documentation, SDK clients en dix langages, serveur MCP pour agents IA et supervision de production de ces SDK.
CoreSpeed
CoreSpeed · Programmation · ProductivitéCoreSpeed est un serveur MCP qui fournit aux agents IA des applications connectées, une mémoire partagée et des milliers d'outils intégrés derrière une seule connexion, avec des crédits et des plafonds de dépense à chaque appel.
Blume 2.0
Hayden Bleasel · Rédaction · ProgrammationBlume 2.0 est un framework de documentation open source qui transforme un dossier de Markdown en site Astro rapide, avec recherche locale, références d'API et serveur MCP pour les agents.