
Magma
Microsoft Research · Autres
Magma est le modèle de base de Microsoft pour les agents d'IA multimodaux. Il lit images, vidéos et textes, puis propose des actions comme cliquer sur un bouton ou déplacer un bras robotique, dans le monde numérique comme physique.
À propos de Magma
What Is Magma
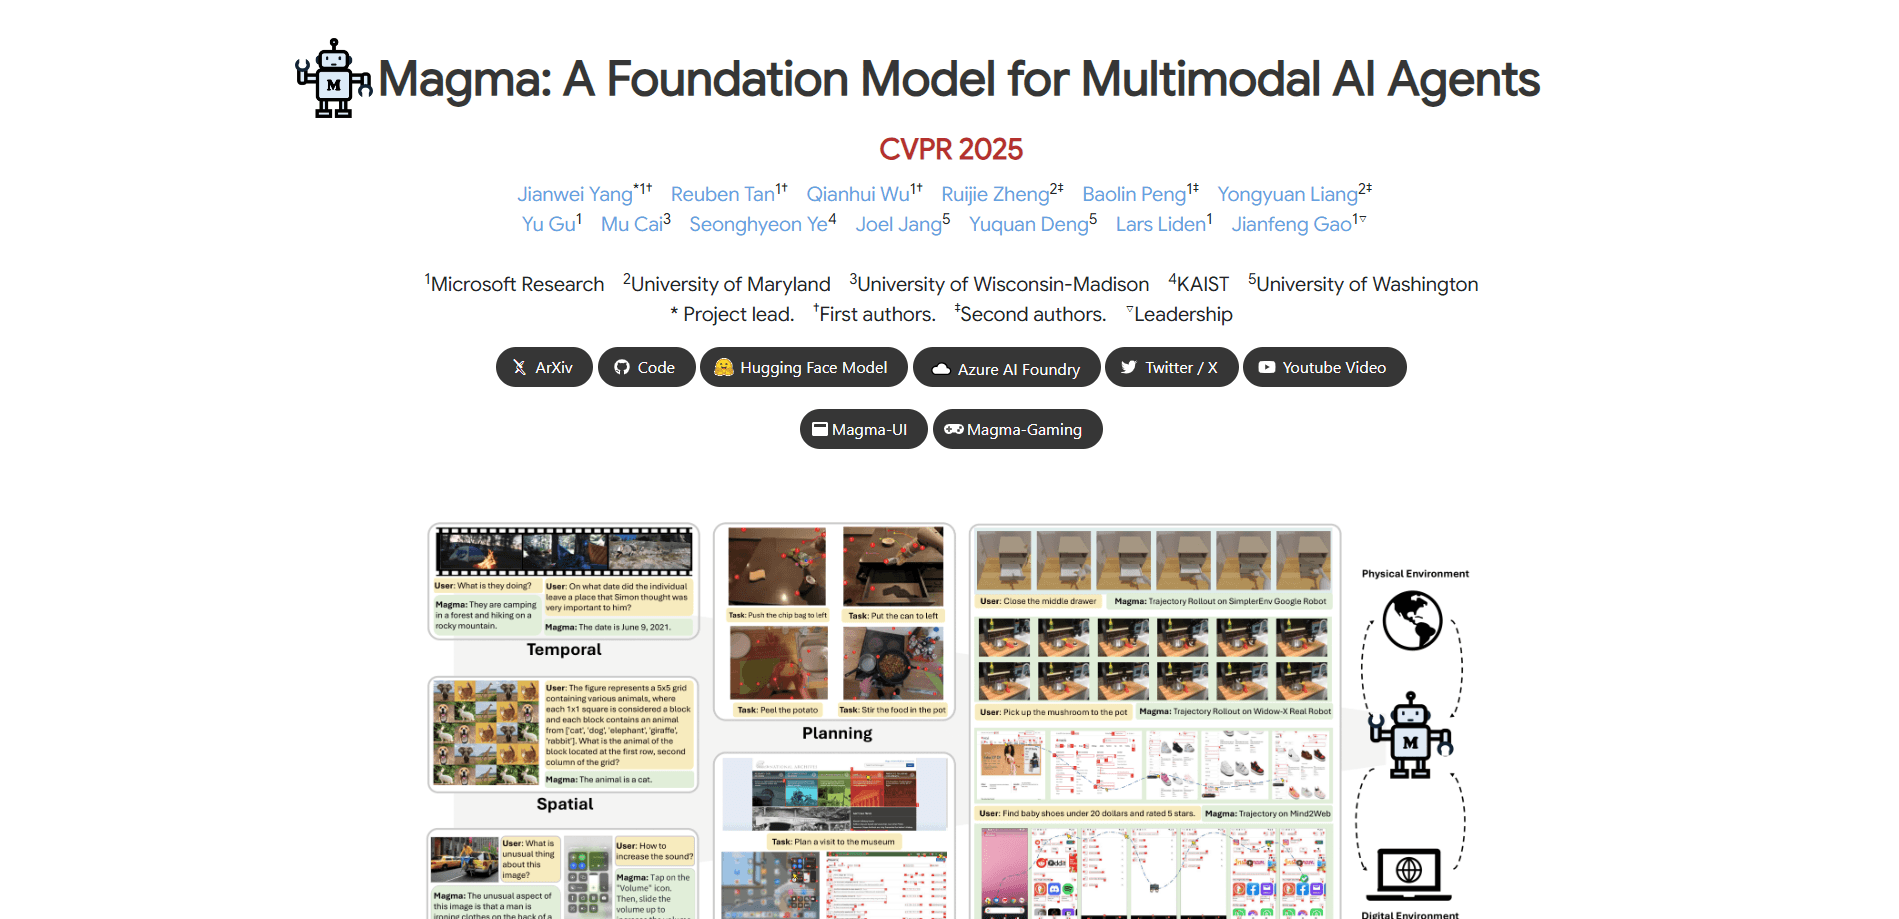
Magma est un modèle de base conçu par Microsoft Research pour les agents d'IA multimodaux. Contrairement à un modèle vision-langage classique, qui se contente de décrire ce qu'il voit, Magma associe compréhension et action. Il reçoit des images, des vidéos et du texte, puis propose des étapes orientées vers un objectif, du clic sur un bouton dans une appli mobile à la conduite d'un bras robotique pour saisir un objet. Le travail a été accepté à la CVPR 2025, et Microsoft a publié le code et les poids du modèle en open source.
L'idée sous-jacente, c'est un seul modèle pour deux mondes. Presque tous les systèmes précédents étaient entraînés pour une tâche unique, interface 2D ou robot 3D, et peinaient à passer de l'une à l'autre. Magma a été pré-entraîné sur un mélange d'images, de vidéos et de données de robotique, afin qu'un seul modèle couvre la navigation d'interface, la manipulation de robots et les questions générales sur images ou vidéos. Microsoft le présente comme le premier modèle de base pour agents d'IA multimodaux.
La principale limite tient au fait que Magma est un modèle de recherche, pas un produit fini. Il est diffusé sous forme de poids et de code ouverts que vous exécutez vous-même, et il faut une GPU assez musclée pour l'essayer. Il vise les développeurs et les chercheurs capables de le réentraîner, pas les utilisateurs qui veulent une application prête à l'emploi.
Getting Started
- Préparez un environnement Python avec PyTorch et le dépôt Magma sur GitHub.
- Téléchargez les poids de Magma-8B depuis Hugging Face.
- Chargez le modèle et le processeur, en pointant le code vers votre GPU.
- Envoyez une image ou une vidéo avec un texte pour obtenir une réponse ou une action proposée.
- Réentraînez le modèle sur vos propres données pour une tâche précise, comme la navigation d'interface ou le pilotage d'un robot.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Magma.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Chercheurs en IA
- Développeurs d'applis et de robotique
- Étudiants en IA multimodale
Tâches
- Navigation d'interface
- Manipulation de robots
- Questions sur images et vidéos
- Raisonnement spatial
Cas d'usage
- Recherche sur les modèles agentiques
- Prototype d'automatisation d'interface
- Exploration du transfert entre domaines
Fonctionnalités clés
Un modèle pour le numérique et le physique
Magma couvre la navigation d'interface et la manipulation de robots avec un seul jeu de poids. Les modèles précédents étaient souvent réglés pour un seul environnement, si bien qu'un agent d'écran ne pouvait pas piloter un robot. Microsoft a entraîné Magma sur des données mélangées pour qu'il passe du clic dans une appli à la planification d'une action physique.
Set-of-Mark pour ancrer les actions
Set-of-Mark étiquette par des numéros les objets sur lesquels on peut agir, boutons d'un écran ou pince d'un bras robotique. Le modèle prédit sur quelle marque agir, ce qui transforme une compréhension visuelle floue en action concrète.
Trace-of-Mark pour planifier
Trace-of-Mark étiquette le déplacement des objets au fil des images, comme la trajectoire d'une main ou d'un bras robotique. En apprenant de ces traces, Magma planifie des actions en plusieurs étapes et anticipe la suite, au lieu de réagir image par image.
Pré-entraînement sur données mélangées
Magma a été pré-entraîné sur un ensemble large et varié d'images, de vidéos et de données de robotique. Ce mélange permet à un seul modèle de conserver la compréhension générale des images et vidéos à côté des compétences agentiques, sans sacrifier l'une à l'autre. Il s'appuie sur des vidéos librement disponibles pour apprendre les motifs spatiaux et temporels.
Compréhension des vidéos et des images
Au-delà des actions, Magma répond à des questions sur des photos et des clips, y compris des tâches de questions-réponses sur vidéo et de raisonnement spatial. Microsoft indique qu'il rivalise avec des modèles vision-langage plus grands sur plusieurs benchmarks, malgré moins de données d'instructions vidéo.
Code et poids ouverts
Microsoft publie les poids sur Hugging Face, le code d'entraînement et d'inférence sur GitHub, et Magma-8B sur Azure AI Foundry. Cette ouverture laisse les chercheurs reproduire les résultats et réentraîner le modèle, même si l'installation et l'hébergement restent à votre charge.
Avantages et inconvénients
Avantages
- Un seul modèle couvre la navigation d'interface, le pilotage de robots et la compréhension générale des images et vidéos.
- Les poids et le code ouverts permettent de reproduire les résultats et de réentraîner le modèle sans frein.
- Set-of-Mark et Trace-of-Mark transforment la lecture visuelle en plans d'action concrets.
- Les rapports font état de résultats de pointe en navigation d'interface et en manipulation robotique.
Inconvénients
- C'est un modèle de recherche, donc pas d'appli finie et une mise en route qui demande du vrai travail.
- Faire tourner Magma exige une GPU puissante, ce qui écarte l'utilisateur occasionnel.
- Les résultats dépendent encore d'un réentraînement par tâche, donc l'usage direct reste limité.
- Une partie des données et des évaluations vient de Microsoft même, donc mieux vaut chercher des vérifications indépendantes.
Questions fréquentes
Magma est un modèle de base pour agents d'IA multimodaux. Autrement dit, c'est un agent d'IA multimodal qui comprend et agit. Les développeurs s'en servent pour créer des agents qui lisent un écran et proposent des clics, ou qui planifient des mouvements de robot, en plus de comprendre images et vidéos. C'est du code de recherche, donc vous le réentraînez pour votre propre tâche.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Magma.
Alternatives à Magma

Odyssey 3
Odyssey · AutresOdyssey-3 est le modèle du monde fondationnel d'Odyssey. Il simule la physique en temps réel, transforme une consigne en environnement interactif et s'adapte aux robots, voitures et jeux.

JarvisCore
Prescott Data · Programmation · Productivité · AutresJarvisCore est un runtime Python open source où les agents IA travaillent en pairs sur un maillage, prennent les tâches dans un registre partagé et joignent les services externes via un broker zero trust.
Clef
Cloudflare · Entreprise · AutresClef est le modèle de décision open source de Cloudflare pour Workers AI. Il renvoie des probabilités calibrées pour des questions typées au lieu de texte, ce qui permet à un agent de classer, router et agir vite.