
Preprocess
Preprocess · Productivité · Entreprise
Preprocess était une API de découpage qui fragmentait les PDF, les fichiers Office et le HTML en segments prêts pour le RAG. Le service a depuis été arrêté.
À propos de Preprocess
What Is Preprocess
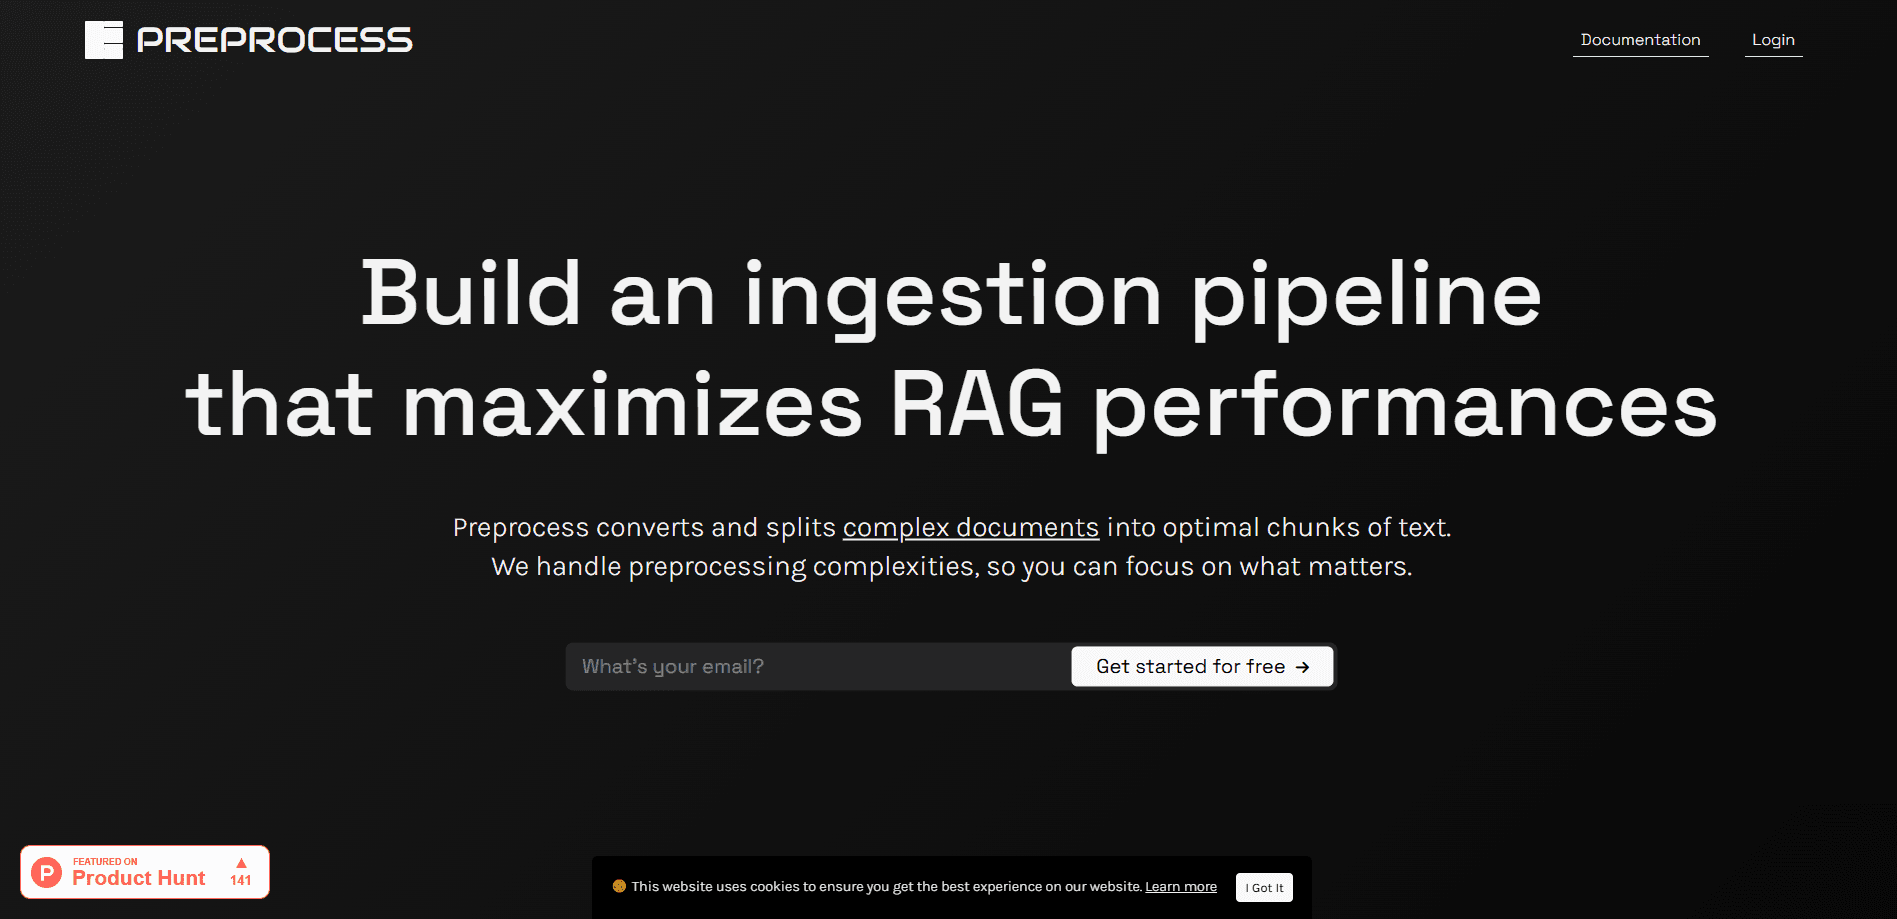
Preprocess était un service d'API qui transformait des documents longs et complexes en segments de texte pensés pour la recherche documentaire. Au lieu de couper un fichier toutes les quelques centaines de mots, il lisait les titres, les sections, les paragraphes, les tableaux, les images et les listes, puis découpait le contenu en suivant la structure et le sens du document lui-même. L'entreprise présentait le résultat comme des données prêtes pour le RAG : des morceaux propres que vous pouviez vectoriser, indexer et verser dans une base vectorielle sans les retoucher au préalable.
Le problème visé par le prétraitement des données pour le RAG était bien réel. Presque toutes les équipes découpent les documents sur un nombre de mots fixe, et cette méthode livre au modèle tout ce qui tombe dans la fenêtre. Une ligne de tableau se colle à un titre sans rapport, une définition perd sa liste, et le modèle répond à partir de bouts épars. Preprocess affirmait que l'approche attentive à la structure pouvait améliorer les performances du RAG jusqu'à dix fois, un chiffre de l'entreprise elle-même et non d'un test indépendant.
Un point compte aujourd'hui plus que n'importe quelle fonction. Le service preprocess.co n'est plus disponible. Le site officiel renvoie un répertoire vide, l'éditeur a arrêté le service, et le SDK Python comme le lecteur LlamaIndex portent une mention indiquant que le projet est abandonné et qu'il faut le retirer des projets.
Getting Started
Voici les étapes du temps où le service tournait.
- Créez un compte sur l'application Preprocess et achetez un lot de crédits pour obtenir une clé d'API
- Envoyez le document au point d'accès d'analyse par téléversement ou via le SDK Python
- Laissez l'analyse asynchrone se terminer, puis recevez le résultat sur votre webhook ou récupérez-le par une requête GET pendant 24 heures
- Versez les segments renvoyés directement dans votre base vectorielle, sans découpeur de texte séparé
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Preprocess.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Ingénieurs IA qui montaient des pipelines RAG
- Développeurs backend sans parseur maison
- Équipes produit qui lançaient un assistant IA
Tâches
- Découper de longs PDF
- Extraire tableaux et listes
- Traiter des documents numérisés
- Traiter des fichiers Office et HTML
Cas d'usage
- Une équipe juridique ou financière qui versait des contrats denses dans un outil de recherche
- Un bot de support bâti sur des manuels et des pages d'aide
- Une startup sans équipe de parsing
- Un traitement par lots
Fonctionnalités clés
Découpage intelligent attentif à la structure
La fonction centrale fractionnait les documents en suivant les titres, les sections, les paragraphes, les tableaux, les images et les listes, puis regroupait les longs passages par sens. Chaque segment visait ainsi un seul sujet et la vectorisation capturait une idée unique. L'entreprise soutenait que cela suffisait à relever la qualité de la recherche et à faire baisser les hallucinations, parce que le modèle cessait de recevoir des morceaux désaccordés.
Prise en charge de nombreux formats
L'API acceptait les PDF, les fichiers Microsoft Office, les fichiers OpenOffice, le HTML et le texte brut par un seul point d'accès. Les PDF numérisés passaient aussi, parce que l'extraction de texte tournait avant le découpage. Pour les équipes aux sources variées, cela faisait une intégration unique au lieu d'un parseur par type de fichier.
API asynchrone et webhooks
Analyser un long document prend du temps, alors l'API travaillait en asynchrone. Un appel d'analyse confirmait la réception, puis les segments prêts arrivaient sur un webhook ou se récupéraient par une requête GET pendant 24 heures. Ce choix convenait aux traitements par lots, où des dizaines de fichiers passent en même temps et où rien n'attend en file.
SDK Python et intégration LlamaIndex
Un SDK nommé pypreprocess enveloppait l'API en quelques lignes de Python, et un lecteur LlamaIndex chargeait des fichiers déjà découpés ou récupérait des résultats antérieurs par ID de processus. Le lecteur rendait aussi le texte complet d'un document quand une équipe voulait son propre pipeline. Le SDK comme le lecteur sont aujourd'hui marqués comme abandonnés.
Tarification par crédits, sans abonnement
Preprocess n'appliquait pas de frais mensuels. Vous achetiez un lot de crédits et rechargeiez quand ils étaient épuisés. Une page de document ou de présentation coûtait un crédit, une feuille de tableur coûtait un crédit, et les fichiers HTML ou texte étaient convertis en PDF avant le décompte. Ce modèle convenait aux équipes à charge irrégulière.
Contrôles pour l'entreprise
Les formules hautes ajoutaient l'export d'images, le contrôle des frontières de segment, des accords de non-conservation des données, un déploiement sur site et des pipelines de traitement sur mesure. Ces options visaient les secteurs réglementés, où les données de documents ne peuvent pas quitter l'infrastructure d'une entreprise.
Avantages et inconvénients
Avantages
- Un découpage par structure et par sens, donc une recherche qui ramenait des passages restés dans le sujet
- Un seul point d'accès couvrait les PDF, les fichiers Office, le HTML et le texte brut, numérisés compris
- Pas d'abonnement, juste des lots de crédits adaptés aux charges irrégulières
- Les webhooks et le SDK Python s'inséraient dans des pipelines d'ingestion existants, sans colle supplémentaire
- Le lecteur LlamaIndex le faisait entrer dans une pile RAG courante
Inconvénients
- Le service est abandonné, donc impossible aujourd'hui de s'inscrire, d'acheter des crédits ou d'appeler l'API
- Le gain annoncé jusqu'à dix fois venait de l'éditeur, sans test indépendant pour l'étayer
- Le prix tenait à des crédits prépayés et non à une formule à l'usage, ce qui obligeait à payer d'avance une capacité peut-être inutilisée
- Les contrôles avancés comme les frontières de segment et le déploiement sur site restaient réservés à la formule entreprise
Questions fréquentes
Preprocess était une API de découpage de documents pour les pipelines RAG. Elle lisait les PDF, les fichiers Office, le HTML et le texte brut, puis les fractionnait en segments de texte qui suivaient la structure et le sens du document, afin que chaque morceau puisse être vectorisé et indexé seul.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Preprocess.
Alternatives à Preprocess

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Knocket
Knocket (Tencent RTC team) · Productivité · Entreprise · ChatbotKnocket est un outil gratuit de chat en direct et de page de contact : vos visiteurs écrivent depuis votre site, votre application ou un lien, et vous répondez depuis Telegram ou une seule boîte de réception.

FloorGen
Vinit Kumar (FloorGen) · Productivité · IA chinoiseFloorGen est un créateur de plans dans le navigateur qui transforme une phrase ou un croquis en plan 2D modifiable et en visite 3D. Export en PDF, DXF ou vidéo, sans compte pour dessiner.