

Query Memory
Query Memory · Productivité · Apprentissage
Query Memory est une plateforme d'espace de travail unifiée pour analyser des documents, gérer des données et déployer des agents IA via une seule pile articulée autour d'une API. Elle réunit l'analyse de documents, l'indexation des connaissances, les points de terminaison d'agents et l'analyse web derrière une seule clé d'API, ce qui permet aux équipes d'envoyer des PDF, des tableurs, des contrats et des e-mails à leurs applications sans câbler des dizaines d'outils séparés. Le public visé, ce sont les développeurs et les équipes qui veulent une couche de mémoire centrale pour leurs produits d'IA, pas un chatbot de plus.
À propos de Query Memory
Qu'est-ce que Query Memory
Query Memory est une plateforme articulée autour d'une API qui donne aux applications d'IA une couche de mémoire. Au lieu d'assembler des services d'OCR, des bases de données vectorielles et des environnements d'agents distincts, vous connectez un SDK et atteignez toutes les capacités depuis le même client. La promesse affichée sur son propre site est directe : analyser des documents, interroger des bases de données et extraire des données du web via une API unifiée.
Le problème qu'elle résout, c'est la fragmentation. Une fonctionnalité d'IA classique a besoin d'ingestion de fichiers, de découpage, de récupération et d'une réponse ancrée dans les sources. Chacune de ces étapes implique généralement un fournisseur différent et une facturation différente. La note monte vite. Query Memory les rassemble dans un seul espace de travail avec suivi de l'usage, clés d'API et points de terminaison partagés entre services.
La limitation la plus évidente, ce sont l'échelle et le prix. L'offre gratuite est petite, plafonnée à 25 analyses de documents et 100 requêtes d'API par mois, et le trafic réel de production vous pousse vers l'offre Pro à 99 $/mois ou vers un contrat Enterprise sur mesure. C'est aussi une plateforme de développeur, donc si vous n'écrivez pas de code, il n'y a pas encore grand-chose pour vous ici.
Pour commencer
- Créez un compte Query Memory depuis la page d'inscription et ouvrez le tableau de bord.
- Générez une clé d'API, puis initialisez le SDK avec votre URL de base et votre clé.
- Téléversez des documents vers une base de connaissances ou envoyez-les au point de terminaison d'analyse pour obtenir une sortie structurée.
- Interrogez vos connaissances indexées, appelez un point de terminaison d'agent ou lancez une requête d'analyse web depuis le même client.
- Suivez l'usage, le stockage et le trafic des points de terminaison depuis le tableau de bord du compte à mesure que le volume grandit.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Query Memory.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Les développeurs backend et IA qui ont besoin d'ingestion et de récupération de documents sans assembler plusieurs fournisseurs.
- Les équipes produit qui construisent des assistants ancrés dans les sources et capables de citer les documents d'origine.
- Les équipes données et opérations qui veulent des contrats, des rapports et des dossiers interrogeables dans un seul hub avec permissions.
Tâches
- Analyser des PDF, des fichiers DOCX, des tableurs, du HTML et des images pour en tirer des éléments structurés propres.
- Indexer une collection de documents dans une base de connaissances et l'interroger en langage naturel.
- Déployer des points de terminaison d'agents ancrés dans les sources qui répondent avec des références liées.
- Exécuter une extraction web limitée à un domaine pour injecter du contexte externe en direct dans une application.
Cas d'usage
- Une équipe fintech qui veut poser des questions sur des contrats de location et des dossiers de souscription.
- Un produit de support qui doit résumer des sinistres et des contrats à la demande.
- Un flux de recherche qui mêle des articles téléversés et des pages web en direct dans une seule requête.
Fonctionnalités clés
API et SDK unifiés
Un seul client couvre les connaissances, les agents et l'analyse web, donc vous initialisez le SDK une fois et réutilisez la même clé d'API partout. La formulation de l'entreprise elle-même est que cela remplace une pile d'outils fragmentés par un point de terminaison unique. C'est surtout important pour les équipes qui, sinon, maintiendraient trois intégrations et trois jeux d'identifiants. Moins de pièces mobiles. Moins de clés à renouveler.
Analyse de documents
Query Memory analyse les PDF, DOCX, tableurs, HTML, images et texte brut pour en tirer des éléments structurés. Le site affirme que ses modèles multimodaux spécialisés atteignent plus de 98 % de précision sur des mises en page complexes, surpassant l'OCR classique et les LLM génériques. Considérez ce chiffre comme une affirmation du fournisseur jusqu'à ce que vous le testiez sur vos propres documents.
Indexation des connaissances
Les fichiers se connectent à des bases de connaissances interrogeables qui prennent en charge une récupération sémantique rapide. Les requêtes renvoient des extraits classés et le contexte environnant, ce qui vous permet de fournir à un modèle une matière ancrée plutôt que du texte brut, et chaque hub conserve ses permissions pour que les documents sensibles restent limités aux bons utilisateurs.
Points de terminaison d'agents
Vous pouvez déployer des agents IA ancrés dans les sources avec des contrôles de modèle, des prompts et des réponses conscientes des sources. Les requêtes d'agent passent par la même surface de SDK. L'intégration reste donc superficielle. Pour les équipes qui livrent des assistants, cela supprime le besoin d'héberger et de dimensionner un environnement d'agents séparé.
Analyse web
L'analyse web exécute une extraction limitée à un domaine et une récupération classée pour ramener du contexte externe en direct. Elle utilise les mêmes formats de sortie que le volet documents. Une page web et un PDF arrivent sous la même forme. Cette cohérence est le gain pratique quand vous fusionnez des sources internes et externes.
Connecteurs et intégrations
La plateforme liste des connecteurs vers Microsoft SharePoint, Google Drive, Snowflake, Databricks, Oracle Cloud Infrastructure et Dropbox, et affirme qu'il en existe 400 de plus. Cette couverture permet aux équipes d'indexer les données là où elles se trouvent déjà plutôt que de tout migrer d'abord. La profondeur de chaque connecteur mérite d'être vérifiée par source avant de vous engager.
Usage et visibilité opérationnelle
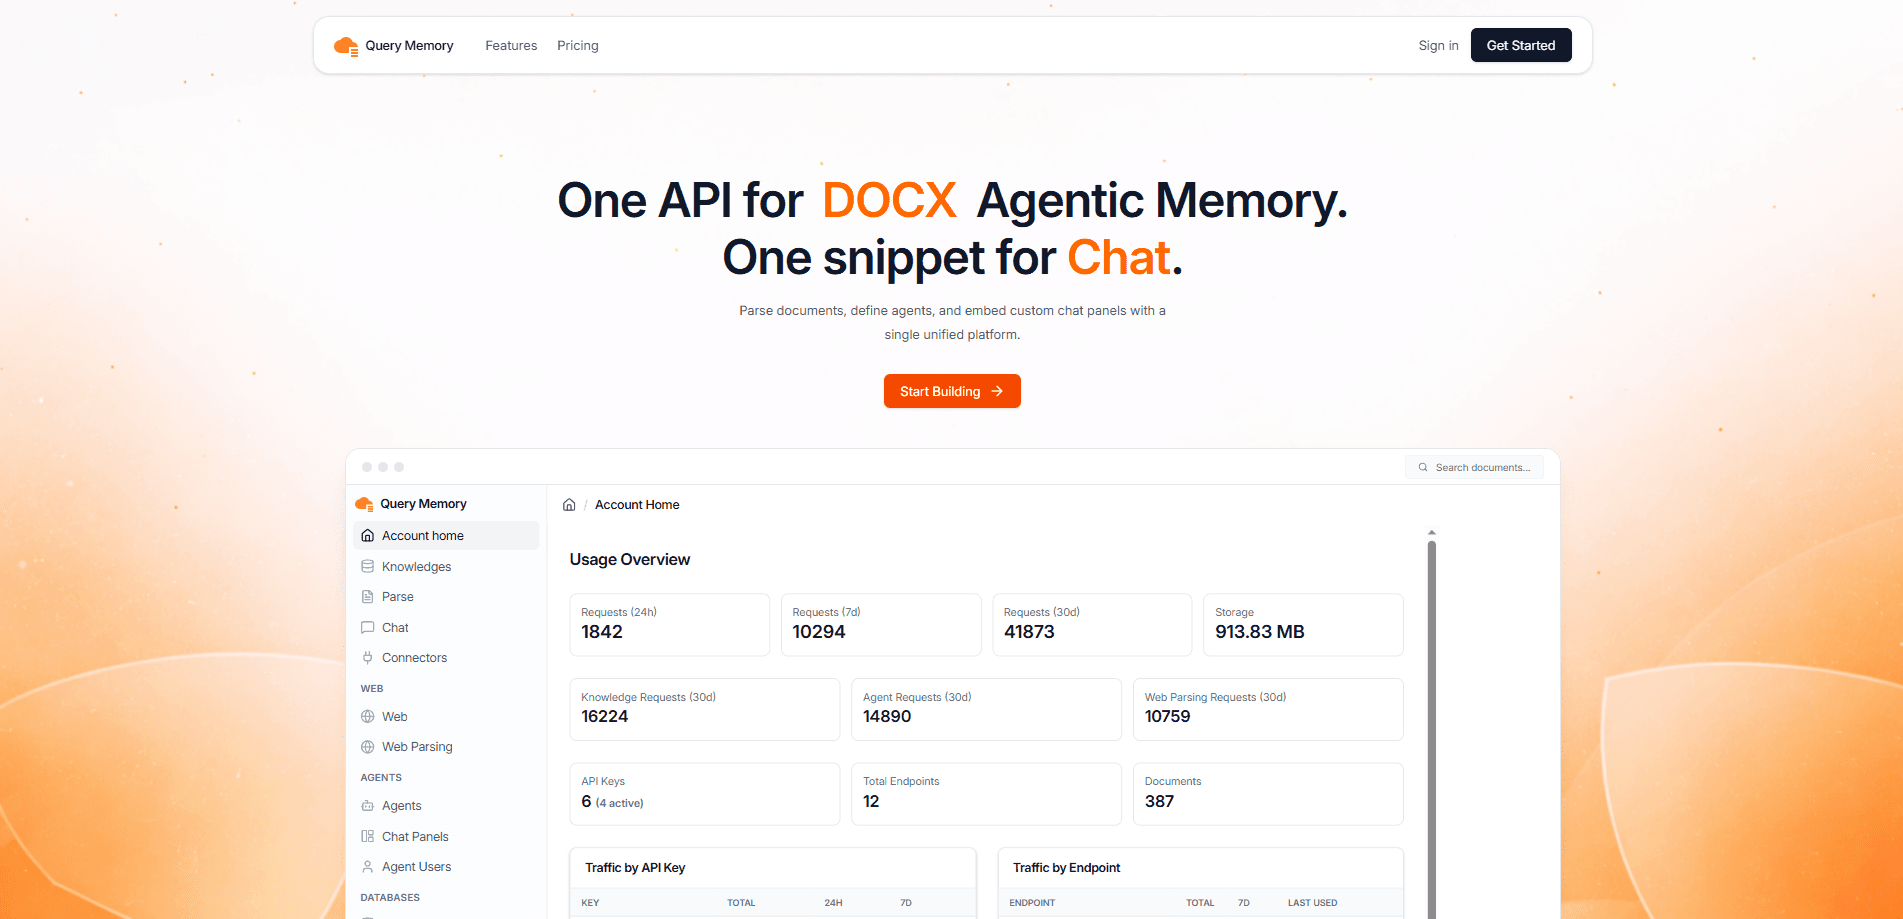
Le tableau de bord montre les requêtes sur 24 heures, 7 jours et 30 jours, le stockage utilisé, le trafic ventilé par clé d'API et par point de terminaison, et l'activité récente du service. Pour les équipes qui font tourner cela en production, cette visibilité répond à une question simple. Quel point de terminaison décroche, et quelle clé en est la cause ? Ce n'est pas une suite d'observabilité complète. Elle couvre tout de même l'essentiel pour voir quel service vous coûte vraiment de l'argent.
Avantages et inconvénients
Avantages
- Une seule clé d'API et un seul SDK couvrent l'analyse, les connaissances, les agents et les requêtes web, ce qui réduit le travail d'intégration.
- La sortie structurée reste cohérente entre les types de documents et les pages web.
- L'offre gratuite permet d'évaluer l'API d'analyse de documents et l'API de base de connaissances avant de payer.
- Les hubs de connaissances avec permissions gardent les dossiers sensibles limités.
- Les connecteurs vers SharePoint, Drive, Snowflake et sources similaires réduisent la migration de données.
Inconvénients
- L'offre gratuite est serrée, avec 25 analyses et 100 requêtes d'API par mois, et ne survivra pas à de vrais tests.
- Pro grimpe à 99 $/mois, et les dépassements sont facturés à l'usage, donc les coûts augmentent avec un usage intensif.
- C'est une plateforme de développeur sans véritable voie no-code, donc les utilisateurs non techniques sont exclus.
- Les affirmations de prix et de précision viennent du fournisseur, et aucun benchmark indépendant n'est publié.
Questions fréquentes
C'est une couche de mémoire pour les applications d'IA. Vous lui envoyez des documents, des bases de données et des sources web, et elle renvoie des données structurées, des connaissances interrogeables et des réponses d'agents ancrées dans les sources via une seule API.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Query Memory.
Alternatives à Query Memory

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Knocket
Knocket (Tencent RTC team) · Productivité · Entreprise · ChatbotKnocket est un outil gratuit de chat en direct et de page de contact : vos visiteurs écrivent depuis votre site, votre application ou un lien, et vous répondez depuis Telegram ou une seule boîte de réception.

FloorGen
Vinit Kumar (FloorGen) · Productivité · IA chinoiseFloorGen est un créateur de plans dans le navigateur qui transforme une phrase ou un croquis en plan 2D modifiable et en visite 3D. Export en PDF, DXF ou vidéo, sans compte pour dessiner.