
QwQ-32B
Alibaba (Qwen team) · Entreprise · Autres
QwQ-32B est le modèle de raisonnement à poids ouverts de l'équipe Qwen d'Alibaba : il résout maths et code étape par étape et tourne sur un seul GPU personnel.
À propos de QwQ-32B
What Is QwQ-32B
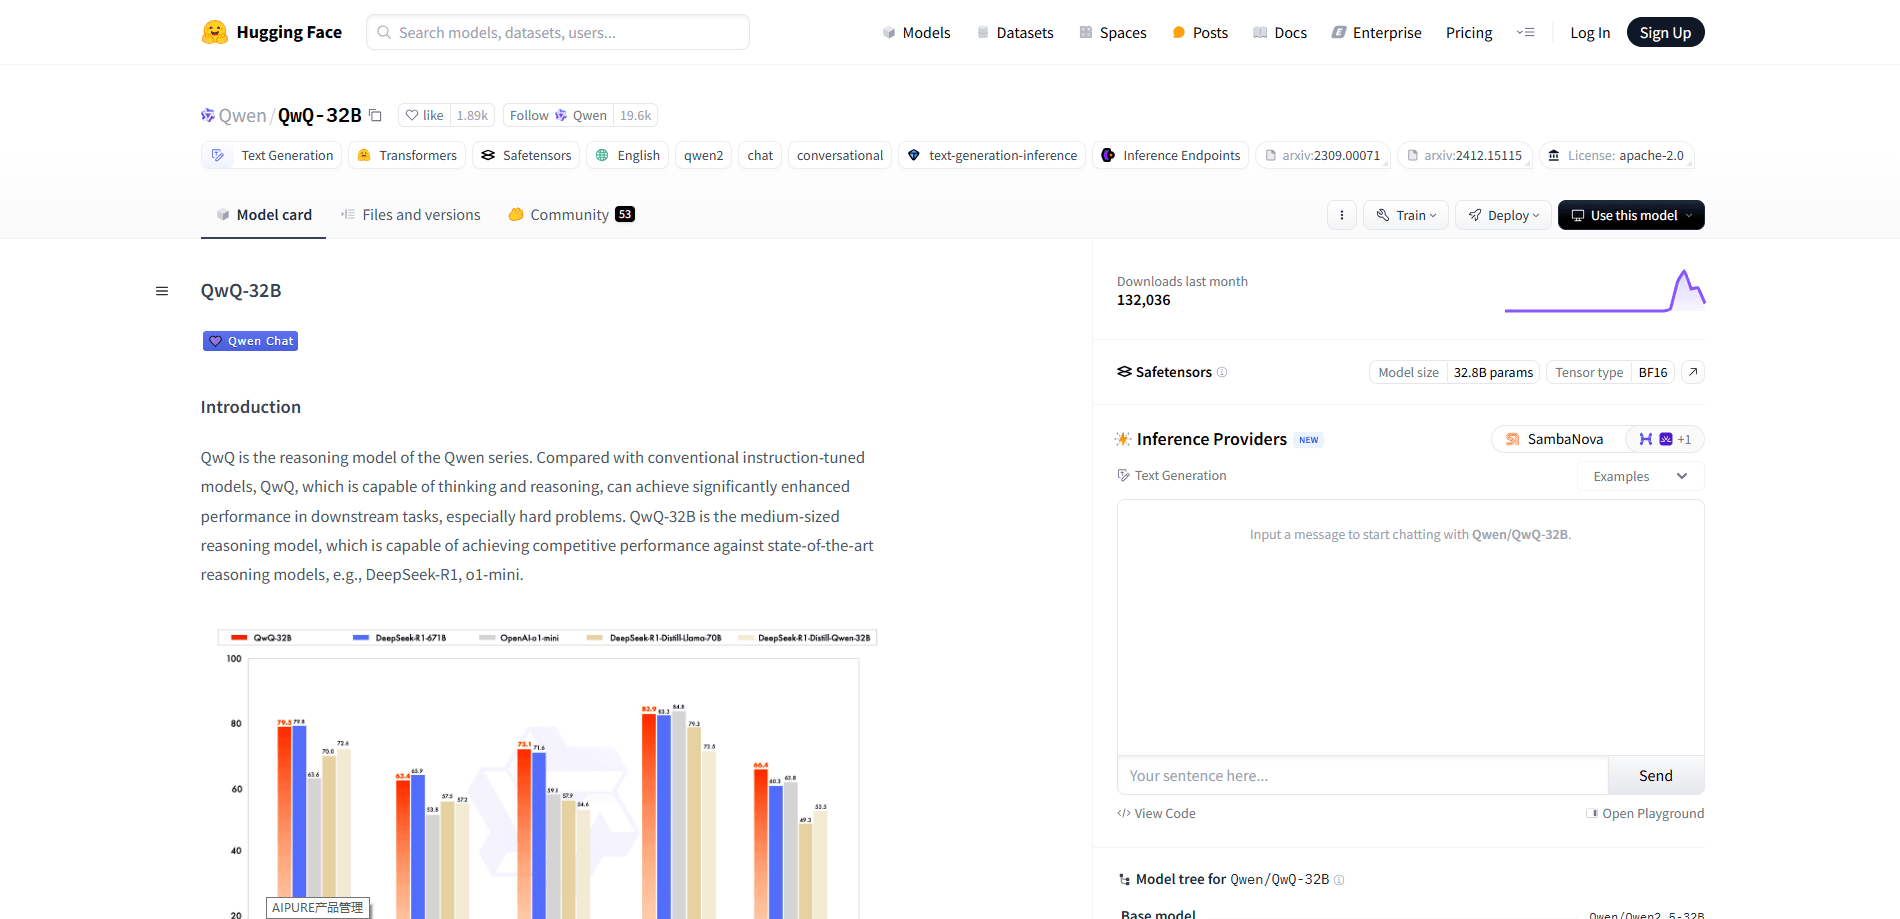
QwQ-32B est un modèle de langage centré sur le raisonnement, signé par l'équipe Qwen d'Alibaba et publié en mars 2025 sous licence Apache 2.0. Il compte 32 milliards de paramètres et descend de Qwen2.5-32B, le modèle général dont l'équipe est partie. Plutôt que de répondre sur-le-champ, il rédige une longue chaîne de raisonnement, vérifie ses propres étapes et ne tranche qu'ensuite. Cette habitude, c'est ce qu'on appelle le raisonnement, et elle explique sa tenue sur les questions où deviner coûte cher.
Comme modèle de raisonnement open source, il s'inspecte aussi au lieu de se louer. L'affirmation phare, selon l'équipe Qwen, est que QwQ-32B soutient la comparaison avec DeepSeek-R1, un modèle de 671 milliards de paramètres. L'équipe attribue ce résultat à l'apprentissage par renforcement, et non à la taille : elle a fait monter en puissance le RL sur les maths et le code, puis ajouté un second tour pour les compétences générales. Pour vous, l'essentiel est simple : un raisonneur solide, assez petit pour tourner chez vous.
La limite tient à son périmètre. QwQ-32B réfléchit avant de parler, donc il traîne sur la moindre tâche triviale, et ses poids sont figés à la version d'origine. Les modèles Qwen sortis depuis couvrent plus de langues et basculent entre mode rapide et mode profond : voyez donc QwQ-32B comme un outil de raisonnement ciblé, pas comme un assistant à tout faire.
Getting Started
- Téléchargez les poids sur Hugging Face ou ModelScope, ou récupérez la version quantifiée avec
ollama run qwq - Chargez le modèle dans un serveur d'inférence comme vLLM, SGLang ou Ollama, selon votre matériel
- Envoyez votre requête via le point d'accès compatible OpenAI exposé par le serveur, et lisez la trace de raisonnement avant la réponse finale
- Pour un accès hébergé, appelez l'API Qwen sur Alibaba Cloud Model Studio avec le nom de modèle
qwq-32b
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de QwQ-32B.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs qui veulent un modèle de raisonnement sur leur propre matériel
- Étudiants et autodidactes qui butent sur des problèmes de maths ou de code
- Chercheurs qui comparent les modèles de raisonnement
Tâches
- Résoudre des problèmes de maths de niveau compétition
- Écrire et déboguer du code
- Construire des agents qui utilisent des outils
- Exécuter QwQ-32B en local après quantification
Cas d'usage
- Garder des données privées à la maison
- Travail hors ligne ou en réseau isolé
- Prototyper une fonction de raisonnement
Fonctionnalités clés
Raisonnement par longue chaîne de pensée
QwQ-32B déroule le problème en étapes explicites avant de répondre. Vous lisez ce raisonnement, repérez où il a dérapé et reformulez votre requête. C'est la différence entre un modèle qui sonne sûr de lui et un modèle que vous pouvez réellement vérifier.
Des performances en maths et en code proches de modèles bien plus gros
L'équipe Qwen indique que le benchmark QwQ-32B égale DeepSeek-R1 sur des tests comme AIME et LiveCodeBench, malgré l'écart de taille. Ce sont justement les deux domaines intégrés à son entraînement : c'est donc le choix naturel dès qu'il y a des chiffres ou du code.
Appel d'outils au cœur du raisonnement
QwQ-32B appelle des fonctions en pleine réflexion et réinjecte les résultats dans son plan. Si la tâche réclame des données à jour ou une action externe, le modèle décide quand saisir un outil au lieu de deviner. Il sert donc de cerveau à un agent, pas seulement de partenaire de conversation.
Poids ouverts sous Apache 2.0
Les poids complets se téléchargent et la licence est permissive : vous pouvez affiner, quantifier ou distribuer le modèle dans un produit. Rien n'est enfermé derrière un compte fournisseur, ce qui pèse quand vous construisez par-dessus.
Un seul GPU suffit une fois quantifié
En précision complète, le modèle réclame beaucoup de mémoire, mais les versions 4 bits le ramènent à la taille d'une carte grand public. Vous obtenez un raisonnement qui exigeait un centre de données, sur une machine qui vous appartient.
Serveur compatible OpenAI
Des serveurs comme vLLM et SGLang exposent QwQ-32B via une API façon OpenAI. Vous pointez votre code existant vers une nouvelle URL et une nouvelle clé, et ça tourne : l'adoption prend des minutes, pas une réécriture.
Avantages et inconvénients
Avantages
- Une qualité de raisonnement qui rivalise avec des modèles plusieurs fois plus gros, d'après les benchmarks de l'équipe Qwen
- Des poids ouverts sous Apache 2.0 : auto-hébergement, affinage et distribution libres
- Les versions quantifiées tournent sur un seul GPU grand public, ce qui garde les données en local
- L'appel d'outils fonctionne dans la boucle de raisonnement, une base solide pour les agents
- Un serveur compatible OpenAI limite les changements de code pour l'adopter
Inconvénients
- Il est lent par nature : la moindre question triviale déclenche une réflexion complète, donc l'usage type chat paraît poussif
- Les poids sont figés à la sortie de 2025 : vous passez à côté du support multilingue et des modes arrivés dans les modèles Qwen suivants
- La mémoire en précision complète est élevée : sur du matériel modeste, impossible de faire l'impasse sur la quantification
- L'entraînement a privilégié les maths et le code, donc l'écriture ouverte ou les langues rares peuvent accuser un retard face à un modèle généraliste
Questions fréquentes
C'est un modèle de langage à poids ouverts centré sur le raisonnement, signé par l'équipe Qwen d'Alibaba. Il compte 32 milliards de paramètres et travaille les problèmes pas à pas avant de répondre, d'où sa force en maths et en code.
Contenus associés
Découvrez des outils, des compétences et des articles liés à QwQ-32B.
Alternatives à QwQ-32B

Claude for Google Workspace
Anthropic · Rédaction · Productivité · EntrepriseClaude for Google Workspace installe une barre latérale Claude dans Google Docs, Sheets et Slides, où l'assistant lit le fichier ouvert et le modifie sur place.

KloudMate 2.0
KloudMate · Programmation · EntrepriseKloudMate 2.0 est une plateforme d'observabilité IA qui rassemble logs, métriques, traces et incidents, et confie à KloudMate Assistant l'enquête sur les alertes et la correction à appliquer.
Cekura Bench
Cekura · Voix et langage · EntrepriseCekura Bench est un benchmark public qui fait passer des modèles parole à parole et des agents vocaux en production par 82 appels simulés, trois fois chacun, avant de publier taux de réussite, latence et coût.