

Skywork-R1V
Skywork AI (Kunlun Tech) · Autres
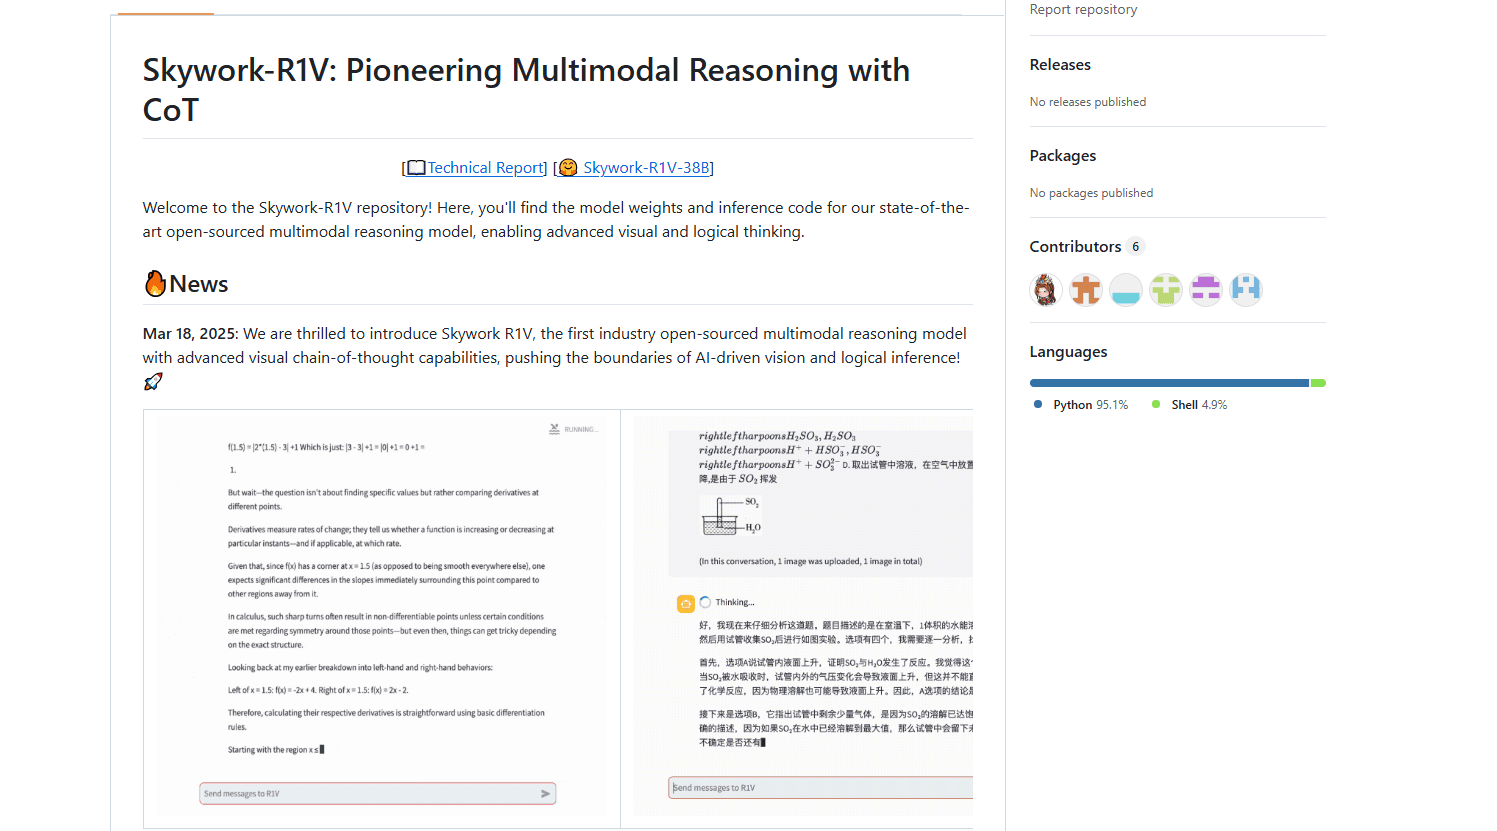
Skywork-R1V est une série ouverte de modèles de raisonnement multimodal de Skywork AI. Il lit les images et résout des problèmes de maths, de sciences et de graphiques étape par étape.
À propos de Skywork-R1V
What Is Skywork-R1V
Skywork-R1V est une famille bâtie sur le modèle vision langage de Skywork AI, la branche de recherche de Kunlun Tech. Sortie d'IA multimodale open source, la série met les poids entre vos mains. L'idée derrière la série est simple à énoncer et difficile à mener à bien : prendre un modèle qui raisonne déjà bien en texte et lui donner la capacité de raisonner sur des images sans perdre ce talent. Skywork appelle cela transférer le raisonnement fort du texte vers la vision. La plupart des modèles multimodaux reconnaissent ce qu'il y a dans une photo ; R1V déroule les étapes qui se cachent derrière.
Le premier R1V est arrivé en mars 2025 en version à poids ouverts, et l'équipe a itéré vite depuis. R1V2 a suivi en avril, R1V3-38B a débarqué en juillet avec 76,0 sur le benchmark MMMU, et R1V4-Lite est sorti en novembre comme un modèle agentique plus léger. Chaque étape a fait glisser la série du raisonnement pur vers des modèles qui agissent. Vous pouvez télécharger les poids sur Hugging Face, les exécuter en local ou appeler l'API hébergée.
Deux limites comptent d'emblée. Les modèles 38B sont assez gros pour que les faire tourner vous-même demande du matériel sérieux, sauf si vous choisissez une version quantifiée. Et R1V est une sortie de niveau recherche, donc l'outillage autour suppose que vous savez vous débrouiller avec Python et un serveur de modèles.
Getting Started
- Choisissez une version de la collection Hugging Face adaptée à votre matériel, de R1V3-38B à une version quantifiée
- Clonez le dépôt Skywork-R1V sur GitHub et préparez l'environnement Python avec le script fourni
- Chargez un modèle avec Transformers ou vLLM et pointez-le vers une image et une question
- Pour la voie hébergée, créez un compte sur la plateforme Skywork et appelez le point de terminaison completions avec votre image et votre prompt
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Skywork-R1V.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Chercheurs en IA
- Ingénieurs machine learning
- Étudiants et autodidactes
- Startups au budget serré
Tâches
- Problèmes visuels de maths et de sciences
- Analyse de graphiques et de schémas
- Compréhension de documents
- Revue d'images médicales et techniques
- Tâches d'image agentiques
Cas d'usage
- Un étudiant photographie un problème manuscrit
- Un chercheur compare des benchmarks
- Une petite équipe veut de la vision sans grosse facture
- Un développeur lit un graphique dense
- Une équipe support trie des formulaires scannés
Fonctionnalités clés
Raisonnement multimodal en chaîne de pensée
Le cœur de Skywork-R1V, c'est qu'il raisonne par étapes au lieu d'ajuster un motif de réponse. Donnez-lui un problème de géométrie avec un schéma et il déroule la logique avant d'arriver au résultat. L'équipe a bâti la série autour du transfert du raisonnement textuel vers la vision, donc le modèle garde ses talents en maths et en logique pendant qu'il lit une image. Cette combinaison le distingue d'un modèle qui ne fait que légender des photos.
Longueur adaptative de la chaîne de pensée
Toute question n'a pas besoin d'un long fil de raisonnement. R1V ajuste la part de raisonnement selon la difficulté apparente du problème et la netteté de l'image. Une requête de reconnaissance simple reçoit un chemin court, tandis qu'un problème scientifique à plusieurs étapes reçoit le traitement complet. L'inférence reste ainsi efficace et coupe le surplus de réflexion qui ralentit d'autres modèles de raisonnement.
Benchmarks ouverts de premier plan
Selon Skywork, R1V3-38B obtient 76,0 sur MMMU et 77,1 sur MathVista, et le premier R1V a atteint 94,0 sur MATH500 et 72,0 sur AIME. Ces chiffres placent la sortie ouverte au niveau de modèles propriétaires bien plus grands sur des tâches interdisciplinaires. L'équipe publie le code d'évaluation, donc vous pouvez relancer les benchmarks au lieu d'accepter les scores sur parole.
Poids ouverts sous licence permissive
Les poids du modèle R1V3 sont diffusés sous licence MIT, qui autorise l'usage commercial, la modification et la distribution. Vous pouvez les télécharger sur Hugging Face, les faire tourner sur votre propre GPU et bâtir un produit dessus sans payer de frais par appel. Peu de modèles de vision de cette classe viennent avec des conditions aussi ouvertes.
Versions quantifiées pour du matériel plus modeste
Skywork publie des versions quantifiées AWQ de R1V et R1V2 qui tournent sur une seule carte avec plus de 30 Go de mémoire. Cela fait descendre la barre matérielle d'une configuration multi-GPU à une carte de station de travail, ce qui compte si vous voulez tester le modèle avant de vous engager sur un cluster. Le compromis est une légère perte de précision qui se voit sur les benchmarks les plus durs.
Opérations actives sur l'image dans R1V4-Lite
La sortie la plus récente, R1V4-Lite, fait ce que les modèles précédents ne savent pas faire. Quand une photo est floue ou mal cadrée, il recadre, zoome, fait pivoter ou localise une zone de lui-même, puis raisonne sur la vue améliorée. Il peut écrire un petit outil pour corriger l'image en cours de tâche. Le modèle est assez léger pour la production et répond en une fraction du temps que prennent les modèles plus gros.
Avantages et inconvénients
Avantages
- Les poids ouverts sous licence MIT vous laissent héberger le modèle et bâtir dessus gratuitement
- De solides résultats sur MMMU, MathVista et MATH500 pour un modèle 38B
- Raisonner par étapes rend les réponses plus faciles à vérifier qu'une réponse du premier coup
- Les versions quantifiées tournent sur un GPU avec 30 Go de mémoire, ce qui baisse le coût matériel
- L'API hébergée est gratuite à essayer sur la plateforme Skywork
Inconvénients
- Faire tourner vous-même le modèle 38B complet demande une configuration GPU sérieuse
- Les versions quantifiées perdent en précision sur les tâches les plus dures, le compromis est donc réel
- L'installation suppose des compétences en Python et en serveur de modèles, ce qui la met hors de portée des non-techniciens
- R1V4-Lite est présenté comme un agent, mais sa couverture des canaux est plus étroite que le cœur de raisonnement
Questions fréquentes
Skywork-R1V est une série ouverte de modèles de raisonnement multimodal de Skywork AI. Chaque modèle lit une image et suit une chaîne de pensée pour répondre à une question, au lieu de simplement nommer ce qu'il voit. La série couvre R1V, R1V2, R1V3-38B et R1V4-Lite.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Skywork-R1V.
Alternatives à Skywork-R1V

Odyssey 3
Odyssey · AutresOdyssey-3 est le modèle du monde fondationnel d'Odyssey. Il simule la physique en temps réel, transforme une consigne en environnement interactif et s'adapte aux robots, voitures et jeux.

JarvisCore
Prescott Data · Programmation · Productivité · AutresJarvisCore est un runtime Python open source où les agents IA travaillent en pairs sur un maillage, prennent les tâches dans un registre partagé et joignent les services externes via un broker zero trust.
Clef
Cloudflare · Entreprise · AutresClef est le modèle de décision open source de Cloudflare pour Workers AI. Il renvoie des probabilités calibrées pour des questions typées au lieu de texte, ce qui permet à un agent de classer, router et agir vite.