
StepFun
StepFun · Autres · IA chinoise
Step 3.5 Flash est un modèle de base open source de StepFun, conçu comme un système clairsemé de mélange d'experts (MoE) qui n'active que 11B de ses 196B paramètres par token. Cette conception garde le raisonnement solide tout en poussant la vitesse de génération à 100 à 300 tokens par seconde. Qui a envie d'attendre un modèle lent ? Personne. En tant que modèle d'agent IA, il convient aux assistants de code et au travail à contexte long, où la vitesse décide si vous utilisez vraiment l'outil.
À propos de StepFun
Qu'est-ce que StepFun Step 3.5 Flash
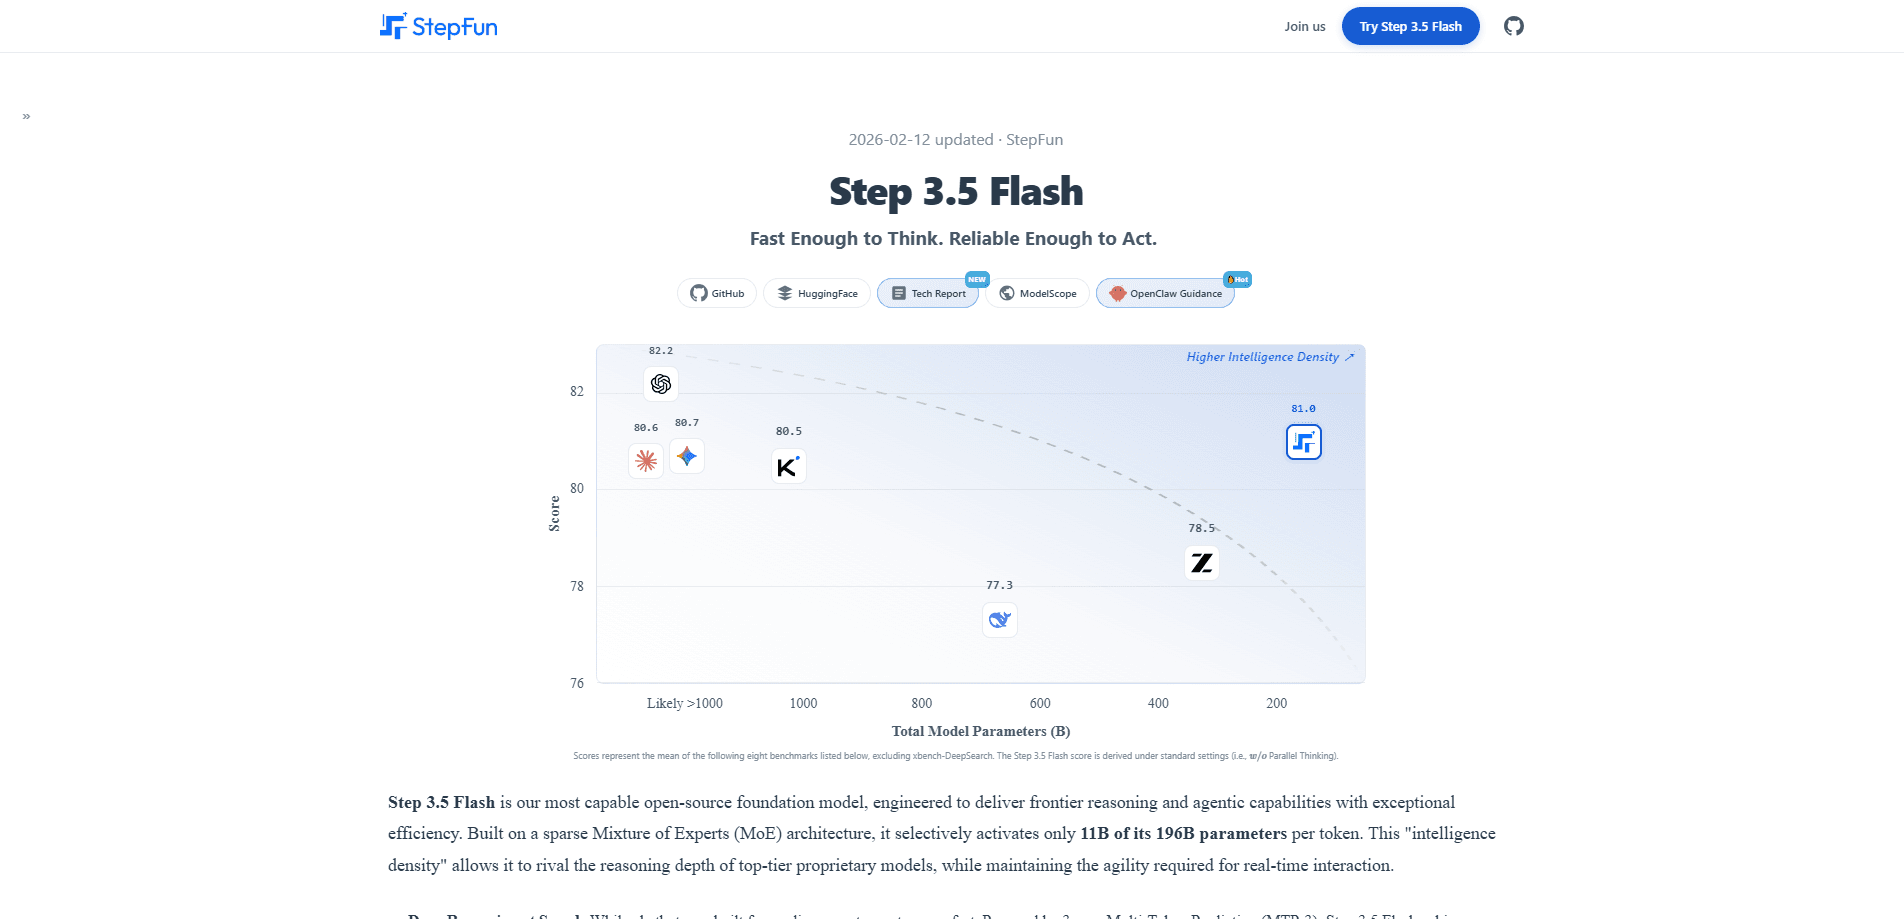
Step 3.5 Flash est un modèle d'IA textuel que StepFun a publié en poids ouverts, si bien que n'importe qui peut télécharger les fichiers et les exécuter en local ou via une API cloud. En tant que modèle d'IA open source, l'attrait réside dans l'efficacité sans grosse perte de qualité. Au lieu de mobiliser les 196B paramètres sur chaque token, une couche de routage choisit la petite part d'experts dont chaque token a réellement besoin. StepFun appelle cela la « densité d'intelligence », et les chiffres soutiennent l'affirmation : une note moyenne de 81,0 sur huit benchmarks, devant plusieurs modèles bien plus gros dans la même comparaison.
Pour qui construit des agents, les aspects pratiques comptent plus que la diapositive d'architecture. Le modèle gère une fenêtre de contexte de 256K, donc il peut tenir une longue base de code ou une pile de documents en une seule passe. Selon StepFun, il atteint 74,4 % sur SWE-bench Verified et 51,0 % sur Terminal-Bench 2.0, le genre de résultat que vous voulez quand un modèle doit planifier sur de nombreuses étapes et appeler des outils sans dériver.
Les limites méritent d'être énoncées clairement. Les chiffres publiés des benchmarks viennent de StepFun elle-même. Considérez-les comme des affirmations de l'éditeur tant que des tests indépendants ne les confirment pas. De plus, il n'a pas de compréhension d'image intégrée dans cette version, donc tout ce qui est visuel doit passer par un modèle distinct. Et même s'il tourne sur du matériel grand public haut de gamme, « haut de gamme » fait beaucoup de travail ici : un Mac Studio M4 Max ou un NVIDIA DGX Spark, pas un portable ordinaire.
Premiers pas
- Choisissez une voie d'accès. Utilisez l'API hébergée de StepFun pour un démarrage rapide, ou récupérez les poids ouverts sur GitHub ou ModelScope si vous voulez l'exécuter sur votre propre machine.
- Obtenez une clé d'API dans la console de la plateforme StepFun, pointez votre client vers le point de terminaison compatible OpenAI (URL de base https://api.stepfun.com/v1) et réglez le modèle sur step-3.5-flash.
- Envoyez une première requête via n'importe quel SDK de style OpenAI, en commençant par un prompt court pour confirmer que la connexion fonctionne.
- Pour le travail d'agent ou de code, branchez le modèle sur votre boucle d'outils et laissez-le appeler des fonctions ou exécuter du code sur plusieurs tours.
- Montez en charge. Augmentez la fenêtre de contexte pour les entrées longues et passez au déploiement local si la confidentialité des données est prioritaire.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de StepFun.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs qui construisent des agents
- Ingénieurs soucieux de la confidentialité
- Chercheurs et bricoleurs
Tâches
- Codage agentique
- Analyse à contexte long
- Automatisation à haut débit
Cas d'usage
- Faire tourner un agent de code toute la nuit
- Analyser un grand ensemble de documents
- Construire un assistant privé
Fonctionnalités clés
Architecture MoE clairsemée avec 11B paramètres actifs
Step 3.5 Flash conserve un réservoir de 196B paramètres mais n'active qu'environ 11B par token. Petite part, grand modèle. Le résultat se rapproche de la vitesse d'un petit modèle avec une bonne part de la profondeur de raisonnement d'un grand, ce qui est exactement le compromis dont les charges de travail d'agent ont besoin.
Génération à grande vitesse avec MTP-3
Grâce à la prédiction multi-token à 3 voies, le modèle génère 100 à 300 tokens par seconde en usage normal, avec des pics proches de 350 tokens par seconde sur les tâches de code à flux unique. Pour qui attend de longues chaînes de raisonnement, cette vitesse fait la différence entre un outil que vous utilisez et un outil que vous évitez.
Contexte de 256K avec attention hybride
Le modèle associe une attention à fenêtre glissante à une attention complète dans un rapport de 3:1, donc la plupart des couches regardent une fenêtre locale tandis que quelques-unes couvrent toute la séquence. Cela garde les performances stables sur les entrées longues tout en réduisant le calcul qui accompagne d'ordinaire une grande fenêtre de contexte.
Bons benchmarks de code et d'agent
Selon StepFun, le modèle obtient 74,4 % sur SWE-bench Verified et 51,0 % sur Terminal-Bench 2.0. Ce sont les tests qui suivent si un modèle termine réellement un vrai travail d'ingénierie, pas seulement s'il répond à des questions triviales.
Poids ouverts et déploiement local
Les fichiers du modèle sont ouverts sur GitHub et ModelScope, et il tourne sur du matériel comme le Mac Studio M4 Max, le NVIDIA DGX Spark et l'AMD AI Max+ 395. L'exécuter vous-même signifie que vos données restent locales et que vous évitez entièrement les frais par token.
API compatible OpenAI
Le point de terminaison hébergé de StepFun parle le format de l'API OpenAI, donc les SDK et clients existants fonctionnent avec un simple changement d'URL de base. Il existe aussi un palier gratuit sur OpenRouter, qui vous laisse tester des configurations d'agent avant de vous engager sur un usage payant.
Avantages et inconvénients
Avantages
- La génération rapide (100 à 300 tok/s, jusqu'à 350 en code) convient aux agents et aux outils interactifs.
- La fenêtre de contexte de 256K gère de grandes bases de code et des ensembles de documents en une seule requête.
- Les poids ouverts vous laissent l'exécuter en local et garder les données privées.
- De bons résultats publiés sur les benchmarks de code et de terminal.
- L'API compatible OpenAI simplifie la migration depuis d'autres fournisseurs.
Inconvénients
- Les chiffres des benchmarks viennent de StepFun, donc la vérification indépendante reste mince.
- Le déploiement local exige du matériel haut de gamme, pas un portable standard.
- Pas de compréhension d'image ni multimodale intégrée dans cette version.
Questions fréquentes
Il est conçu pour les tâches qui demandent un raisonnement rapide et l'usage d'outils, comme les agents de code, les flux automatisés et l'analyse à contexte long. Sa vitesse et sa fenêtre de contexte le rendent apte aux pipelines où de nombreuses requêtes s'enchaînent.
Contenus associés
Découvrez des outils, des compétences et des articles liés à StepFun.
Alternatives à StepFun

Odyssey 3
Odyssey · AutresOdyssey-3 est le modèle du monde fondationnel d'Odyssey. Il simule la physique en temps réel, transforme une consigne en environnement interactif et s'adapte aux robots, voitures et jeux.

JarvisCore
Prescott Data · Programmation · Productivité · AutresJarvisCore est un runtime Python open source où les agents IA travaillent en pairs sur un maillage, prennent les tâches dans un registre partagé et joignent les services externes via un broker zero trust.
Clef
Cloudflare · Entreprise · AutresClef est le modèle de décision open source de Cloudflare pour Workers AI. Il renvoie des probabilités calibrées pour des questions typées au lieu de texte, ce qui permet à un agent de classer, router et agir vite.