

Confident AI
Confident AI · その他
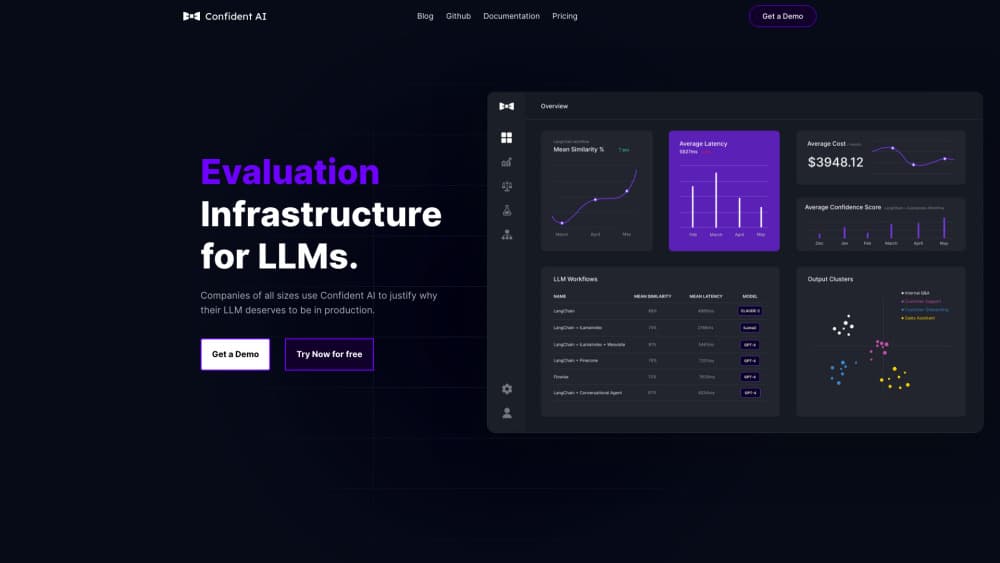
Confident AIはオープンソースのDeepEvalを土台にしたLLM評価プラットフォームだ。公開前のAIアプリをテストし、研究に裏打ちされた指標で回答を採点し、公開後は実際のトラフィックを監視できる。
Confident AI について
About
Confident AIとは
Confident AIは、大規模言語モデルを使ったアプリをテストし監視するためのWebプラットフォームだ。多くのチームが詰まるのは「プロンプトを変えてもモデルを差し替えても、チャットボットもRAGパイプラインもエージェントも壊れていない」と示す部分である。テストケースはPythonでもブラウザでも書ける。アプリに対して実行すれば、指標ごとのスコアと、その根拠となる文章が返ってくる。
開発元は、プラットフォームの指標を支えるオープンソースの評価フレームワークDeepEvalも保守している。これは実務で効く。同じ検査を手元のDeepEvalで回し、結果だけをConfident AIに送ってチームで共有できる。品質判断が特定ベンダーの黒箱に閉じない。
いちばん厳しい制約は価格だ。無料枠はプロジェクト1件、2席、週5回のテスト実行まで。本格利用は月200ドルのStarterからになる。たまに確認するだけの用途では、この金額は正当化しにくい。
はじめかた
- confident-ai.comで無料アカウントを作り、プロジェクト設定からAPIキーをコピーする。
pip install -U deepevalでSDKを入れ、deepeval loginを実行してローカルのフレームワークをクラウドのプロジェクトにつなぐ。- Pythonファイルに指標とテストケースを定義する。有料プランならブラウザのノーコード画面から作ってもよい。
- テストを実行し、ダッシュボードで指標ごとのスコアを確認して、レポートのリンクをチームに共有する。
AIツール情報
Confident AIの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- RAGパイプラインやエージェントを作るAIエンジニア。指標ライブラリにコンテキスト召回、忠実性、ツール呼び出しの正しさ、タスク完了がそろっているので、採点ロジックを一から書かずに済む。
- AI機能を担当するプロダクトマネージャー。ノーコードの評価フローなら、プロンプトを直してそのまま検査を回せる。エンジニアにチケットを切る必要はないが、有料席が要る。
- LLMテストに踏み出すQAチーム。回帰テストは新しい版を保存済みの基準と比べるので、既存のリリース手順にそのまま乗る。
タスク
- 公開前にハルシネーションを捕まえる。忠実性とハルシネーションの指標が、検索したコンテキストと回答を突き合わせて採点し、点数から失敗した事例へたどれる。
- モデルやプロンプトの設定を2案で比べる。並列実験は同じデータセットを両方の版に通し、どの指標がどれだけ動いたかを出す。
- 本番の失敗をテストケースに変える。トレースはデータセットとして切り出せるので、火曜に出たひどい回答が恒久的な回帰チェックになる。
- 顧客向けチャットボットのレッドチーミング。敵対的テストはインジェクション、有害出力、ポリシー違反を扱い、結果はレビュー用の証拠として残る。
シーン
- 毎週モデルを入れ替えるスタートアップ。CIでの自動評価が、ユニットテストでは見えない品質低下を拾う。
- 複数のプロダクトチームで評価基準をそろえたい企業。同じ指標定義がどこでも適用され、ガバナンスの関門が不合格の版を止める。
- すでに本番で動くサポートボット。オンライン評価が実際のトラフィックを採点し、精度がずれたら警告を出す。
主な機能
研究に基づく指標ライブラリ
DeepEvalを土台にした50以上のAI評価メトリクスを搭載し、単一ターンとマルチターンの両方を扱う。回答の関連性、忠実性、コンテキストの精度と召回、ハルシネーション、バイアス、有害性、そしてツール呼び出しの正しさのようなエージェント向けの検査がそろう。標準の指標が合わないときは、カスタムG-Evalで判定基準を自然言語で書ける。
マルチターン会話のシミュレーション
1回の返答を採点するのではなく、シミュレーターがアプリ相手に会話を最後まで演じ、やり取り全体を評価する。数往復してから出る不具合、たとえば前に承諾した条件を忘れるボットのような問題が見つかる。ペルソナと目標を決めれば、発話はプラットフォームが生成する。
CI/CDでの回帰テスト
LLM回帰テストはGitHub Actions、GitLab CI、Jenkins、APIを呼べる任意のパイプラインで動く。指標が落ちれば、壊れたユニットテストと同じようにマージを止められる。実行はすべて保存されるので、版ごとに比べてスコアが落ちた地点を特定できる。
本番トラフィックのAIオブザーバビリティ
トレーシングが本番アプリのリクエスト、スパン、スレッドを記録し、それぞれに指標スコアを付ける。低スコアでの絞り込み、時間経過のドリフト検出、同じ出力の繰り返しやユーザーのいらだちを示す信号へのアラート設定ができる。他のツールから移る場合もOpenTelemetryのスパンはそのまま持ち込める。
人手アノテーションと指標の突き合わせ
アノテーションキューを使えば、業務の専門家が自社の基準で出力を確認できる。そのあとプラットフォームが人手のラベルと指標スコアを並べ、食い違う箇所を示す。この差が有用で、リリースの関門に使う前に、その指標が緩すぎないか判断できる。
ノーコードのワークフローとMCP連携
有料プランでは、評価の宛先を稼働中のAPIエンドポイントに向け、応答を整形し、定期的な実行を予約できる。コードは要らない。MCPサーバーを使えば、CursorやClaude Codeのコーディングエージェントがエディタから評価を実行し、結果を取得できる。
メリットとデメリット
メリット
- DeepEvalがオープンソースなので、検査を手元で回し、指標のコードを読める。閉じた採点エンジンを信じる必要がない。
- スコアには必ず説明が付く。テストを書いていない人でも失敗の理由をたどれる。
- トレーシングと評価が同じ場所にあり、本番データがそのまま新しいテストケースになる。
- 連携はよく使う構成を押さえている。OpenAI、Claude、Gemini、Bedrock、LangChain、LlamaIndex、CrewAI、OpenTelemetry。
- 企業向けの制御としてSSO、独自RBAC、SOC 2、HIPAA、オンプレミス配備がある。
デメリット
- 無料枠はプロジェクト1件、2席、週5回の実行まで。試すには足りるが、それ以上は無理だ。
- チームでの実運用は月200ドルから。個人開発や小さな案件には重い。
- ノーコード評価、オンライン評価、アラートは有料機能で、無料枠はPythonが書ける前提のままになる。
- 判定モデルの呼び出し費用は自腹で、データセットが大きく強いモデルを使うほど請求が膨らむ。
よくある質問
LLMアプリをテストし監視する。テストケースと指標を定義してアプリに実行すると、説明付きのスコアが返る。同じプラットフォームが本番トラフィックを見張り、届いたリクエストを採点する。
関連コンテンツ
Confident AIに関連するツール、スキル、記事を探す。
Confident AIの代替ツール

Odyssey 3
Odyssey · その他Odyssey-3はOdysseyの基盤ワールドモデルだ。物理をリアルタイムにシミュレーションし、プロンプトからインタラクティブな環境を生成して、ロボットや車、ゲームに適応する。

JarvisCore
Prescott Data · コーディング · 生産性向上 · その他JarvisCore は、AI エージェントが対等なピアとしてメッシュを組み、共有台帳からタスクを引き受け、ゼロトラストのブローカー経由で外部サービスを呼ぶオープンソースの Python ランタイムである。
Clef
Cloudflare · ビジネス · その他Clef は Workers AI で動く Cloudflare のオープンソース意思決定モデルだ。生成テキストではなく、型付きの設問に確率を返す。エージェントは素早く分類し、振り分け、行動できる。