
Deep Live Cam
hacksider · 画像 · 動画
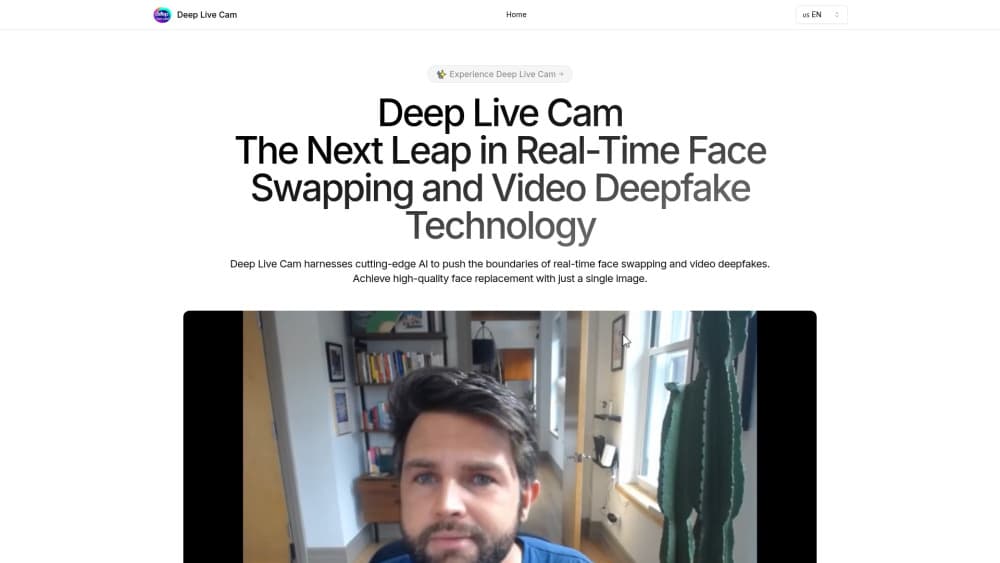
Deep Live Camは、写真1枚からWebカメラのライブ映像や録画済みの動画の顔を差し替えられる無料のオープンソースツールだ。処理はすべて自分のPC上で完結する。
Deep Live Cam について
About
Deep Live Camとは
Deep Live Camは、オープンソースプロジェクトhacksiderが公開しているデスクトップ向けのAI 顔交換アプリだ。使いたい顔の写真を1枚読み込み、Webカメラか動画ファイルを指定すると、映っている人物の顔をフレームごとに置き換えていく。
魅力はコストにある。同種のサービスはたいてい素材のアップロードを求め、順番待ちをさせ、書き出しごとに料金を取る。こちらは計算を自分のGPUで回すため、Webカメラ顔交換のライブ配信を何本やっても、手持ちの機材以外に出費はない。
その代わり、導入の壁は高い。無料版にインストーラーは付いておらず、公式READMEにも手動インストールは初心者向けではないと明記されている。Python、ffmpeg、2つのモデルファイル、そしてドライバとの格闘が必要だ。倫理面もはっきりしている。これはディープフェイクソフトであり、開発者は本人の同意取得と、公開時の合成表示を求めている。
はじめかた
- 自分の環境向けのビルド済み版を入れるか、リポジトリを複製してPythonとffmpegを用意する。
- gfpganとinswapperの2つのモデルをダウンロードし、modelsフォルダに置く。
- アプリを起動し、元になる顔写真を選んでからWebカメラか対象の動画を指定する。
- ライブならLive、ファイル出力ならStartを押す。配信する場合はOBSなどでウィンドウをキャプチャする。
AIツール情報
Deep Live Camの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- 配信者やVTuber:自分の映像にWebカメラ顔交換を重ねられる。フレームレートに追いつくGPUが前提だ。
- 動画編集者やミーム制作者:書き出しごとの課金なしでワンクリック動画ディープフェイクを作れる。Pythonの依存関係を自分で入れる手間を惜しまない人向け。
- 開発者や工作好き:ソースを読み、モデルを差し替え、CLIをスクリプトに組み込める。プロジェクト全体がAGPLのオープンソースだ。
タスク
- 録画済みのクリップの顔を差し替える:写真と動画を読み込み、Startを押す。元の音声を残したまま新しいファイルが書き出される。
- キャラクターの姿で配信する:顔を選び、カメラを選び、導入済みなら3クリックほどでライブに移れる。
- 複数の人物に別々の顔を当てる:フェイスマッピングで、画面内の人物ごとに違う元写真を割り当てられる。
シーン
- 別のツールで作ったキャラクターとして配信する:AIポートレートや3Dレンダーを読み込ませ、その顔でリアルタイムに演じる。
- SNS向けのリアクション動画を撮る:短いクリップの顔を友人と入れ替え、投稿前に編集済みだと明示する。
- 別の演者でシーンを確認する:衣装や配役の案を自分の素材で試し、撮り直しを避ける。
主な機能
写真1枚での顔交換
仕組みは元画像1枚で完結する。モデルの学習も写真セットのアップロードも要らない。この軽さのおかげで、これだけ小規模な顔交換ツールがノートPCでも動く。
リアルタイムWebカメラモード
Liveモードはカメラ映像を交換処理に通し、結果をプレビューウィンドウに映す。最初のフレームまで数秒かかり、その後は動きに合わせて更新される。OBSなどのキャプチャツールでそのウィンドウを取り込めば配信できる。
複数人向けフェイスマッピング
フェイスマッピングでは、カメラに映る人物ごとに別の元の顔を割り当てられる。同じ画角に2人か3人がいても、それぞれ違う顔を同時に持てる。出回っているグループ動画の多くはこの機能で作られている。
マウスマスク
マウスマスクは口元の動きだけ元のまま残し、顔の他の部分を差し替える。これがないと、話しているときに顔が平坦に見える。モデルは唇がどう動いているかを知らないからだ。
フェイスエンハンサー
書き出し前に、GFPGANで交換部分をくっきりさせる工程が入る。低解像度の素材や古いWebカメラで効果が出やすく、その分フレームあたりの処理時間は増える。
ハードウェアアクセラレーション
同じコードがNvidiaのCUDA、AppleのCoreML、WindowsのDirectML、IntelのOpenVINO、そしてCPUだけで動く。実行プロバイダの選択が、滑らかなリアルタイム顔交換とスライドショーの分かれ目になる。モデルのせいにする前にREADMEのフラグを確認したい。
メリットとデメリット
メリット
- 無料でローカル動作:データはPCの外に出ず、書き出しごとの課金もクレジット購入もない。
- 相応のGPUなら速い:ミドルクラスのNvidiaならライブでも目立つ遅れは出ない。Apple SiliconのMacにはCoreMLの経路も用意された。
- 写真1枚で足りる:学習も写真セットもアカウント登録も不要だ。
- オープンソース:コード、モデル、イシューが公開されているので、ソフトが実際に何をしているか自分で確かめられる。
デメリット
- 導入が面倒:無料版はPython、ffmpeg、モデル取得、適切なドライバが必要で、ターミナルに触れたことがない人には厳しい。
- 難しい角度で破綻する:横顔、素早い首振り、顔の前を横切る手で、合成はすぐに見破られる。
- APIもホスト型サービスもない:操作はデスクトップアプリかCLIのフラグ経由に限られ、自社製品から呼び出す手段はない。サポートもGitHubとDiscordが中心だ。
よくある質問
ライブのカメラ映像や動画ファイルの顔を、写真1枚から取った別の顔に差し替える。結果はプレビューにリアルタイムで出るか、新しい動画ファイルとして保存される。
関連コンテンツ
Deep Live Camに関連するツール、スキル、記事を探す。
Deep Live Camの代替ツール

Google EmbeddingGemma 2
Google DeepMind · ライティング · 画像 · コーディングGoogle EmbeddingGemma 2 は 7 億 4000 万パラメータのオープンなモデルで、テキスト、コード、画像、音声、動画フレームを同じ 768 次元空間のベクトルに変え、スマートフォンやノート PC 上で動く。

Tractionwave
TractionWave · 画像 · マーケティングTractionWaveは静止画広告のアテンションヒートマップを作るAIツールだ。PNGかJPGを入れると、予測された注目位置、優先順位付きホットスポット、修正案が返る。予算を投じる前の判断に使う。

Imejis.io
Imejis.io · 画像 · マーケティングImejis.io はエージェントとマーケティングチームのための AI デザインスタジオだ。ふだんの言葉で画像を説明すれば、コピーを書き、レイアウトを組み、全サイズへ自動で組み替え、完成ファイルを書き出す。