
extract by Firecrawl
Firecrawl · コーディング
extract by Firecrawl は、任意の URL やドメイン全体を構造化 JSON に変える Firecrawl API のエンドポイントである。リンクとプロンプトかスキーマを渡すと、指定したフィールドを返す。
extract by Firecrawl について
What Is extract by Firecrawl
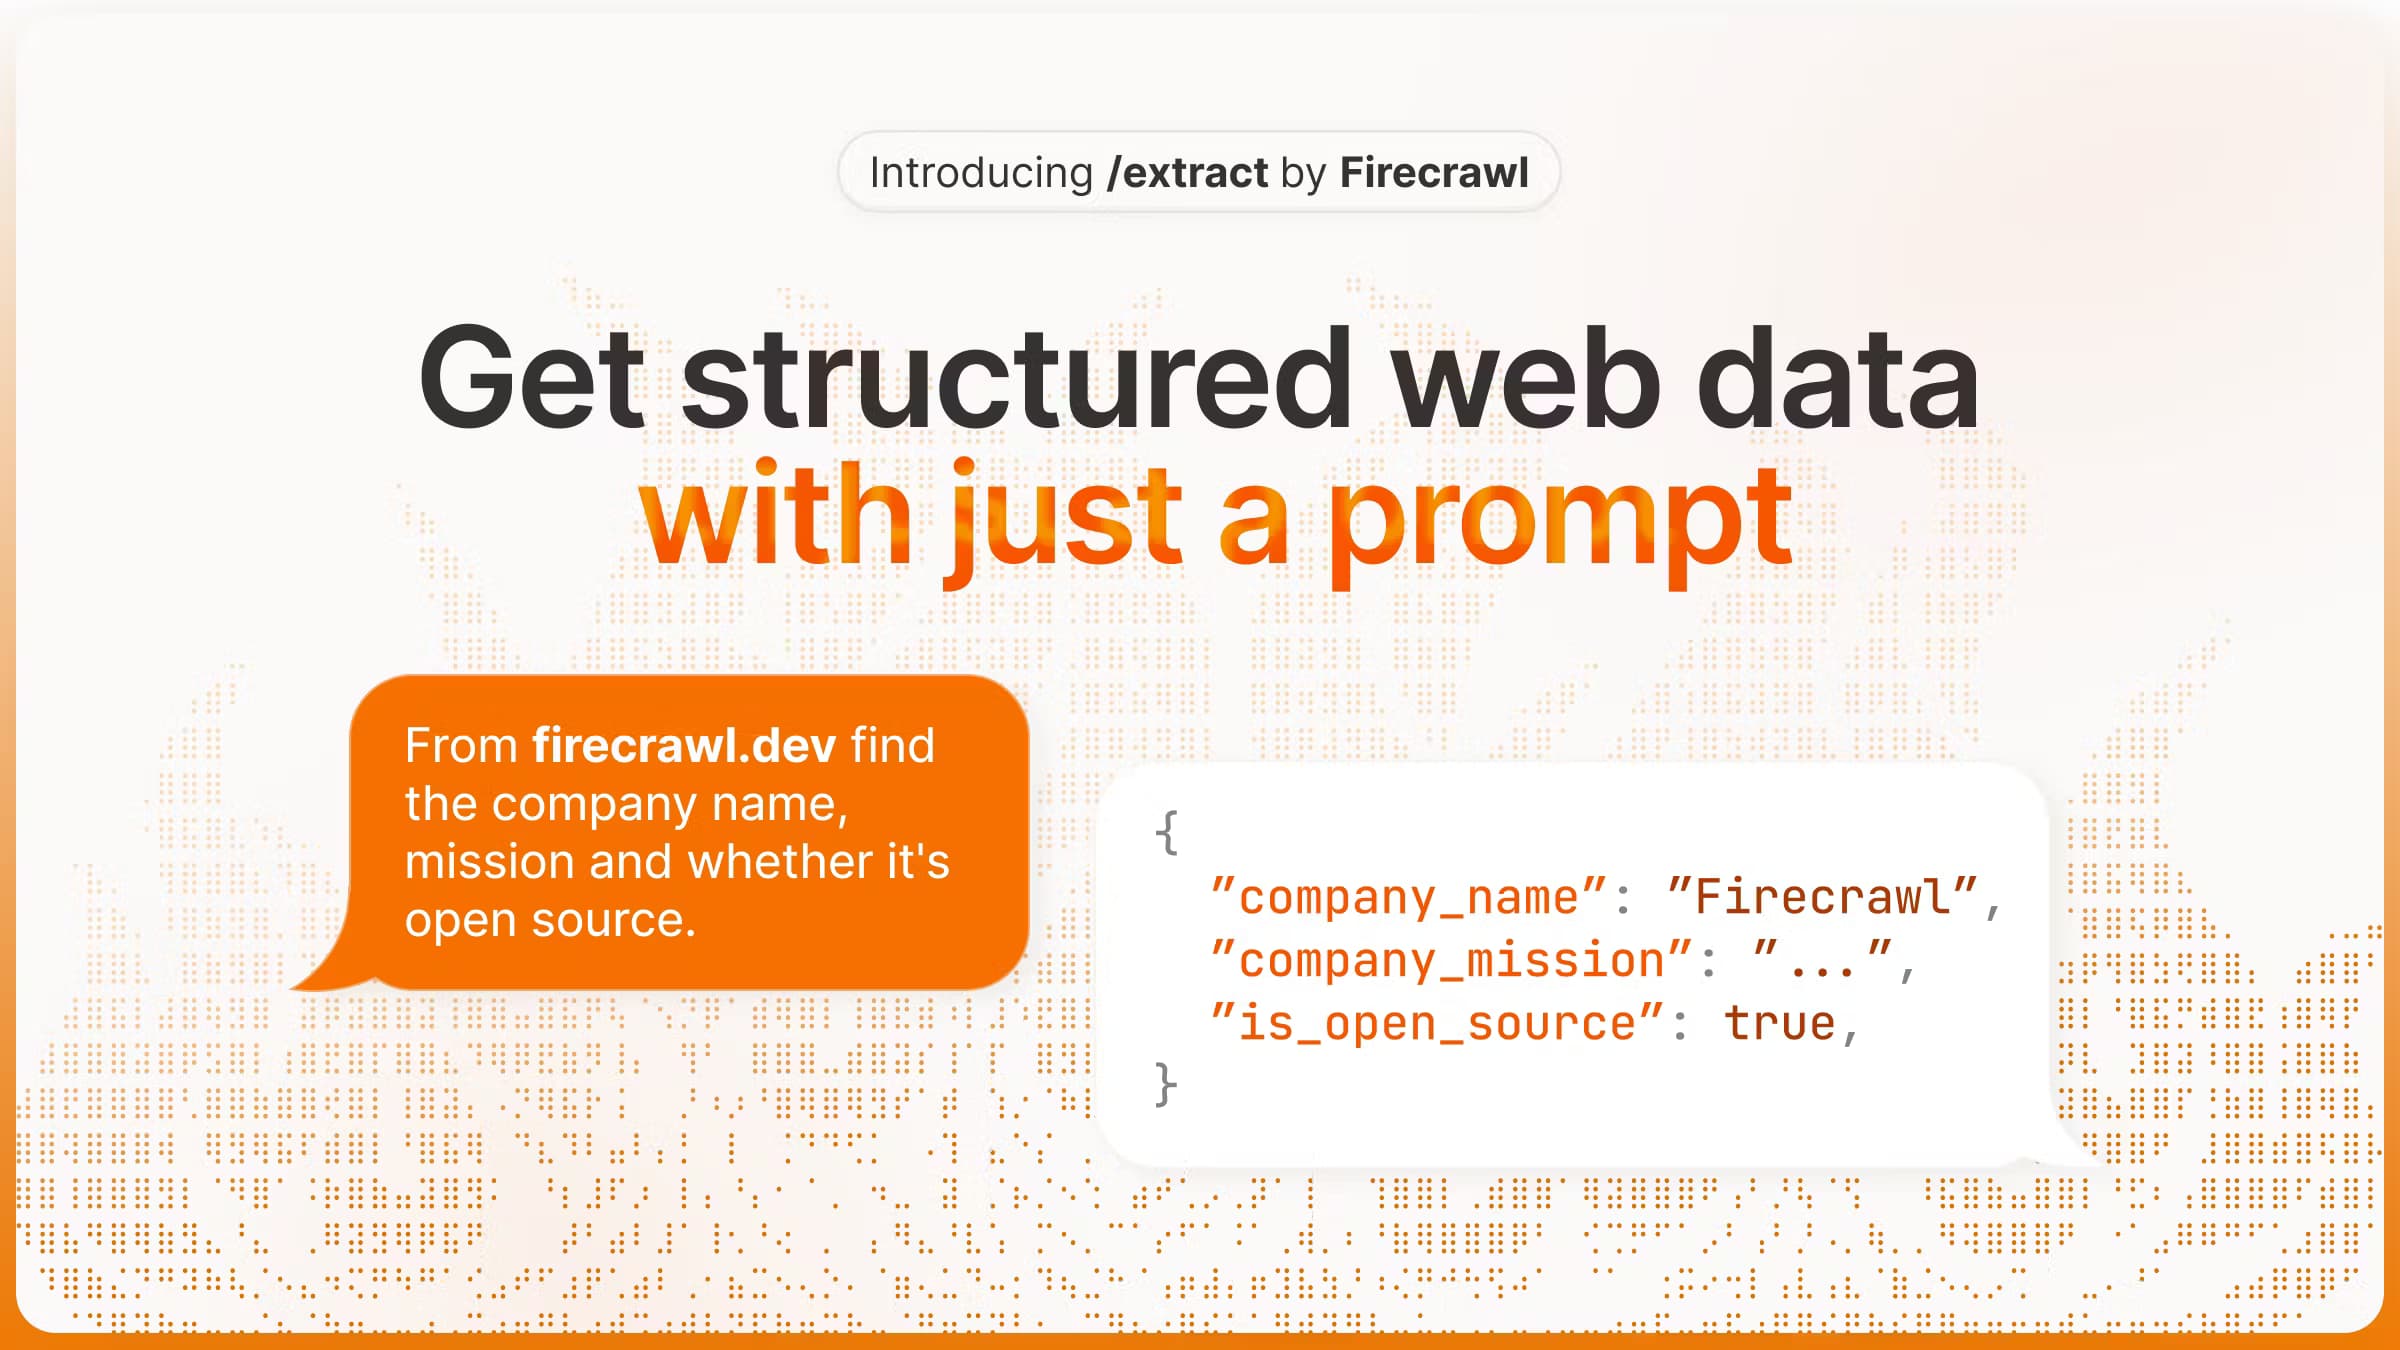
extract by Firecrawl は、AI アプリ向けの Web データ API である Firecrawl の /extract エンドポイントだ。指定したページをスクレイプし、言語モデルで特定のフィールドを JSON として抜き出す。サイトごとにセレクタを手書きする代わりに、欲しいデータを言葉で説明するか JSON スキーマを渡せば、整理済みの値が返ってくる。
このエンドポイントはスクレイピングの厄介な部分を引き受ける。JavaScript 主体のページ、bot 対策、サイトごとのレイアウト変更だ。1 ページ、複数ページ、あるいは example.com/* のようなワイルドカードでドメイン全体を対象にでき、Firecrawl は見つけたページをクロールしてから抽出する。繰り返し使えるレコードや価格、企業情報をそのままデータベースや後工程に流したいチームに向く。
使い方を決める制約は 2 つある。extract は非同期ジョブとして動くので、URL を送ってジョブ ID を問い合わせる形になり、即時の応答は得られない。もう 1 つ、Firecrawl は新しい作業を後継の /agent に誘導しており、そちらは URL を自分で見つける。extract は今も動くが、旧来の経路だ。
Getting Started
- firecrawl.dev で登録し、ダッシュボードから API キーをコピーする
- SDK を入れて(pip install firecrawl-py または npm install firecrawl)、キーでクライアントを初期化する
- extract を呼び出す。URL のリスト、フィールドを説明するプロンプト、固定の形が欲しいなら JSON スキーマを渡す
- 返ってきたデータを読む。長時間の実行で start メソッドを使ったなら、ジョブ ID を問い合わせる
AIツール情報
extract by Firecrawlの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- AI アプリを作る開発者:稼働中のサイトから LLM 向けのきれいなデータが要り、スクレイパーを保守するより API を呼びたい人
- データと分析の担当チーム:価格や出品、企業情報を定期的に集め、生の HTML ではなく構造化 JSON で欲しいアナリスト
- 市場調査中の創業者:競合や市場のデータを素早く必要とし、スクレイピング担当を雇いたくない小さなチーム
- 自動化を組む人:Web データをパイプラインやダッシュボード、決まったフィールドを期待するエージェントにつなぐ人
タスク
- 大量のページからレコードを抽出する:1 回のジョブで URL のリストやドメイン全体から同じフィールドを引き出す
- 雑然としたページを JSON にする:記事や商品ページ、出品情報をデータベース用のきれいな構造化出力に変換する
- 価格と在庫を監視する:定期実行で複数サイトの変化を追う
- RAG 用の知識ベースを組む:検索や取得の仕組みに食わせる構造化事実を Web から集める
- 複数ソースのデータを突き合わせる:同じスキーマで別々のサイトから項目を集め、結果を比較できるようにする
シーン
- 調査チームが毎週競合の価格を追う:extract を商品ページ群に向け、返ってきた JSON を保存する
- 開発者が AI アシスタントに最新の Web 事実を渡す:extract がエージェントに必要なフィールドを返し、自作パーサーが要らない
- 創業者が初めて市場をざっと見る:1 つのドメインへのジョブが、確認できるきれいな一覧表を返す
- 運用チームがディレクトリを最新に保つ:定期抽出が変わった住所や連絡先を拾う
- データエンジニアが散らばったソースを整える:1 つのスキーマで複数サイトの同じフィールドを 1 ファイルにまとめる
主な機能
プロンプトかスキーマで構造化データを抽出
extract には 2 通りの使い方がある。欲しいデータを自然言語のプロンプトで書けば、モデルが妥当な形を選ぶ。JSON スキーマを渡せば、定義したとおりのフィールドと型で毎レコードが返る。データベース向けに安定した形が要るチームはスキーマを選び、未知のサイトを探る人はまずプロンプトで始めて後から詰める。
ワイルドカードでドメイン全体を抽出
extract は 1 ページ、短いリスト、サイト全体のいずれにも向けられる。example.com/* のようなワイルドカード付き URL を渡すと、Firecrawl はドメインをクロールし、見つけたページを読んでからフィールドを抽出する。サイト全体の探索が 1 回の呼び出しで済み、URL のリストを自分で組み立てなくていい。ドメイン全体のモードは実験的とされており、結果の確認は欠かせない。
Web 検索による補強
Web 検索のオプションを有効にすると、抽出は渡した URL の外まで及ぶ。Firecrawl が関連ページをたどって足りない文脈を埋めるので、1 ページに必要な情報が載っていないときに役立つ。公式の例では、1 つの商品ページから出発し、検索で網を広げてドライブレコーダーの価格や機能、レビューを引き出している。
非同期ジョブとステータス確認
extract はブロックする呼び出しではなくジョブとして動く。リクエストを送るとジョブ ID が返り、status エンドポイントを completed と報告されるまで問い合わせる。状態は completed、processing、failed、cancelled の 4 つで、キューやバックグラウンドのワーカーに組み込める。ジョブの結果は完了後 24 時間、API から取得できる。
Python と Node の公式 SDK
Firecrawl は Python と Node の SDK を出しており、HTTP 呼び出しを自分で書かなくていい。Python クライアントは Pydantic モデルをスキーマに、Node クライアントは Zod オブジェクトを受け付け、型付きで検証済みの出力が得られる。どちらも即座にジョブ ID を返す start メソッドと、ジョブの完了後に結果を取る status メソッドを備える。
エンドポイント間で共有するクレジット課金
extract は他のエンドポイントと同じくクレジットで課金される。Firecrawl の料金体系もこのクレジットを軸にしている。extract では 1 クレジットが 15 トークンに相当し、基本の scrape は 1 ページ 1 クレジットだ。クレジットは全エンドポイントで共有され、検索結果もクロールしたページも同じ残高から引かれる。抽出とクロールを混ぜたジョブでも費用を見積もりやすい。
Agent への移行路が文書化されている
Firecrawl は extract を旧来のツールと位置づけ、新しい作業を後継の /agent に誘導する。Agent はプロンプトとスキーマの選択肢を保ちつつ、URL の必須条件を外したので、自分で検索して回れる。「このデータを Web のどこかで見つけたい」なら Agent が道だ。URL が既に分かっているなら、extract が今も役に立つ。
メリットとデメリット
メリット
- プロンプトか JSON スキーマの出力で、サイトごとのセレクタを手書きせずに済む
- ワイルドカード URL なら 1 回のジョブでドメイン全体を覆え、ページ一覧を自分で組まなくていい
- 公式の Python と Node SDK が Pydantic と Zod に対応し、型付きで検証済みの結果を返す
- クレジット課金はエンドポイント間で共有され、複数の作業を混ぜたジョブでも費用が読みやすい
- 毎月 1,000 クレジットの無料枠があり、カードなしで軽い検証ができる
デメリット
- 抽出が非同期なので、即時の応答が要るリクエストには組み込めない
- Firecrawl は新規利用者を Agent に誘導しており、extract は旧来の経路で新しいツールに後れを取る
- ワイルドカードのドメイン全体抽出は実験的とされ、広いクロールでは結果の確認が要る
- ジョブの結果は 24 時間で API から消え、長期保存は自分の仕事になる
- 403 や 404 などのエラー状態を返すページでも 1 クレジットを消費する
よくある質問
Firecrawl という Web データ API の /extract エンドポイントだ。URL とプロンプト、または JSON スキーマを渡すと、言語モデルが指定したフィールドを構造化 JSON で返す。レイアウトが揃っていないページから繰り返し使えるレコードを取り出すのに向く。
関連コンテンツ
extract by Firecrawlに関連するツール、スキル、記事を探す。
extract by Firecrawlの代替ツール
Forefront
Forefront · コーディングForefrontはオープンソースAIで構築するためのウェブプラットフォームだ。主要なオープンソース言語モデルを自分のデータで微調整し、性能を評価し、API経由で実行したり、エクスポートして自分でホストしたりできる。クローズドなプラットフォームの手軽さを求めつつ、モデルとデータの所有権にはこだわる開発者が対象だ。

Startkit
StartKit.AI · コーディングStartkitは、AI SaaSとAIラッパー製品を作るためのボイラープレートだ。面倒な部分をあらかじめ配線済みにしたAIスタートアップボイラープレートと考えればいい。認証、StripeとLemon Squeezyの決済、利用制限、トランザクションメール、そしてOpenAI、Anthropic、Groq、Llamaと通信するAI APIスターターキットが含まれる。リポジトリをクローンして価格を設定し、ユーザーが実際にお金を払う部分に取りかかれる。ReactとTailwind上のNext.jsで作られているため、ボイラープレートコードの多くはすでに見慣れたものだ。
Testim
Tricentis · コーディングTestimは、Web・モバイル・Salesforceアプリ向けにエンドツーエンドテストを構築して実行するAIテスト自動化プラットフォームだ。機械学習を頼りに、インターフェースが変わってもテストを安定させ、チームが壊れたセレクターの修正に費やす時間を減らす。今日から使い始められる自動テストツールとしては悪くない。ブラウザで操作を録画してテストを作り、より細かい制御が必要なときはJavaScriptを足す。忙しいQAチームにとって堅実な選択肢である。