
FineTuner
FineTuner · その他 · チャットボット
FineTunerは、手持ちのPDFやサイト、動画といった自分のコンテンツでGPTまたはClaudeモデルを学習させ、そのまま使えるAPIを返すノーコードの基盤だ。
FineTuner について
What Is FineTuner
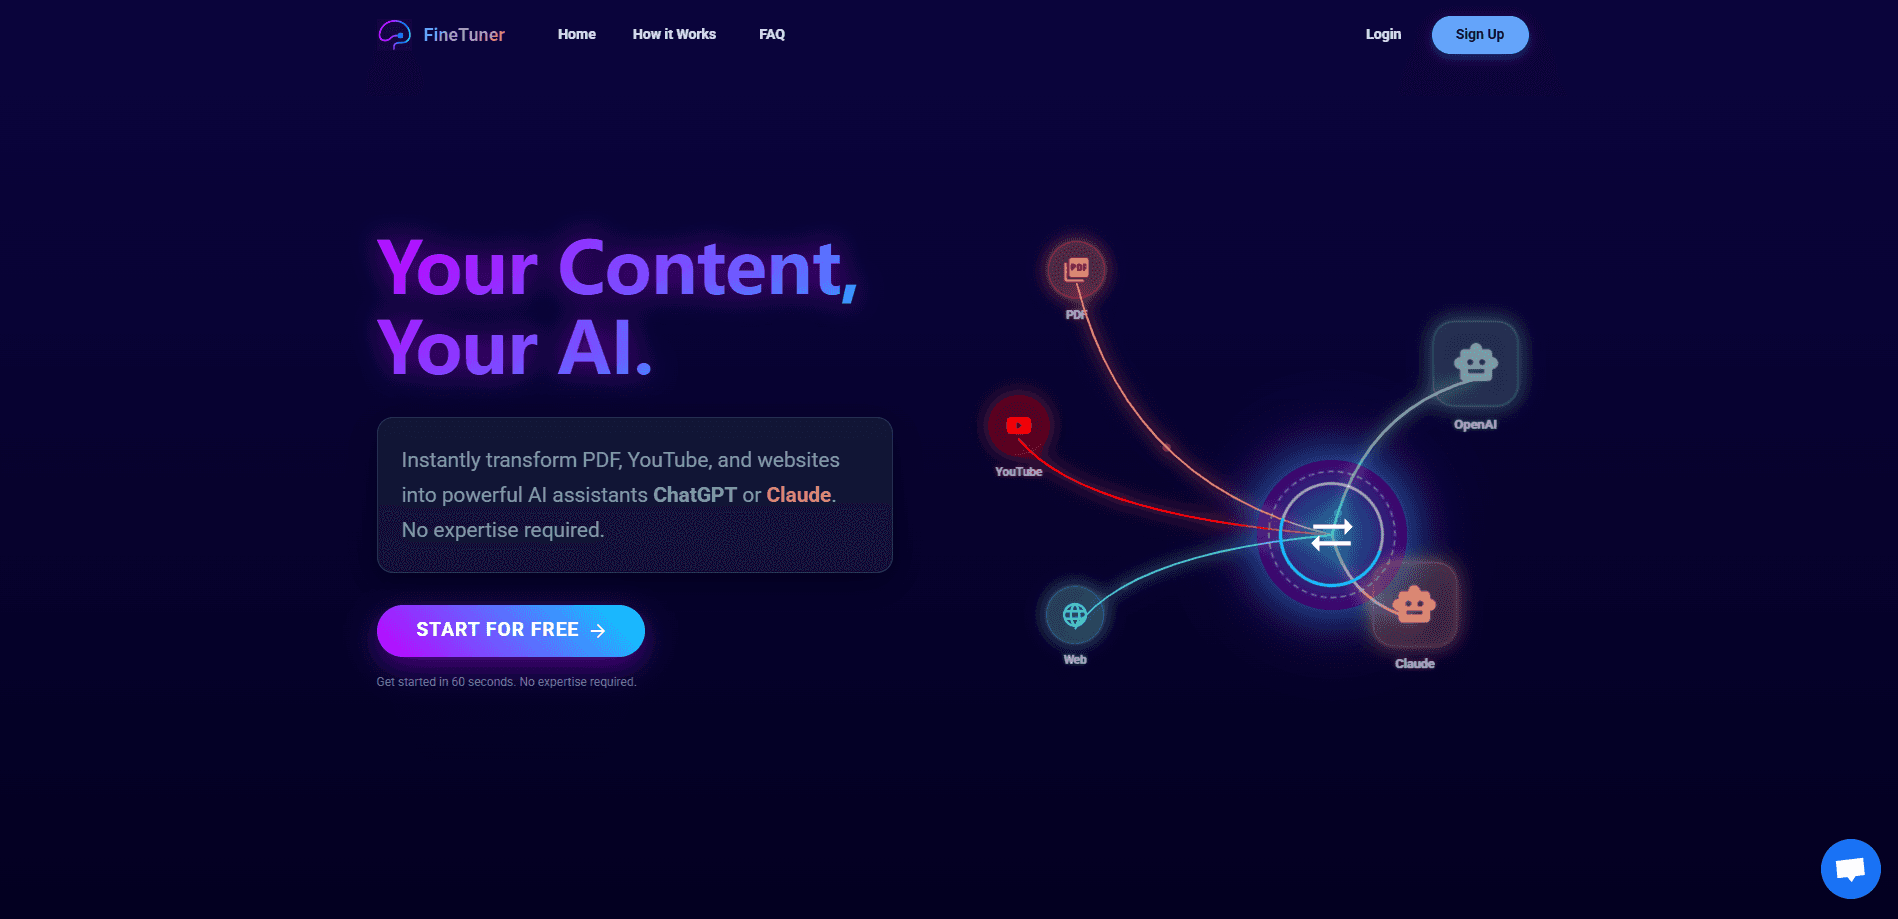
FineTunerは、開かれたインターネットではなく自分の資料について話す言語モデルを求める人向けのWeb基盤だ。すでに手元にある情報源(PDF、あるサイト、YouTube動画)を指定すると、データセットを組み立て、GPTまたはClaudeモデルにファインチューニングをかけ、APIから呼び出せるアシスタントを返す。狙いは、ファインチューニングの案件にまとわりつく下準備を丸ごと飛ばすことにある。
ファインチューニングとは、学習済みのモデルを取ってきて、自分のデータでさらに学習させ、自分の口調や事実、答え方を身につけさせる作業を指す。手作業でやるなら、JSONを書き、データの流れを組み、学習の様子をにらみ続けることになる。FineTunerが掲げるのは逆だ。コンテンツを上げて、クリックすれば、数日ではなく数分でモデルが手に入る。開発者によれば、この基盤はデータの取得と整形から学習、検証、公開用エンドポイントまで、一連の流れをまとめて受け持つ。
ただし、乗り出す前に限界は押さえておきたい。FineTunerは他社のモデルの上に載っている。学習データの量の上限や費用はそのまま引き継ぐし、結果の良し悪しは元になるコンテンツの質に左右される。このプロジェクトは2025年に登場し、2026年後半には元のサイト(finetuner.io)が製品を提供しなくなった。つまり、稼働中のサービスはすでに終わっている可能性がある。前提にして計画を立てる前に、現状を確かめてほしい。
Getting Started
- finetuner.ioでアカウントを作り、ダッシュボードにログインする。
- モデルに学ばせたいコンテンツを追加する。PDF、サイトのリンク、YouTube動画などだ。
- それらの情報源からデータセットを生成し、整形する処理を基盤に任せる。
- GPTやClaudeのチェックポイントなど、土台となるモデルを選び、ファインチューニングを開始する。
- 完成したモデルのAPIエンドポイントを取得し、自分のアプリやチャットボットにつなぐ。
AIツール情報
FineTunerの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- 個人開発者:機械学習の下地がなくても、学習のコードを書かずに自分のモデルを手に入れられる。
- 素材を大量に抱えるクリエイター:記事や動画、ガイドをたくさん持っている人は、それを自分の声で答えるアシスタントに変えられる。
- サポートやカスタマーサクセスのチーム:ヘルプ文書でチャットボットを学習させれば、返答が自社の言い回しになる。
- ML担当のいない小さな事業者:ノーコードの道なら、モデルを自分好みにするためだけに専門家を雇わずに済む。
タスク
- GPTモデルを学習させる:長いプロンプトに頼らず、GPTのチェックポイントを自分の資料に合わせる。
- Claudeモデルを学習させる:Anthropicのモデルの作風が自分のコンテンツに合うとき、同じことをそちらで行う。
- 学習データセットを組む:基盤が情報源を取り込み、使えるファインチューニング用データに整える。
- APIの後ろにモデルを配備する:出来上がったアシスタントにはエンドポイントが付き、アプリから呼び出せる。
- 文章の声を複製する:公開済みの文章でモデルを学習させ、同じ調子で書かせる。
シーン
- 何年分もの記事をQ&Aアシスタントに変えたいブロガー:基盤が記事の山を取り込み、そこから読者の質問に答える。
- 自社ブランドのサポートbotを出すスタートアップ:製品ドキュメントで学習させると、返答がその会社の口調になる。
- 自分の分身を試すクリエイター:投稿でモデルを学習させ、作風をまねたバージョンとファンが話せるようにする。
- AI機能を試作する開発者:使えるエンドポイントがあると、着想から利用者が試せる段階までの距離が縮む。
主な機能
ノーコードAIファインチューニング
中心にある約束は、学習のコードに触れなくていいという点だ。JSONを書いたり学習ループを組んだりせず、案内に沿って進める。おかげで、機械学習のエンジニアでない人にもモデルの調整が手の届くものになる。通常なら苦労する手順、たとえばデータセットを正しい形式に整える作業を、基盤側が引き受ける。
複数ソースからのコンテンツ取り込み
FineTunerは、すでに持っている材料から出発する。PDF、サイト、YouTube動画が入力として挙がっており、学習の前に知識ベースを書き直さなくてよい。基盤がそれらの情報源を取り込むので、最初のファインチューニング案件を長引かせる手作業のコピーを省ける。
データセットの自動生成と整形
データセットの質が、出来上がるモデルの出来を決める。手作業で組むこの工程で、多くの人がつまずく。FineTunerは自分のコンテンツから質の高いデータセットを生成し、学習を始める前に整える。生のファイルと使える学習案件との間の、最も雑然とした区間をここで埋める。
GPTとClaudeモデルの対応
どの土台モデルを調整するかは自分で選べ、一社に縛られない。GPTとClaudeのチェックポイントの両方が用意されており、求める作風や能力にモデルを寄せられる。結果は土台モデルの長所を保ちながら、自分のコンテンツを取り込む。
そのまま使えるAPIでの配備
学習が終わると、調整済みモデルのAPIエンドポイントが手に入る。アプリが呼べるものに変えるのは、まさにこのエンドポイントだ。サービスの層を自分で組まずに済む。ダッシュボードに収まったままのモデルか、世に出せるモデルかの違いになる。
端から端までの学習パイプライン
基盤は取り込み、整形、学習、検証、配備を一つの流れとして受け持つ。これらの段階をまとめて扱うからこそ、数日ではなく数分とうたえる。各手順で別々の道具を行き来しなくていいからだ。初心者が詰まる箇所も減る。
メリットとデメリット
メリット
- 大半の初心者を止める学習コードとデータ形式の壁を取り払い、技術者でない利用者でもモデルを調整できる。
- PDF、サイト、YouTube動画をそのまま受け付け、素材の山を持つクリエイターに合う。
- APIエンドポイントを返すので、出来上がったモデルを追加の配備なしでアプリに載せられる。
- GPTとClaudeの両方に対応し、一社だけではなく土台モデルを選べる。
デメリット
- 元のサイトが製品を提供しなくなっている。頼る前に、サービスがまだ動いているか確かめるべきだ。
- ファインチューニングは土台のGPTやClaudeモデルの制約を引き継ぐ。学習データ量の上限や追加費用も含む。
- 出力の質は元のコンテンツ次第で、素材が薄い、あるいは揃っていないと弱いモデルになる。
- 他社の上に載っているため、それらの提供元がファインチューニングの規則を変えると、価格や提供状況も動く。
よくある質問
言語モデルを調整するためのノーコード基盤だ。自分のコンテンツを渡すとデータセットを組み、それでGPTまたはClaudeモデルを学習させ、調整済みアシスタント用のAPIエンドポイントを返す。
関連コンテンツ
FineTunerに関連するツール、スキル、記事を探す。
FineTunerの代替ツール

Odyssey 3
Odyssey · その他Odyssey-3はOdysseyの基盤ワールドモデルだ。物理をリアルタイムにシミュレーションし、プロンプトからインタラクティブな環境を生成して、ロボットや車、ゲームに適応する。

JarvisCore
Prescott Data · コーディング · 生産性向上 · その他JarvisCore は、AI エージェントが対等なピアとしてメッシュを組み、共有台帳からタスクを引き受け、ゼロトラストのブローカー経由で外部サービスを呼ぶオープンソースの Python ランタイムである。
Clef
Cloudflare · ビジネス · その他Clef は Workers AI で動く Cloudflare のオープンソース意思決定モデルだ。生成テキストではなく、型付きの設問に確率を返す。エージェントは素早く分類し、振り分け、行動できる。