
Google Genie 2
Google DeepMind · 画像
Google Genie 2は1枚の画像を遊べる3D環境に変える、DeepMindの基盤世界モデルだ。AIエージェントの訓練とテストに使う。
Google Genie 2 について
Google Genie 2とは
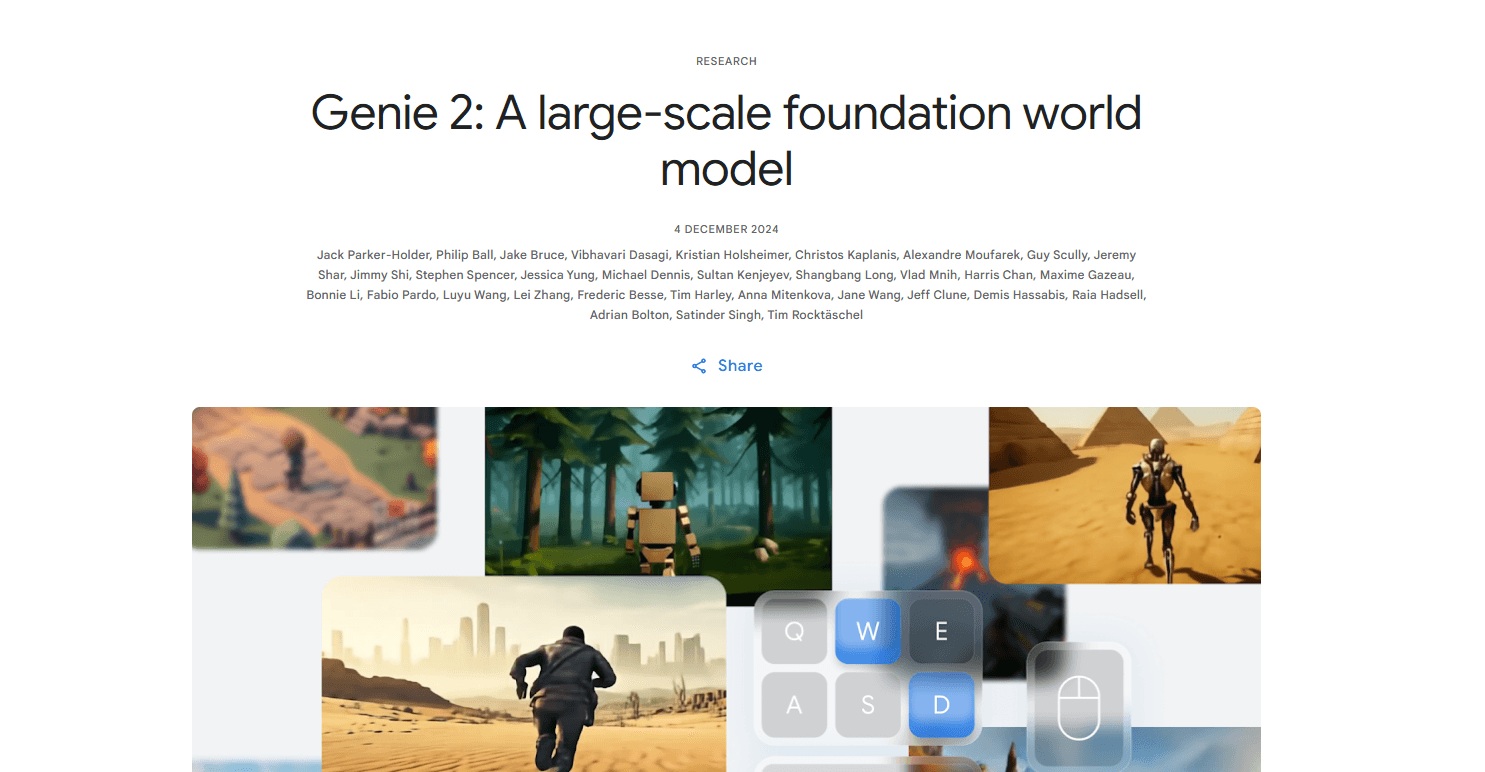
Google Genie 2はGoogle DeepMindの基盤世界モデルであり、環境を記述するだけでなくシミュレートする、新しい種類のAI世界モデルに属する。1枚の画像を渡すと、キーボードとマウスで動き回れる小さな3D世界を組み立てる。モデルは何がキャラクターで何が背景かを判断し、キーを押したときに世界がどう反応すべきかを割り出す。作られた目的はAI研究であり、売れるゲームを作るためではない。
これが解くのは供給の問題だ。汎用エージェントの訓練には何千もの多様な環境が要る。手作業でそうした世界を作るのは遅く、費用もかさむ。Genie 2は代わりに、遊べる3D環境を延々と生成する。一つひとつが操作可能で、役に立つだけの一貫性も持つ。DeepMindはもう一つの用途も見ている。アーティストやデザイナーがコンセプトアートを数分でインタラクティブなものに変え、アイデアを試作できる。売り込みは一行にまとまる。世界を必要なだけ、スタジオなしで。
大きな難点は提供状況にある。Genie 2は研究プレビューであり、公開製品も登録も料金も存在しない。少なくとも今は。世界の一貫性も長くて1分ほどしか持たず、最も印象的なサンプルはリアルタイムで動かせない未蒸留モデルから出ている。自分で座って世界を探索したいと思っていたなら、これは確かな制約だ。次のゲームステージを生成するツールを待っているなら、これはそれではない。
はじめかた
Genie 2は公開製品ではないため、通常の登録手順はない。研究の実際の流れはこうだ。
- まず出発点の画像を生成する。通常はDeepMindのImagen 3のようなテキストto画像モデルを使う。
- その1枚を世界のプロンプトとしてGenie 2に渡す。
- 生成された世界を自分でキーボードとマウスで遊ぶか、SIMAのようなAIエージェントに操作を任せる。
- 世界の反応を観察し、プロンプト画像を調整して繰り返し、別の環境を得る。
- 得られた世界を、身体を持つエージェントの訓練や評価タスクに使う。
AIツール情報
Google Genie 2の料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- AI研究者:Genie 2は身体を持つエージェントの訓練と評価に使える新鮮な3D環境を無制限に提供する。アクセスはDeepMindの研究チャネル経由だ。
- ゲーム・レベルデザイナー:コンセプトアートを素早くインタラクティブな空間に変えられるが、あくまで試作の補助であり、出荷用のツールではない。
- 強化学習エンジニア:1フレームから反事実的な軌跡を生成する。エージェントが異なる選択をどう扱うかを試すのに便利だ。
タスク
- 訓練環境の生成:1枚の画像プロンプトが、エージェントが行動できる操作可能な3D世界になる。
- 汎用エージェントの評価:エージェントが一度も見たことのない世界で試せる。これ以外ではなかなか用意できない。
- インタラクティブなシーンの高速試作:アーティストは描いたコンセプトがどう振る舞うかを、作り込む前に確認できる。
シーン
- エージェントが未知の環境で指示に従えるかの検証:Genie 2をSIMAのようなエージェントと組み合わせ、その挙動を見る。
- 訓練中に「もしも」の分岐を探る:同じ開始フレームを別の行動で再生し、結果を比べる。
- プロジェクト初期に環境案を提示する:静止画のレンダリングではなく遊べる版を見せる。
主な機能
画像から世界を生成
Google Genie 2は1枚の画像から始め、その周りに3D環境を組み立てる。ではその画像はどう用意するのか。テキストto画像モデルからでも、実世界の写真からでもよい。テキストで世界を描写し、気に入ったレンダリングを選び、その中へ入る。この低い入口の敷居こそが要点だ。手作業で世界を作ることはボトルネックであり、このモデルはそれを取り除こうとしている。少数の丁寧に作り込んだ世界ではなく、新鮮で多様な環境の安定供給を必要とする人にとっての話だ。
行動で操作できる遊び
モデルはキーボードとマウスの入力に反応し、プレイヤーが実際に操作しているオブジェクトを見分ける。森のシーンで矢印キーを押せば、動くのはロボットであり、木や雲ではない。些細なことに思える。そうではない。どのピクセルがキャラクターかをモデルは教わっておらず、行動が意味を持つ前に画像だけから推測しなければならない。その推測が、世界をただ眺められるものではなく遊べるものにしている。
長期的な記憶
Genie 2は画面から消えた世界の部分を覚えていて、戻ってきたときに正しく描き直す。家の裏に回る。振り返る。家は同じ細部のままそこにある。これは普通の動画生成器には約束できないことだ。この一貫性が世界モデルと動画生成器を分ける。生成された世界が視点を変えた途端に崩れず、エージェントの試験場として耐えられる理由でもある。
反事実的な軌跡
同じ開始フレームから、別の行動を取れば別の結果が得られる。これにより研究者は訓練に使える反事実的な経験を得る。録画した動画からはなかなか得られないものだ。動画は実際に進んだ道だけを記録する。左に曲がっていたらどうなったかは分からない。その死角こそ反事実が役立つ場所だ。エージェントが取らなかった分岐をどう扱うかを知りたいなら、これをシミュレートする一つの方法になる。
創発する物理とエフェクト
Genie 2は水、煙、重力、照明、反射、ブルームを、一つひとつ明示的に教わらずにモデル化する。風船は割れ、ドアは開き、樽は爆発する。これらの挙動は手でコードを書くのではなく、規模の中で現れる。完璧ではないが、世界を規則のある場所のように感じさせるには十分だ。その規則が、エージェントが見て予測できる障害物の周りをどう計画するかを形づくる。次フレームを当てることだけを訓練されたモデルから出る構造としては、驚くほど多い。
他のエージェントのシミュレーション
モデルはNPCとその相互作用をシミュレートでき、さまざまなアバターのキャラクターアニメーションも扱う。エージェント研究ではこれが重要だ。多くのタスクが、動いて反応する何かとのやり取りを含むからだ。Genie 2はゲームスタジオなしで、そうしたシナリオに居場所を与える。
多様な視点のサポート
世界は一人称、等角投影、三人称の運転視点で描画でき、アバターごとにプロンプトに応じて動きが変わる。紙飛行機、ドラゴン、タカ、パラシュートがそれぞれ独自の動き方を持つ。この幅は分布外汎化から生まれ、1枚のコンセプトアートが動作する遊べるシーンになる。訓練データを写すだけのモデルと、プロンプトが新しい未知の領域へ連れて行っても即興できるモデルの違いがそこにある。
メリットとデメリット
メリット
- 1枚の画像プロンプトから豊かな3D世界を生成し、訓練環境を作る費用を下げる。
- 行動の操作を賢く扱い、動かすべきキャラクターを正しく見分ける。
- 画面を離れて戻る物体も含め、世界を最大1分ほど一貫して保つ。
- 水、重力、反射などの物理とエフェクトを自前でモデル化する。
- SIMAのようなエージェントと組み合わせ、未見の世界で評価タスクを作れる。
デメリット
- 公開リリースも登録も料金もなく、ほとんどの人は使えない。
- 世界の一貫性は1分ほどで頭打ちになり、長時間の訓練を制限する。
- DeepMindのデモで最高品質のサンプルは、可能な上限を見せるために選ばれた未蒸留のベースモデルから出ており、その版はリアルタイムで動かせない。だからブログ記事で見る鮮明な世界は、仮にアクセスできても自分が対話するものとは違う。
- 公開APIがないため、チームはまだ自前のパイプラインに組み込めない。
よくある質問
AIエージェントの訓練と評価に使う、操作可能な3D環境を生成する。研究者は世界を手作業で作る代わりに、モデルへ画像を渡し、遊べる環境を受け取る。遊べるというのがここでのキーワードだ。エージェントが実際に行動し、結果を見られるという意味であり、レンダリングされたクリップが流れるのを眺めるだけではない。だからこれらの世界は、きれいなデモ動画ではなく訓練やテストのタスクとして機能する。
関連コンテンツ
Google Genie 2に関連するツール、スキル、記事を探す。
Google Genie 2の代替ツール

Google EmbeddingGemma 2
Google DeepMind · ライティング · 画像 · コーディングGoogle EmbeddingGemma 2 は 7 億 4000 万パラメータのオープンなモデルで、テキスト、コード、画像、音声、動画フレームを同じ 768 次元空間のベクトルに変え、スマートフォンやノート PC 上で動く。

Tractionwave
TractionWave · 画像 · マーケティングTractionWaveは静止画広告のアテンションヒートマップを作るAIツールだ。PNGかJPGを入れると、予測された注目位置、優先順位付きホットスポット、修正案が返る。予算を投じる前の判断に使う。

Imejis.io
Imejis.io · 画像 · マーケティングImejis.io はエージェントとマーケティングチームのための AI デザインスタジオだ。ふだんの言葉で画像を説明すれば、コピーを書き、レイアウトを組み、全サイズへ自動で組み替え、完成ファイルを書き出す。