
Honcho
Plastic Labs · コーディング
Honchoは、Plastic LabsによるAIメモリ基盤で、状態を持つエージェントにセッションをまたぐ永続的なコンテキストを与える。事実を保存して後で取り出すのではなく、ユーザーの発言すべてを推論して、その人物の変化するモデルを時間をかけて組み立てる。開発者はホスト型APIかセルフホストのスタックから利用でき、Claude Code、Codex、OpenClawといったツールに組み込める。
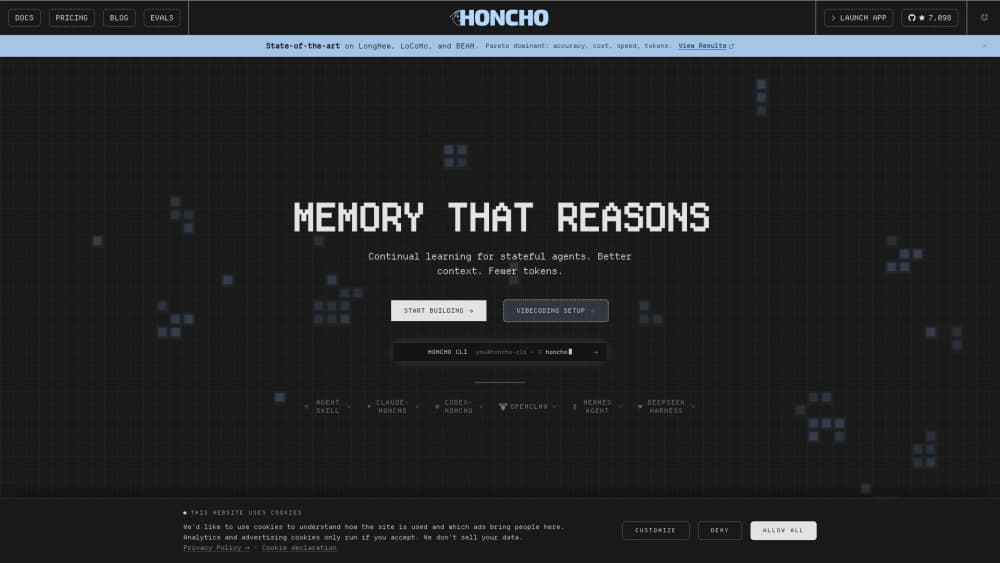
Honcho について
Honchoとは何か
HonchoはAIエージェント向けのメモリとコンテキストの層だ。開発元のPlastic Labsは、マネージドサービスを備えたオープンソースのメモリライブラリと説明する。自分で動かすことも、ホスト版に料金を払うこともできる。訴えは単純だ。ほとんどのエージェントは忘れるか、矛盾するか、セッションの間で話の筋を見失う。Honchoはそれを直すためにある。
中心にある考えは、メモリとは保存ではなく推論だというものだ。単純な事実ストアは、ユーザーがある時サイドプロジェクトに触れたことだけを覚える。Honchoはそのプロジェクトが何か、どれくらい頻繁に話題に上るか、本人にとってどれほど重要そうかを追跡する。入ってくるメッセージごとにこの推論が走る。こうしてシステムは、下流でトークンを節約しつつ、より豊かなコンテキストをエージェントに与えると主張する。
知っておくべき実際の限界もある。Honchoは開発者向けの基盤であって消費者向けアプリではない。使いこなすにはある程度のコーディング力が要る。それに、推論を代行してくれるということは、何が重要かの判断を手放し、その出力を信頼するということだ。あらゆる検索ステップを完全に制御したいチームには、このトレードオフが居心地悪く映るかもしれない。では、これは結局誰のためのものか。
はじめかた
- app.honcho.devでアカウントを作り、ダッシュボードからAPIキーを取得する。
- 自分のスタックに合うSDKを入れる。Pythonなら
pip install honcho-ai、TypeScriptならnpm install @honcho-ai/sdk。 - ワークスペースを設定し、エージェントが追跡するpeer(ユーザーとアシスタントなど)を定義する。
- セッションにメッセージを追加し、Honchoが状態を構築して各peerを推論し始めるようにする。
- 合成されたインサイトを問い合わせ、エージェントのプロンプトに戻してやる。
AIツール情報
Honchoの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- チャットエージェントを作る開発者。Honchoがセッションをまたぐコンテキストを担うので、ユーザーが「忘れる」と訴えるたびに検索パイプラインを組み直さずに済む。
- コンパニオンやコーチング系アプリを出すチーム。人が時間とともにどう変わるかを追う仕組みは、長期的な関係がものを言う製品に合う。
- Claude CodeやCodexを使う個人開発者。プラグインを入れると、端末コマンド数個で永続メモリが加わり、バックエンド作業は不要だ。
タスク
- セッションをまたいだユーザープロフィールの維持。Honchoはメッセージを推論し、各ユーザーが何者かの一貫した像を保つ。
- プロンプトのトークン削減。合成されたコンテキストが、生のチャット履歴を毎回のリクエストに流し込む代わりになる。
- 矛盾とずれへの対処。推論ステップが、衝突する詳細の両方を保存して祈る代わりに、それらを調整する。
シーン
- 以前の会話を思い出す必要がある長時間稼働のアシスタント。ユーザーが数週間後に戻り、エージェントが覚えていることを期待する場面で役立つ。
- 複数のエージェントが同じ実体の状態を共有するマルチエージェント構成。
- 自前開発に踏み切る前に、メモリ層を試作する。
主な機能
推論ベースのメモリ
Honchoは単に保存して取り出すだけではない。メッセージごとに推論を走らせ、重要な点を引き出す。標準的なベクトルストアやRAGパイプラインとの核心的な違いはここにある。この推論があるからこそ、ユーザーの変化する好みを初出時に凍結せず、追い続けられる。大きな違いだ。
4つの保存プリミティブ
システムはワークスペース、peer、セッション、メッセージの上に成り立つ。ワークスペースは別々のアプリや環境を隔離し、peerは持続して変化するあらゆる実体を表し、セッションは会話をまとめ、メッセージは生の入力だ。peerはセッションと多対多でつながるため、一人が多くのスレッドにまたがれる。この構造は意図的に単純にしてある。
ホスト型APIとセルフホスト
マネージドサービスに登録すればインフラ作業を省けるし、CLIを入れてDockerでローカルスタックを動かすこともできる。セルフホストの道は自前のLLMプロバイダーのキーが要るが、データを自分のマシンに置いておける。どちらの道も同じ中核APIを公開する。合うほうを選べばいい。
そのまま使える連携
HonchoはClaude Code、OpenAI Codex、OpenClaw、Hermes Agent向けのプラグインを配る。多くはコマンド1つで入り、会話を静かにメモリへ流し込むフックを登録する。すでにこれらのツールで暮らしている開発者にとって、これが最速の試し方だ。
Neuromancer推論モデル
Plastic Labsは学習ループを動かすために、Neuromancerと呼ぶ自前の推論モデルを作った。同社によれば、これらのモデルはメモリのベンチマークで、フロンティアモデルより低いコストと遅延で最先端の精度に達する。自分の数字を測るまでは、ベンダーの主張として受け止めておくといい。あなたの結果は違うかもしれない。
PythonとTypeScriptのSDK
公式SDKは最も一般的な2つのエージェントスタックを網羅する。クライアントを初期化し、peerを作り、生のHTTPに触れずにメッセージを追加できる。SDKが推奨ルートで、土台のREST APIはどの言語にも開かれている。
メリットとデメリット
メリット
- コンテキストを保存するだけでなく推論するため、時間をかけてユーザーに適応する必要があるエージェントに合う。
- オープンソースでマネージドの選択肢もあるので、セルフホストも、運用を金で省くこともできる。
- 新規アカウントには$100の無料クレジットが付き、クイックスタートの1回は数セントで済む。
- あらゆるモデルやフレームワークで動き、人気のコーディングエージェント向けの既成プラグインを備える。
- 基本的なRAG構成が見落としがちな矛盾や長期パターンを扱える。
デメリット
- 開発者向け基盤なので、コードを書かない人は助けなしでは進みにくい。
- 推論ステップはメッセージごとに遅延とコストを足す。大量処理では効いてくる。
- 無料クレジットを超えた料金は明確に公表されておらず、予算を立てるには推測が要る。
- 判断をシステムに任せることは、何が記憶されるかを細かく制御できないことを意味する。
よくある質問
HonchoはAIエージェントに永続メモリを与える。メッセージを取り込み、それを推論し、各ユーザーや実体についてのコンテキストを生み出す。おかげでエージェントは毎回ゼロから始めるのではなく、セッションをまたいで一貫性を保てる。
関連コンテンツ
Honchoに関連するツール、スキル、記事を探す。
Honchoの代替ツール

Base Code
Base44 (Wix) · コーディング · 生産性向上Base CodeはBase44の共有クラウド開発環境だ。既存のGitHubリポジトリに対する変更をチャットで伝え、プレビューで確認し、プルリクエストとして返せる。

Google EmbeddingGemma 2
Google DeepMind · ライティング · 画像 · コーディングGoogle EmbeddingGemma 2 は 7 億 4000 万パラメータのオープンなモデルで、テキスト、コード、画像、音声、動画フレームを同じ 768 次元空間のベクトルに変え、スマートフォンやノート PC 上で動く。

GitGlow
GitGlow · コーディング · 生産性向上GitGlow は自分のコードと AI エージェントの変更を一つのレビューにまとめるデスクトップ Git クライアントだ。出荷前に、マシンから何が出ていくのかを確かめられる。