
Inferless
Inferless · コーディング
Inferlessは機械学習モデルをAPIエンドポイントとして配備するサーバーレスGPUプラットフォームである。コールドスタートは1秒未満、課金は秒単位。
Inferless について
About
Inferlessとは
Inferlessは、学習済みの機械学習モデルを、GPUを自分で管理せずに動くモデルエンドポイントへ変えるGPU推論プラットフォームだ。機械学習モデルの配備を持ち込めば、あとは配備、スケーリング、その下のインフラをプラットフォームが引き受ける。狙いはML推論であり、学習ではない。クラスタ構築を飛ばして、アプリから呼べるエンドポイントを手に入れる、というのが売りだ。
標的にしているのはコストと手間である。モデルを動かすには、誰もリクエストを送っていない時間まで含めてGPUを借り続けるのが普通だった。Inferlessは秒単位で課金し、トラフィックが止まればゼロまで落とす。だから実際に使った計算資源にだけ金を払う。自前のオーケストレーションエンジンとストレージ層でコールドスタートを抑えており、モデルが答える前に起き上がる必要がある場面ではここが効く。
制約も現実的だ。これは開発者向けの道具であってノーコードのアプリではない。モデルと依存パッケージは自分で正しく固める必要がある。料金は従量制で、少量なら安いが、固定費より見通しは立てにくい。長時間の学習のように、推論向けのサーバーレスより専用GPUマシンのほうが向く用途もある。
はじめ方
- Inferlessのアカウントを作り、Hugging Face、GitHub、Dockerイメージなどのモデル供給元をつなぐ
- 実行環境、パッケージ、GPUの種類を簡単なYAMLファイルで設定する。サーバーコードは書かなくてよい
- モデルを配備し、環境の構築とエンドポイントの起動はInferlessに任せる
- 生成されたエンドポイントをアプリから呼び、トラフィックの山はオートスケーリングに任せる
AIツール情報
Inferlessの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- 機械学習エンジニア:学習済みモデルをエンドポイントとして公開したいが、GPUサーバーは持ちたくない人
- スタートアップ:推論を素早く動かしたいが、遊んでいるGPUに金を払えない小さなチーム
- データサイエンティスト:インフラの専門家にならずにモデルを本番で試したい研究者
- アプリ開発者:Webアプリやモバイルアプリからモデルを呼ぶAPIが要る人
- 企業のチーム:自社モデルに規模、監視、セキュリティ管理を揃えたい会社
タスク
- 自前モデルの配備:PyTorch、TensorFlow、ONNXのモデスを呼び出せるエンドポイントに変える
- 言語モデルの提供:APIの背後でオープンソースLLMをオートスケーリング付きで動かす
- バッチ推論ジョブ:予測の波をまとめて処理し、使った計算資源だけ払う
- アイデアの検証:有料化の前に無料クレジットでエンドポイントを試す
- アプリへの推論組み込み:エンドポイントを自前のバックエンドやフロントエンドにつなぐ
- モデル間のデータ共有:NFS的なボリュームを使い、複数の処理が同じファイルに届くようにする
シーン
- AI機能を出すスタートアップ:モデルファイルからエンドポイントまで、数週間でなく数分
- モデルを検証するデータサイエンティスト:エンドポイントを立て、テスト要求を送り、終わったら落とす
- トラフィックが読めないチーム:キャンペーンで要求が跳ねたら、ゼロから数百GPUへ広げる
- デモを組む開発者:サーバーを管理せず、フロントエンドからエンドポイントを呼ぶ
- 自前モデルを動かす企業:SOC-2の管理と監視を保ちながら、需要に合わせて広げる
主な機能
1秒未満のコールドスタート
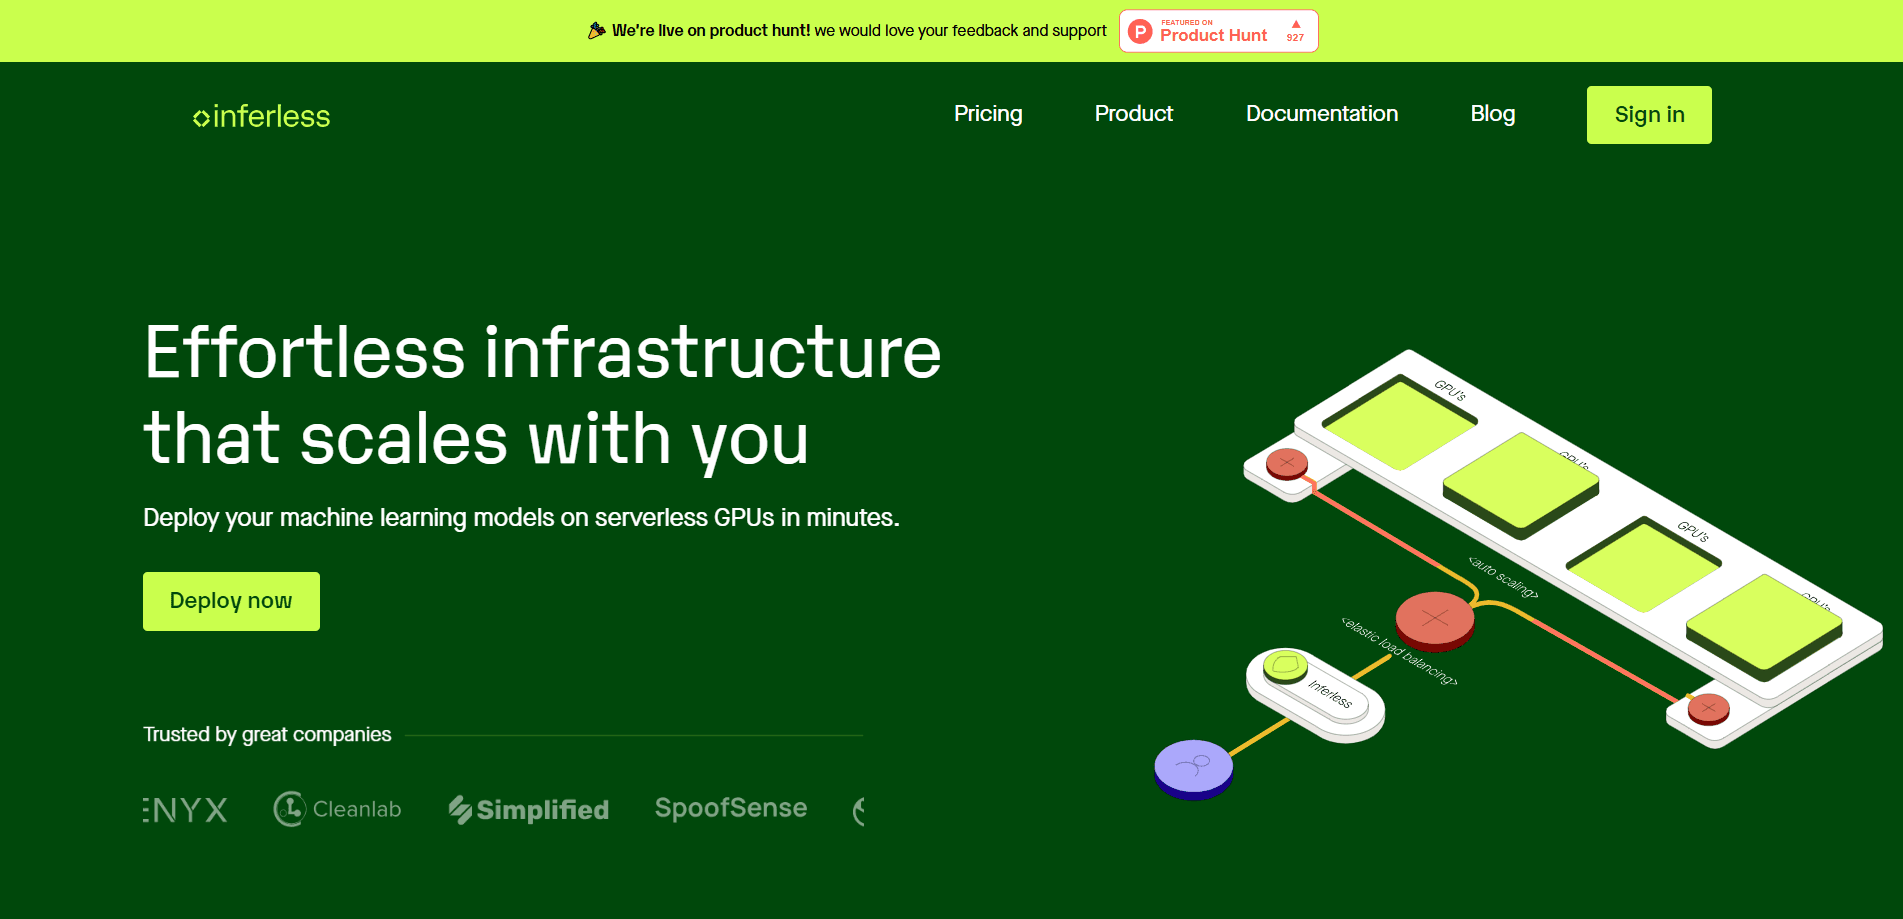
サーバーレス推論で最も難しいのは、眠っていたモデルが応答のために起き上がるまでの待ち時間、いわゆるコールドスタートだ。Inferlessは自前のオーケストレーションエンジン、高性能なルーター、独自のストレージ層を連携させてここに挑む。大規模モデルでも1秒未満で応答できると会社は説明しており、ゼロまで落とす仕組みがユーザー向けアプリでも現実的になる。チャットや検索がモデルの読み込みに10秒待たされるなら、サーバーレスの価値は消える。
ゼロからの自動スケーリング
Inferlessはトラフィックに合わせてエンドポイントを上下させる。動いているGPUがゼロの状態から、同時に数百台まで広がる。自社製ロードバランサーが要求を振り分け、わずかな負荷で能力を足し引きする。予測しづらく跳ねる負荷に向く。ピーク容量を前もって用意する必要も、静かなときにその分を払う必要もない。
複数ソースからのモデル取り込み
モデルはHugging Face、GitHub、AWS S3、Google Cloud Storage、Docker、Inferless CLIから取り込め、残りはプラットフォームがこなす。MLチームが普段使うリポジトリからワンクリックで取り込めるため、準備の手間が減り、モデルの本番投入がファイル転送から始まらない。Azure対応は近日とされている。
モデルとフレームワークに依存しない
PyTorch、TensorFlow、ONNXのモデルを動かし、独自のPython関数も受け付ける。この柔軟さのおかげで、特定のフレームワークやモデル形式に縛られない。実行環境とパッケージはYAMLで調整するので、追加のライブラリを入れるのにサーバーを一から書く必要はない。
GPUの分割利用
小さなモデルにGPUを丸ごと借りる代わりに、複数のモデルや処理で同じGPUを共有できる。自動での再配分とノードの切り離しも付く。分割されたGPUも使えるため、A100の一部だけ要るモデルでカード全体を払わずに済む。小さなモデルを多く動かすチームでは、この共有が現実的か高すぎるかの分かれ目になることが多い。
監視とCI/CD
InferlessにはPrometheusのメトリクスとGrafanaのダッシュボードが付き、GPU使用量などの健全性を追える。新しいモデル版はCI/CDのパイプラインで配備するので、インフラを手で作り直さずに更新を出せる。同じ流れからすぐ使えるAPIエンドポイントが出て、バックエンドにもフロントエンドにも差し込める。
メリットとデメリット
メリット
- 秒単位の課金で、トラフィックがゼロになっても遊んでいるGPUに払わずに済む
- 1秒未満のコールドスタートで、ゼロまで落とす仕組みが生きたアプリでも成り立つ
- Hugging Face、GitHub、S3、Google Cloud Storageからワンクリックで取り込め、準備が軽い
- フレームワークに依存せず、PyTorch、TensorFlow、ONNX、独自Pythonが動く
- GPUの分割共有で、小さなモデルを多く動かす費用を抑えられる
デメリット
- 開発者向けの道具なので、モデルと依存パッケージは自分で固める必要がある
- 従量制は少量なら安いが、固定費より見通しを立てにくい
- 長時間の学習は対象外で、プラットフォームは推論向けに作られている
- ネイティブのモバイルアプリはなく、すべてWebコンソールとCLI経由になる
よくある質問
Inferlessはモデル配備のためのサーバーレスGPUプラットフォームで、自前の機械学習モデルをAPIエンドポイントに変える。モデルを取り込み、実行環境を設定すれば、ハードウェア、スケーリング、コールドスタートの調整はInferlessが引き受ける。
関連コンテンツ
Inferlessに関連するツール、スキル、記事を探す。
Inferlessの代替ツール
Forefront
Forefront · コーディングForefrontはオープンソースAIで構築するためのウェブプラットフォームだ。主要なオープンソース言語モデルを自分のデータで微調整し、性能を評価し、API経由で実行したり、エクスポートして自分でホストしたりできる。クローズドなプラットフォームの手軽さを求めつつ、モデルとデータの所有権にはこだわる開発者が対象だ。

Startkit
StartKit.AI · コーディングStartkitは、AI SaaSとAIラッパー製品を作るためのボイラープレートだ。面倒な部分をあらかじめ配線済みにしたAIスタートアップボイラープレートと考えればいい。認証、StripeとLemon Squeezyの決済、利用制限、トランザクションメール、そしてOpenAI、Anthropic、Groq、Llamaと通信するAI APIスターターキットが含まれる。リポジトリをクローンして価格を設定し、ユーザーが実際にお金を払う部分に取りかかれる。ReactとTailwind上のNext.jsで作られているため、ボイラープレートコードの多くはすでに見慣れたものだ。
Testim
Tricentis · コーディングTestimは、Web・モバイル・Salesforceアプリ向けにエンドツーエンドテストを構築して実行するAIテスト自動化プラットフォームだ。機械学習を頼りに、インターフェースが変わってもテストを安定させ、チームが壊れたセレクターの修正に費やす時間を減らす。今日から使い始められる自動テストツールとしては悪くない。ブラウザで操作を録画してテストを作り、より細かい制御が必要なときはJavaScriptを足す。忙しいQAチームにとって堅実な選択肢である。