
Kyutai TTS
Kyutai · 音声・言語
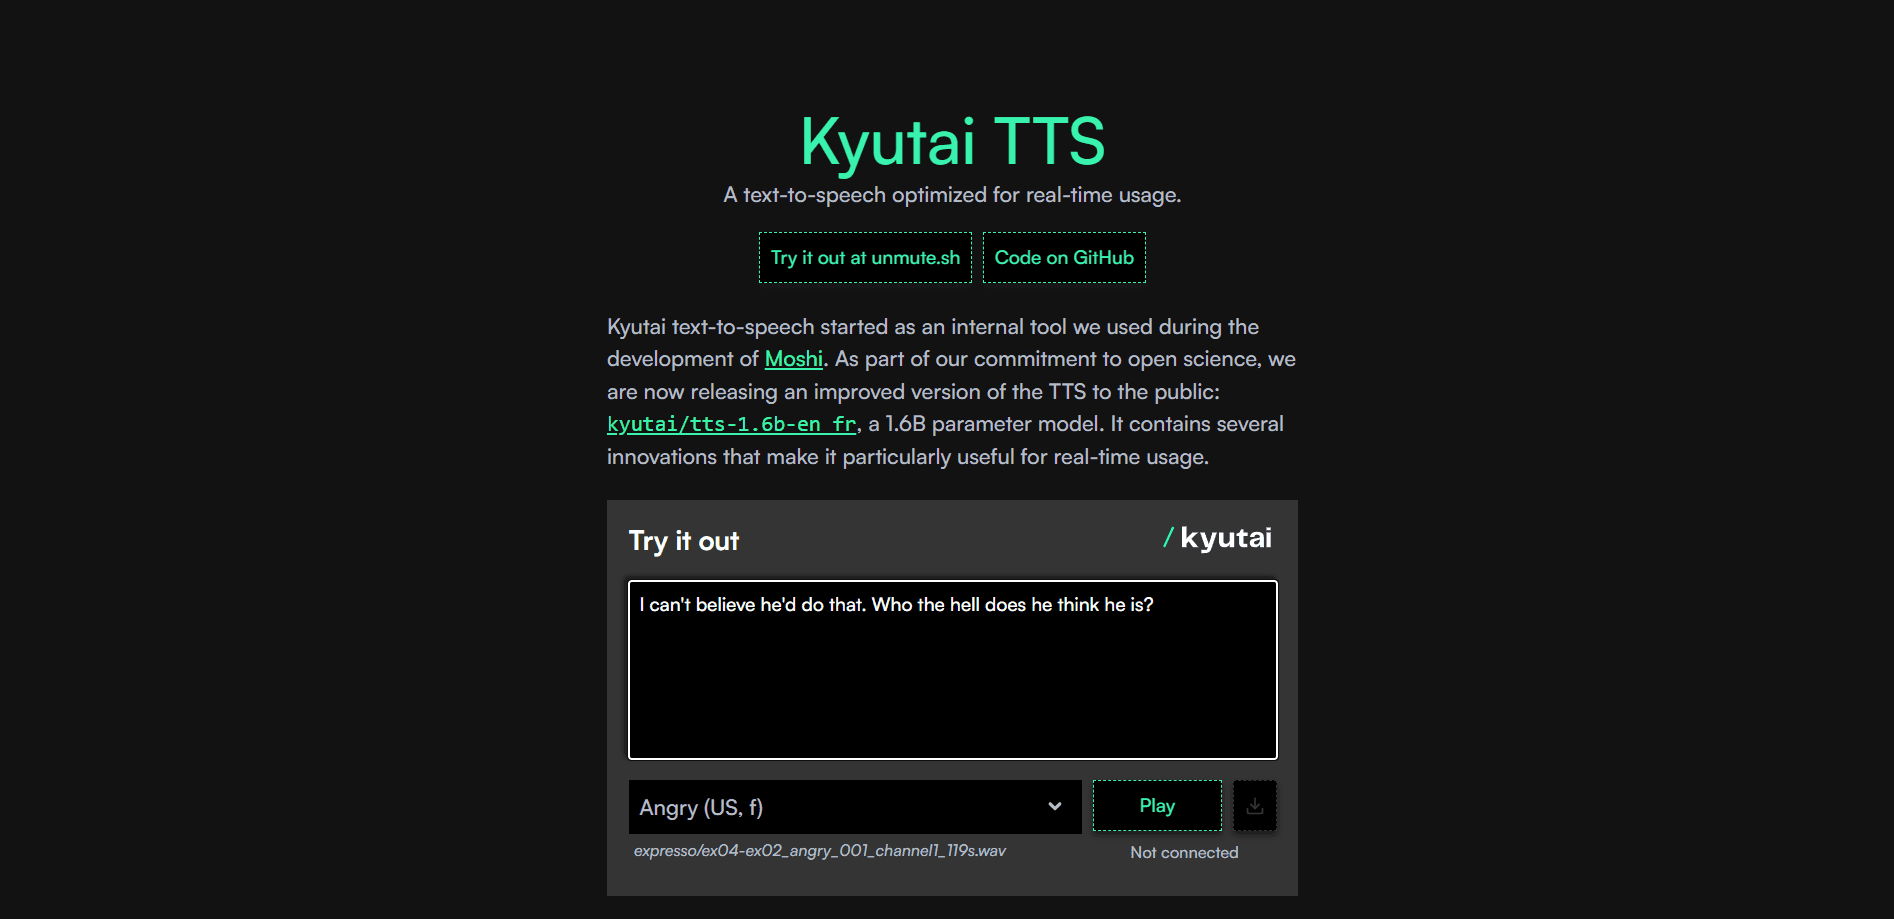
Kyutai TTSは、全文がそろう前に音声を作り始めるオープンソースTTSモデルだ。ストリーミング音声合成に対応するモデルで、音声アシスタントやリアルタイムアプリの遅延を低く抑える。
Kyutai TTS について
About
Kyutai TTSとは
Kyutai TTSはストリーミング向けに作られた音声合成モデルである。テキストを読み上げるが、入力が終わるのを待たない。最初の数語を受け取った時点で話し始める。この点が、一文まるごとを必要とするオフラインのエンジンとの違いだ。
Kyutaiはフランスのオープンサイエンス研究機関で、Iliadグループ、CMA CMグループ、Schmidt Sciencesが出資している。同機関は音声対話システムMoshiの開発のためにKyutai TTS 1.6Bを作り、のちに重みを公開した。Kyutaiの音声モデルは複数あるうちの一つである。この版は低遅延の音声合成を狙う。多くのエンジンは全文を読んでからでないと音を出せない。話すアシスタントを作る、ナレーションを生成する、文字数に応じた課金なしでアプリに音声を足す、といった使い方ができる。
肝心なのは、その速さをどう実現しているかだ。250万時間の公開音声でトレーニングされ、GPUで最もよく動く。月額が明示された即時利用型のクラウドサービスではない。重みをダウンロードし、環境を整えて自分で動かす。版は二つある。ここで扱う1.6Bのストリーミングモデルと、より新しいPocket TTSだ。後者はCPUマシン向けの小型モデルである。
はじめ方
- Hugging Faceの無料アカウントを作り、Kyutai TTSのページでモデルのライセンスに同意する。
- pipでPythonパッケージmoshiを入れる。本番で提供するならcrateのmoshi-serverを入れる。
- PythonでチェックポイントとMimi音声コーデックを読み込み、モデルにテキストのプロンプトを渡す。
- ストリーミング再生用にチャンク単位で音声を生成する。ファイルに対して実行すればオフライン出力になる。
- tts-voicesリポジトリから既製の声を選ぶか、自分の声埋め込みを用意する。
AIツール情報
Kyutai TTSの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- 音声アシスタントを作る開発者
- 研究者と学生
- 予算の限られた個人開発者
タスク
- リアルタイムの音声応答
- 固定キャラクターの声の複製
- ナレーションの一括生成
シーン
- 対話型の音声エージェントを動かす
- アプリにアクセシビリティを足す
- 多言語製品を試作する
主な機能
オフラインTTSを上回るストリーミング出力
Kyutai TTSはプロンプトの冒頭数語を受け取るとすぐ話し始める。オフラインのエンジンは全文を待つため、数秒の遅れが積み上がる。音声アシスタントでは、この差が自然なやり取りと気まずい沈黙を分ける。
delayed streams modelingが土台
このモデルは、Kyutaiのdelayed streams modelingの研究から生まれた。テキストと音声を行き来するストリーミング処理の手法である。Moshiと同じマルチストリーム構成を使い、テキストと音声の流れがそろう。生成は安定して速い。
埋め込みによる声の複製
tts-voicesリポジトリの計算済み埋め込みを渡せば、特定の声を与えられる。Kyutaiが自由な複製ではなくこの道を選んだのには理由がある。公開モデルでは電子透かしを外しやすいと分かったからだ。複製を保存済みの埋め込みに限るほうが安全だと判断した。
高スループットのための一括処理
このモデルは声を一つずつ扱わず、リクエストをまとめて処理する。Kyutaiは計算資源あたり約75倍の音声を生成すると報告する。CFG蒸留でトレーニングしたため、誘導時にバッチを倍にしなくて済む。
英語とフランス語の音声
1.6Bモデルは英語とフランス語を標準でカバーする。商用エンジンに比べれば範囲は狭い。だが二言語の製品には十分で、セルフホストできる大きさに収まる。
複数の導入方法
動かし方は三通りある。PyTorch版は研究と実験向け、Rustサーバーはwebsocketで本番の負荷を処理し、量子化版は一般向けのマシンで動く。
メリットとデメリット
メリット
- 寛容なライセンスで重みを無料公開しており、文字数課金がない。
- ストリーミング設計により、ライブの会話に耐える低遅延を保つ。
- 1枚のGPUでまとめて処理でき、同時に多くの利用者をさばくコストを下げる。
- 公開論文、Colabノートブック、声のリポジトリがそろい、ゼロから始めなくてよい。
デメリット
- ホスト型APIがないため、サーバーは自分で立てて保守する必要がある。
- GPUを推奨するため、リアルタイム負荷で安価なホスティングは選べない。
- 対応は英語とフランス語のみで、他の言語には別のモデルが要る。
- 声の複製は計算済み埋め込みに限られ、自由な模倣はできない。
よくある質問
無料だ。モデルの重みはCC-BY 4.0で公開されており、ダウンロードして実行できる。費用は動かす機材の分だけかかる。
関連コンテンツ
Kyutai TTSに関連するツール、スキル、記事を探す。
Kyutai TTSの代替ツール

Prosp
Prosp · ライティング · 音声・言語 · マーケティングProspは、代理店や営業チーム向けに作られたAI LinkedInアプローチツールだ。見込み客ごとに自分の声でメッセージとボイスメッセージを書き、相手が本当に返信するように仕向ける。アカウントをつなぎ、リードを見つけ、AIにパーソナライズされたメッセージを大量に下書きさせて送信させる。すべて1つの受信トレイから行える。大量のアウトバウンドを回す人向けにできている。それがこの製品の売り込みのすべてだ。それでも各接点は人間らしく感じられなければならない。

Wordly AI Translation
Wordly · 音声・言語 · 生産性向上Wordly AI Translationは、会議・カンファレンス・イベント向けに作られたリアルタイムAI翻訳・字幕プラットフォームだ。60以上の言語でライブ翻訳、字幕、文字起こし、要約を提供し、参加者は専用ヘッドセットを使わず、QRコードを読み取るかリンクを開くだけで参加できる。Zoom、Microsoft Teams、Google Meet、Webexと連携し、セッションごとに人間の通訳を雇わずに多言語対応したい組織に向く。それだけのことだ。
Musicful
Musicful AI · 音声・言語 · 動画Musicfulは、テキストを数分で音楽に変えるAI音楽ジェネレーター兼AIミュージックビデオ作成ツール。テキストの指示、歌詞、あるいは口ずさんだメロディーを渡すと、ボーカルと楽器が入った完成したトラックを返す。AI楽曲ジェネレーターとしても機能し、自分が作った曲からミュージックビデオを生成し、AIカバーツールと開発者向けAPIも備える。ウェブブラウザとAndroidアプリで動くので、パソコンで曲を始めてスマホで続きを進められる。