
LFM2
Liquid AI · その他
LFM2は、端末上での実行を狙ってLiquid AIが作ったオンデバイスAIモデルの一群であり、小型言語モデルとして端末内で動く。350M、700M、1.2Bの各チェックポイントは、普通のCPUでも素早く動く。
LFM2 について
What Is LFM2
LFM2は、Liquid AIが2025年7月に公開した第2世代の基盤モデルだ。同社はMITのCSAIL研究所から生まれた企業で、規模を速度とメモリ効率に振り替えるモデルを作っている。LFM2は350M、700M、1.2Bパラメータの3つの密なチェックポイントをそろえる。どれも小型で、データセンターを後ろに置かずにスマートフォン、ノートPC、車載システムで動く。
狙いは単純だ。クラウドのモデルは強力だが、大規模に動かすと遅くて高くつき、しかもデータを端末の外へ送る。LFM2は役立つAIを端末内に残そうとする。応答は数ミリ秒で返り、何も機械の外に出ない。Liquid AIによれば、これらのモデルはCPU上でのデコードとプリフィルがQwen3の2倍速く、学習パイプラインは初代LFMより3倍効率がいい。
弱点は、小さいモデルは知識が少ないことだ。Liquid AIはデータ抽出、RAG、マルチターン対話のような狭いタスク向けにLFM2を微調整するよう勧め、深い推論や複雑なコーディングのような知識頼みの作業には向かないと注意する。LFM2は速くて私的な部品であって、何でも知っているアシスタントではない。
Getting Started
- Hugging Faceで自分のハードウェアに合うチェックポイントを選ぶ。小型端末向けの350Mから、ノートPCや単体GPU向けの1.2Bまで幅がある
- 重みをダウンロードする。さらに軽くしたいなら、llama.cpp向けのGGUFのような量子化形式を使う
- llama.cpp、ExecuTorch、標準のTransformersツール群など、対応するフレームワークでローカルに動かす
- 汎用のチェックポイントでタスクをこなせないときは、TRLなどのフレームワークで手持ちのデータを使って微調整し、調整後のモデルを端末に配備する
AIツール情報
LFM2の料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- オンデバイス機能を作るアプリ開発者:アプリの中に小さなモデルを置きたいエンジニア。クラウドの請求もネットワークの往復も要らない
- プライバシー制約のあるチーム:医療、金融、防衛の分野で、利用者のデータを第三者のサーバーに送れない人たち
- ホビイストと工作好き:ノートPCやRaspberry Piで言語モデルを動かし、仕組みの組み合わせを学びたい人
- 売上1,000万ドル未満のスタートアップ:微調整できるベースモデルに無料の商用ライセンスを求める小さな会社
タスク
- エージェント的なワークフロー:ツール呼び出しや短い計画のステップを担う素早いローカル頭脳をエージェントに与える
- データ抽出:文書、フォーム、メッセージから端末上で構造化フィールドを取り出す
- 検索拡張生成:自前の私的な文書ストアに短い回答の根拠を置く
- マルチターン対話:手頃なハードウェアで、きびきび答えるアシスタントを動かす
- 創作の補助:クラウドを呼ばずに、短い文章をローカルで下書きし直す
シーン
- スマホアプリがオフラインで応答する必要がある:電波がなくてもLFM2がアシスタントを動かし続ける
- ノートPCの利用者がローカルで下書きしたい:1.2BのチェックポイントをCPUで動かし、下書きを機械の中に置く
- 機器メーカーが低予算でAIを載せたい:メモリの厳しいウェアラブルや家電に350Mモデルを組み込む
- 規制のあるチームがデータを社内に留める:外部APIではなく私有サーバーで記録を処理する
- 開発者が車載システムでエージェントを試作する:オンデバイスのモデルが携帯回線なしでも素早く答える
主な機能
畳み込みとアテンションのハイブリッド構成
LFM2はアテンションだけに頼らず、短い畳み込みとグループ化クエリアテンションを組み合わせる。各モデルは16ブロックを積む。二重ゲートの短距離畳み込みブロックが10、グループ化クエリアテンションが6だ。局所的なパターンを安く捉え、アテンションは効果のある場面だけに使う。この設計が、スマホやノートPCに実際に載るハードウェアで遅延とメモリを低く抑える。
一般CPUでの速度
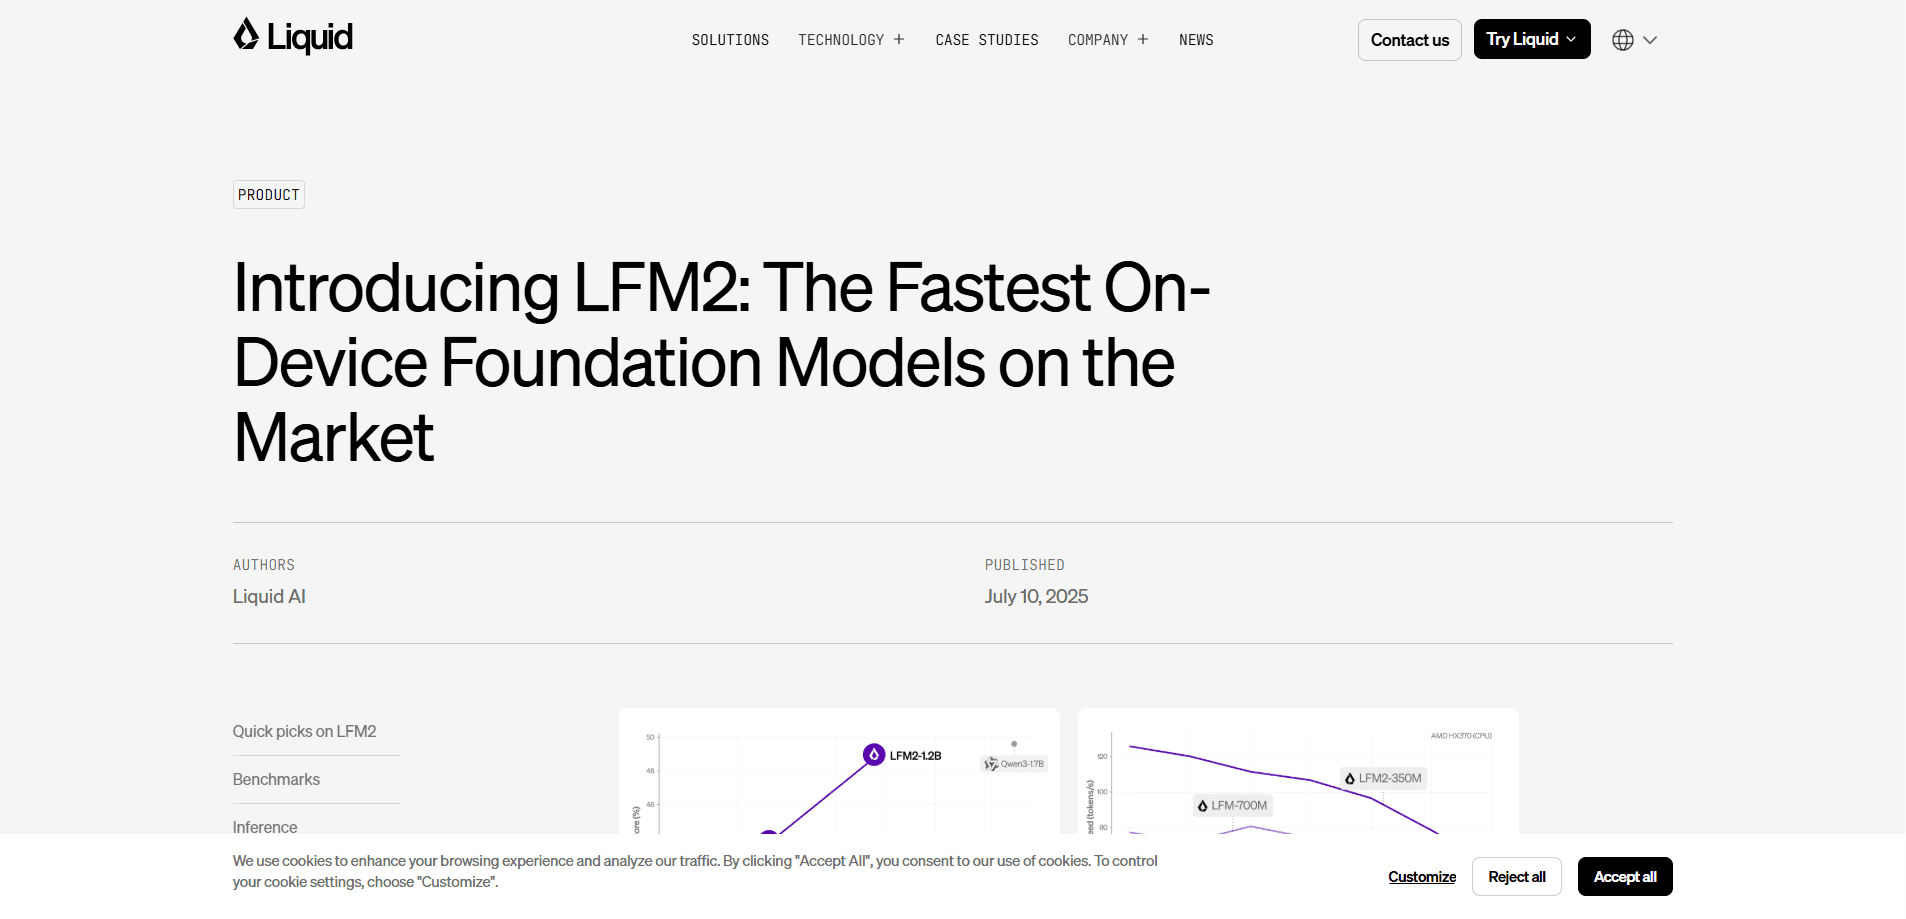
売り物は生の精度ではなく処理量だ。Liquid AIによれば、LFM2はCPU上でのデコードとプリフィルがQwen3の2倍速く、小型の700Mはより多くのパラメータを持ちながらllama.cppでもExecuTorchでもQwen 0.6Bより速い。この差は、頼れるチップがCPUしかないスマホや薄型ノートPCで効いてくる。
用途別の4サイズ
このファミリーはパラメータ350M、700M、1.2B、2.6Bをそろえ、端末にモデルを合わせられる。350Mはウェアラブルや厳しい組み込み先に入り、1.2BはノートPCや単体GPUで動き、はるかに大きなモデルと渡り合う。端末向けの言語モデル群として、1つの構成で複数サイズをまかなうため、機能を上位にも下位にも書き直さずに移せる。
小さい規模での競争力あるLFM2ベンチマーク
Liquid AIによれば、LFM2-1.2Bは47%も多いパラメータを持つQwen3-1.7Bと互角にわたり、そのスコアは何倍も大きなモデルに迫る。700MはGemma 3 1B ITを上回り、350MはQwen3-0.6BやLlama 3.2 1B Instructと互角に戦う。同社のマルチターン試験では、評価者がLlama 3.2 1B InstructやGemma 3 1B ITより1.2Bのモデルを好んだ。
オープンウェイトと柔軟なライセンス
Liquid AIはApache 2.0を土台にしたオープンライセンスで、重みをHugging Faceに公開する。学術・研究用途は無料で、売上1,000万ドル未満の企業は無償で商用利用できる。その線を超えると商用ライセンスのためにLiquid AIへ連絡する。小さなチームには条件が簡潔なままで、大企業との契約の余地も残る。
幅広いツールチェーンの対応
LFM2は開発者がすでに使うフレームワークへ書き出せる。ローカル推論はllama.cpp、モバイルはExecuTorch経由のPyTorch、学習は標準のTransformersツール群で動く。TRLでの微調整も対応する道で、GGUF版を使えば既存の推論アプリに手軽に組み込める。
32Kコンテキストと多言語学習
各チェックポイントは32,768トークンのコンテキスト窓を扱う。長い文書や長い対話に足りる大きさだ。学習には10兆トークンを使い、およそ英語75%、多言語20%、コード5%で構成し、日本語、アラビア語、韓国語、スペイン語、フランス語、ドイツ語に重点を足した。複数の言語を扱うアプリにLFM2は無理なく収まる。
メリットとデメリット
メリット
- スマホ、ノートPC、車にもともとあるCPUで速く動くので、GPUもクラウドサービスも要らない
- 小型のチェックポイントはメモリの占有を抑え、ウェアラブルや厳しい組み込み先に向く
- Qwen3-1.7BやGemma 3 1B ITといった大きなモデルに、はるかに小さい規模で並ぶか上回る
- 開放された重みと、売上1,000万ドル未満なら無料の商用ライセンスで、序盤の費用を抑えられる
- llama.cpp、ExecuTorch、TRLといった見慣れたツールで動くので、導入に書き直しは要らない
デメリット
- 小型モデルは世界知識が少なく、深い推論や複雑なコーディングのような知識頼みの作業は守備範囲の外にある
- Liquid AIは狭い用途向けの微調整を勧めており、最良の結果を得る前に設定の手間がかかる
- 企業の売上が1,000万ドルを超えると商用ライセンスに有償契約が必要になり、規模拡大にコストがかかる
- 新しいLFM2.5のチェックポイントや大きなLFM2の派生版がすでにあり、当初の3サイズは最新の選択肢ではなくなった
よくある質問
LFM2はオンデバイスAI向けに作られ、小型モデルがクラウドではなく端末内で動く。代表的な用途はエージェント的なワークフロー、データ抽出、検索拡張生成、マルチターン対話、創作の補助だ。Liquid AIは汎用の推論よりも、狭く定義のはっきりしたタスクへ開発者を導く。
関連コンテンツ
LFM2に関連するツール、スキル、記事を探す。
LFM2の代替ツール

Odyssey 3
Odyssey · その他Odyssey-3はOdysseyの基盤ワールドモデルだ。物理をリアルタイムにシミュレーションし、プロンプトからインタラクティブな環境を生成して、ロボットや車、ゲームに適応する。

JarvisCore
Prescott Data · コーディング · 生産性向上 · その他JarvisCore は、AI エージェントが対等なピアとしてメッシュを組み、共有台帳からタスクを引き受け、ゼロトラストのブローカー経由で外部サービスを呼ぶオープンソースの Python ランタイムである。
Clef
Cloudflare · ビジネス · その他Clef は Workers AI で動く Cloudflare のオープンソース意思決定モデルだ。生成テキストではなく、型付きの設問に確率を返す。エージェントは素早く分類し、振り分け、行動できる。