
LLM-Citeops
Rakesh Cheekatimala · コーディング · マーケティング
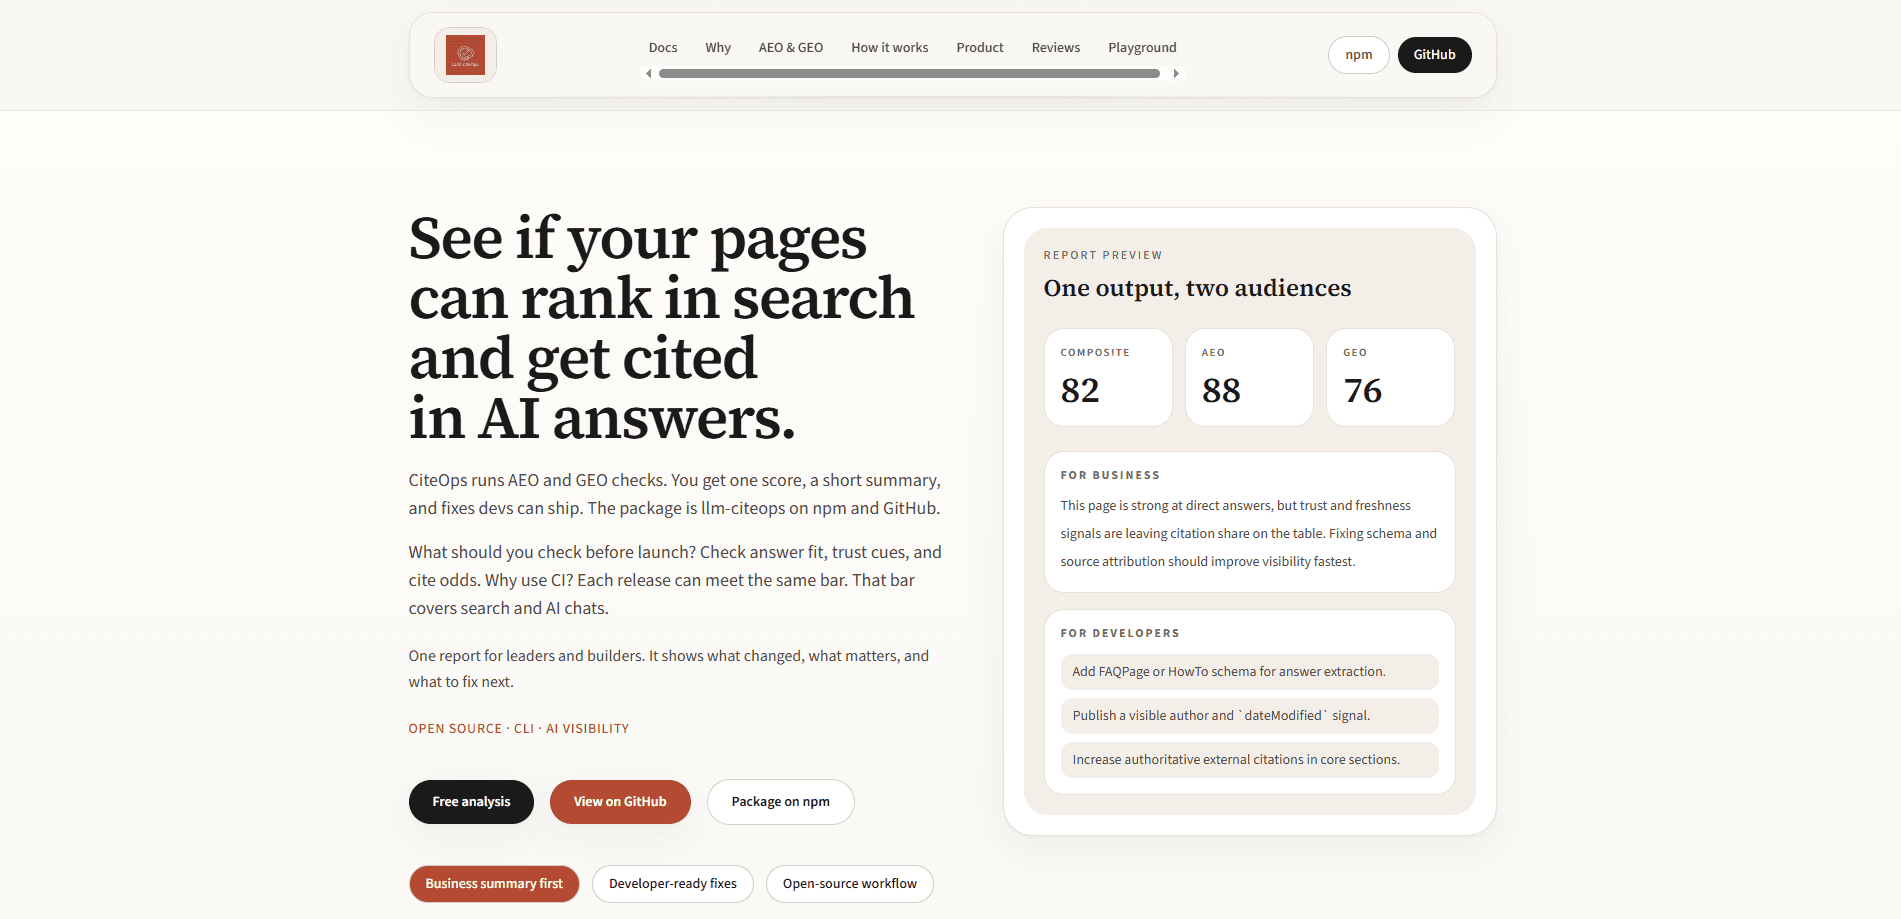
LLM-CiteOpsは、WebページをAEOとGEOで監査する無料のオープンソースコマンドラインツールだ。この2つは、AIシステムがコンテンツを理解し、信頼し、引用できるかを決める分野である。npm経由でローカルで動作し、各ページを総合スコアと個別のAEO・GEOサブスコアで採点し、ページを足踏みさせている具体的なシグナルを指し示す。コンテンツチームはこれを使い、「AI検索への準備はできているか」という漠然とした不安を、公開前に毎回実行できる再現可能なAI引用準備チェックリストへと変える。
LLM-Citeops について
LLM-CiteOpsとは
LLM-CiteOps(npmでは answerlint として公開)は、コンテンツチーム向けのローカルで決定論的な回答準備コーチだ。URL、Markdownファイル、フォルダ、あるいはサイトマップを読み取り、そのページが明快に答えているか、十分な信頼シグナルを備えているか、モデルが引用するのに必要な構造を公開しているかを確認する。採点の背後にLLMは存在しないため、同じページは毎回同じスコアになる。
このツールは2つの新しい考え方の交差点に位置する。AEO(回答エンジン最適化)は、スニペットや音声結果のように短い回答を引き出すエンジンを対象とする。GEO(生成エンジン最適化)は、一度に多くのページを読み、どの情報源を信頼するかを選ぶAIを対象とする。LLM-CiteOpsは両方を1回の実行で測定するため、単一の見栄えの数字ではなく、組み合わせたリスク像が見えてくる。
最大の難点はこの分野そのものにある。AEOとGEOの採点はまだ若く、「良い」スコアが何を意味するかを定める標準はない。またLLM-CiteOpsは公式サイトでAnswerLintという名前でも配布されているため、初めて探す人はブランド名で混乱しやすい。
はじめかた
- Node.js 18以降をインストールし、ターミナルで
npx answerlint@latest audit --url https://your-site.comを実行する。何もアップロードされない。 - 確認したい対象にツールを向ける。単一URL、ローカルのMarkdownまたはHTMLファイル、フォルダ、サイトマップ全体を受け付ける。
- 出力を読む。各ページには総合スコアと個別のAEO・GEOスコアが付き、失敗したチェックはすべて不足しているシグナルを名指しする。
- 指摘された項目を自分で直し、監査を再実行して修正前後のスコアを比較する。
.answerlint.json設定とCIしきい値を追加し、ページが基準を下回ったときにマージをブロックする。
AIツール情報
LLM-Citeopsの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- コンテンツチーム
- SEOスペシャリスト
- 開発者
タスク
- 公開前のランディングページを監査する
- 競合とベンチマークする
- サイトマップを一括チェックする
シーン
- pull requestにAI可視性ゲートを組み込む
- ライターの下書きを伴走する
- AI活用が進む購買サイクルに備える
主な機能
1回で終わるAEO・GEO採点
ほとんどのツールはどちらか一方に偏る。LLM-CiteOpsはAEOとGEOを並べて採点し、それを1つの総合値にまとめる。これは重要だ。ページが上位表示されてもAIの回答を取れないことはある。2つのスコアを一緒に見れば、問題が明快さか、信頼か、モデルが読むための構造の組み方かを判断できる。
決定論的でローカルなチェック
採点は言語モデルではなくルールで動く。同じ入力なら同じスコア、毎回だ。チェックはすべて手元のマシンで行われ、ドキュメントは約束を小さく保つ。読み取り専用の取得、設定可能なレート制限、robotsへの配慮。クライアントのページをチャット欄に貼れるだろうか。多くのチームは貼れない。彼らにとっては、そこが要点なのだ。
すべてのスコアの裏にある根拠
理由のないスコアはただのノイズだ。失敗したチェックはそれぞれ、不足しているシグナルを名指しし、影響を受ける内容を示し、なぜ重要かを説明し、変更案を出す。役に立つのはそこだ。ライターには平易な指針が届く。開発者にはコミットできるスキーマ、マークアップ、メタデータの修正が届く。
CIのリリースゲート
CLIは合格、スコア失敗、ネットワークエラー、不正入力の終了コードを返すので、リンターのようにパイプラインへ収まる。しきい値を設定し、デプロイURLに対して監査を実行すれば、低いGEOスコアがマージをブロックする。同じ検査はローカルでもプレビューでもCIでも動かせる。
2つの読者に向けたレポート
LLM-CiteOpsはHTML、JSON、CSVを書き出す。HTMLはビジネス側の読者に、商業リスクを前面に置いた読みやすい要約を渡す。JSONはパイプラインと差分比較に流し込む。CSVは、多数のURLをまとめて見たいサイトマップやフォルダの実行に向く。
競合比較
公開中のURLを競合のURLと突き合わせ、スコア差、同等性のギャップ、距離を縮める最初の修正が見える。これで孤独なスコアがベンチマークに変わり、74が十分なのか、競合が静かに引用をさらっているのかが分かる。
llms.txtジェネレーター
付属の無料ツールは、公開サイトをllms.txtファイルに変える。一部のチームがrobots.txtと並べて公開し始めたAI可読のロードマップだ。ダウンロード前に出力を確認できるので、生成物を闇雲に公開することはない。
メリットとデメリット
メリット
- MITライセンスの無料オープンソースで、核心の採点を有料階層で制限しない。監査全体が無料だ。
- 決定論的なスコアにより、推測せずにリリース間の進歩を追える。
- LLM呼び出しなしの完全ローカルで動くため、非公開ページや顧客ページが第三者サーバーに渡らない。
- npm、終了コード、CIしきい値を通じて、開発者の既存の習慣に収まる。
- AEOとGEOを分けるので、明快さの問題と信頼の問題を見分けられる。
デメリット
- 採点ルールはまだ若く、低スコアは証明された順位ペナルティではなく、調べるべき方向を示すにすぎない。
- 問題を診断するが、コンテンツを書き直してはくれない。つまり指摘に基づいて動く人が依然として必要だ。
- npmパッケージは `answerlint` という名前なのに、公式サイトはAnswerLintのブランドを使うため、LLM-CiteOpsを検索すると誤ったページへ誘導されうる。
- 公式APIがないため、一括自動化は自分でCLIをスクリプト化する必要がある。
よくある質問
AI引用準備度を測る。1回の実行で総合スコアと個別のAEO・GEOスコアを返し、明快さ、構造、信頼シグナル、日付、引用への適合をカバーする。平たく言えば、そのページがAIの回答で引用され、検索で信頼されるかを確認するのだ。
関連コンテンツ
LLM-Citeopsに関連するツール、スキル、記事を探す。
LLM-Citeopsの代替ツール
Forefront
Forefront · コーディングForefrontはオープンソースAIで構築するためのウェブプラットフォームだ。主要なオープンソース言語モデルを自分のデータで微調整し、性能を評価し、API経由で実行したり、エクスポートして自分でホストしたりできる。クローズドなプラットフォームの手軽さを求めつつ、モデルとデータの所有権にはこだわる開発者が対象だ。

Startkit
StartKit.AI · コーディングStartkitは、AI SaaSとAIラッパー製品を作るためのボイラープレートだ。面倒な部分をあらかじめ配線済みにしたAIスタートアップボイラープレートと考えればいい。認証、StripeとLemon Squeezyの決済、利用制限、トランザクションメール、そしてOpenAI、Anthropic、Groq、Llamaと通信するAI APIスターターキットが含まれる。リポジトリをクローンして価格を設定し、ユーザーが実際にお金を払う部分に取りかかれる。ReactとTailwind上のNext.jsで作られているため、ボイラープレートコードの多くはすでに見慣れたものだ。
Testim
Tricentis · コーディングTestimは、Web・モバイル・Salesforceアプリ向けにエンドツーエンドテストを構築して実行するAIテスト自動化プラットフォームだ。機械学習を頼りに、インターフェースが変わってもテストを安定させ、チームが壊れたセレクターの修正に費やす時間を減らす。今日から使い始められる自動テストツールとしては悪くない。ブラウザで操作を録画してテストを作り、より細かい制御が必要なときはJavaScriptを足す。忙しいQAチームにとって堅実な選択肢である。