
Magma
Microsoft Research · その他
MagmaはマイクロソフトのマルチモーダルAIエージェント向け基盤モデルだ。画像、動画、テキストを読み取り、ボタンのクリックやロボットアームの動作といった行動を、デジタルと物理の両世界で提案する。
Magma について
What Is Magma
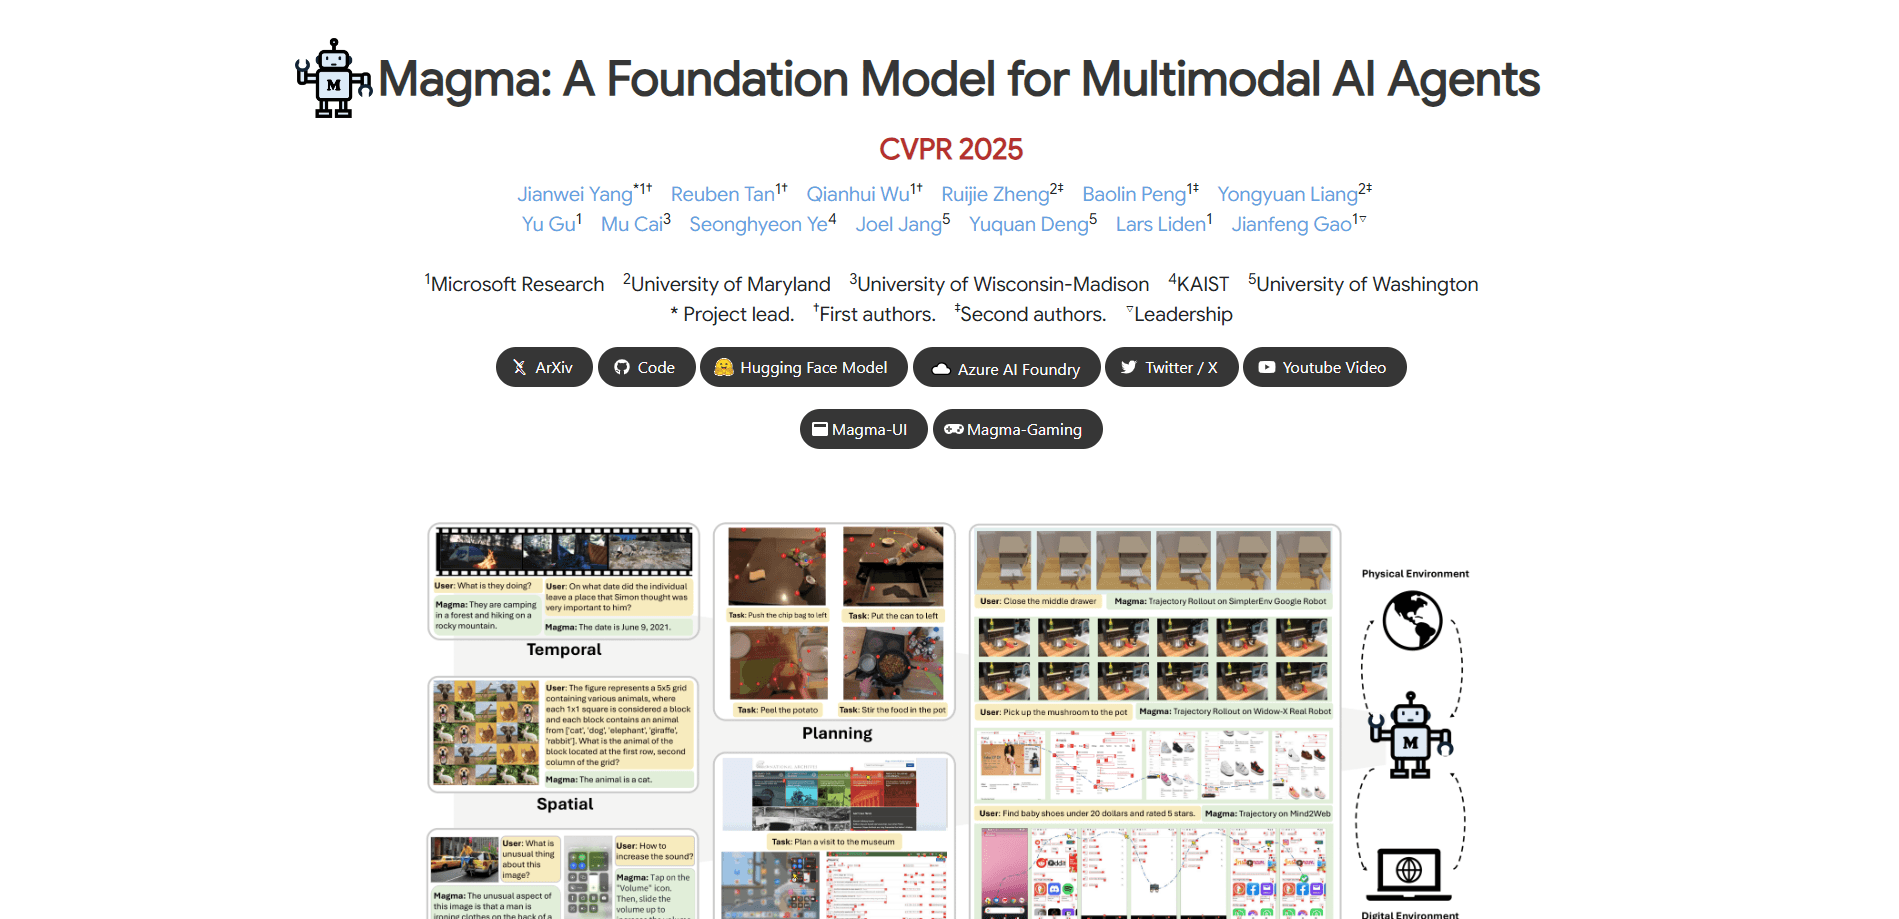
Magmaは、マイクロソフトリサーチがマルチモーダルAIエージェント向けに構築した基盤モデルだ。見たものを説明するだけの一般的な視覚言語モデルと違い、Magmaは理解と行動を結びつける。画像、動画、テキストを受け取り、目標に向けた手順を提案する。スマホアプリのボタンを押すところから、ロボットアームに物をつかませるところまで幅広い。この研究はCVPR 2025に採択され、マイクロソフトはコードとモデルの重みを公開した。
根底にあるのは、二つの世界を一つのモデルで扱うという考え方だ。これまでの多くは単一の用途に合わせて訓練され、2Dインターフェースか3Dロボットのどちらかに偏り、切り替えが苦手だった。Magmaは画像、動画、ロボットデータを混ぜて事前学習し、一つのモデルでUIナビゲーション、ロボット操作、そして一般的な画像や動画の質問をこなす。マイクロソフトはこれを、マルチモーダルAIエージェント向けの初の基盤モデルだと位置づける。
最大の制約は、Magmaが研究用モデルであり、完成した製品ではない点だ。公開された重みとコードを自分で動かす形になり、試すにはそれなりのGPUが要る。自ら微調整できる開発者や研究者向けであり、完成したアプリを求める人向けではない。
Getting Started
- PyTorchを入れたPython環境を整え、GitHubからMagmaのリポジトリを取得する。
- Hugging FaceからMagma-8Bの重みをダウンロードする。
- モデルとプロセッサを読み込み、コードを自分のGPUに向ける。
- 画像か動画にテキストを添えて入力し、回答や提案された行動を得る。
- UIナビゲーションやロボット制御といった特定の用途に向けて、自分のデータで微調整する。
AIツール情報
Magmaの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- AI研究者:視覚・言語・行動モデルを研究し、再現できる土台を求める人に向く。動かすには16GB前後のメモリを持つGPUが要る。
- アプリとロボットの開発者:画面をクリックするエージェントやハードウェアを操作するエージェントを作り、自分でモデルを微調整できる人に役立つ。
- マルチモーダルAIを学ぶ学生:コードと重みが公開されているので試す価値がある。アプリを触るのではなく、コードを読む前提で臨みたい。
タスク
- UIナビゲーション:画面をMagmaに向けると、どこを押すべきかを提案する。自動化やテストの流れに向く。
- ロボット操作:物をつかんで置く作業で腕の動きを計画できるよう、実験室やシミュレーションで微調整する。
- 画像と動画への質問:写真やクリップについて尋ねると答えが返る。空間把握や次の一手の推論も含む。
- 空間推論:物がどこにあり、場面の中でどう関係するかといった問いに使える。
シーン
- エージェントモデルの研究:公開コードで結果を再現し、その上に開発を積む。
- インターフェース自動化の試作:視覚エージェントが一連の流れを扱えるか、製品化の前に確かめる。
- 領域をまたぐ転移の探求:同じモデルが画面から物理的な作業へどう移るかを調べる。
主な機能
デジタルと物理を一つのモデルで
MagmaはUIナビゲーションとロボット操作を同じ重みの組で扱う。以前のモデルは一つの環境に合わせて調整されることが多く、画面のエージェントはロボットを動かせなかった。マイクロソフトは混ぜたデータでMagmaを訓練し、アプリのクリックと物理的な行動の計画を切り替えられるようにした。
Set-of-Markで行動を土台づける
Set-of-Markは、画面上のボタンやロボットアームのグリッパーなど、操作できる対象に番号を振る。モデルはどの印に働きかけるかを予測し、あいまいな視覚理解を具体的な次の一手に変える。
Trace-of-Markで計画を立てる
Trace-of-Markは、手やロボットアームの軌跡のように、物体が動画のフレーム間でどう動くかに印を付ける。この軌跡から学ぶことで、Magmaはフレーム単位で反応するのではなく、複数段の行動を計画し、次に起きることを見越す。
混ぜたデータでの事前学習
Magmaは、画像、動画、ロボットデータを幅広く組み合わせて事前学習した。この混在により、一つのモデルがエージェント機能と並んで一般的な画像・動画理解を保てる。どちらかを犠牲にしない。自由に使える動画を活かし、空間と時間のパターンを学ぶ。
動画と画像の理解
行動だけでなく、Magmaは写真やクリップへの質問にも答える。動画の質疑応答や空間推論も含む。マイクロソフトによれば、動画の指示データが少ないにもかかわらず、複数のベンチマークでより大きな視覚言語モデルと競う。
公開されたコードと重み
マイクロソフトは重みをHugging Faceに、訓練と推論のコードをGitHubに、Magma-8BをAzure AI Foundryに公開する。この開放性により研究者は結果を再現して微調整できる。ただし導入と運用は自分の手に残る。
メリットとデメリット
メリット
- 一つのモデルがUIナビゲーション、ロボット制御、一般的な画像・動画理解をカバーする。
- 重みとコードが公開され、研究者は結果を再現し自由に微調整できる。
- Set-of-MarkとTrace-of-Markが、視覚の読み取りを具体的な行動計画に変える。
- UIナビゲーションとロボット操作で最先端の結果を出したと報告されている。
デメリット
- 研究用モデルであり、完成したアプリはなく、導入には実際の手間がかかる。
- 動かすには高性能なGPUが必要で、気軽な利用者には敷居が高い。
- 成果は用途ごとの微調整に左右され、そのまま使える範囲は限られる。
- データや評価の一部はマイクロソフト自身によるもので、独立した検証が欠かせない。
よくある質問
MagmaはマルチモーダルAIエージェント向けの基盤モデルで、視覚言語行動モデルの一種だ。開発者はこれを使い、画面を読んでクリックを提案するエージェントや、ロボットの動きを計画するエージェントを、一般的な画像・動画理解と合わせて作る。研究用コードなので、自分の用途に合わせて微調整する。
関連コンテンツ
Magmaに関連するツール、スキル、記事を探す。
Magmaの代替ツール

Odyssey 3
Odyssey · その他Odyssey-3はOdysseyの基盤ワールドモデルだ。物理をリアルタイムにシミュレーションし、プロンプトからインタラクティブな環境を生成して、ロボットや車、ゲームに適応する。

JarvisCore
Prescott Data · コーディング · 生産性向上 · その他JarvisCore は、AI エージェントが対等なピアとしてメッシュを組み、共有台帳からタスクを引き受け、ゼロトラストのブローカー経由で外部サービスを呼ぶオープンソースの Python ランタイムである。
Clef
Cloudflare · ビジネス · その他Clef は Workers AI で動く Cloudflare のオープンソース意思決定モデルだ。生成テキストではなく、型付きの設問に確率を返す。エージェントは素早く分類し、振り分け、行動できる。