
Microsoft-Decision-1
Microsoft · 生産性向上 · ビジネス
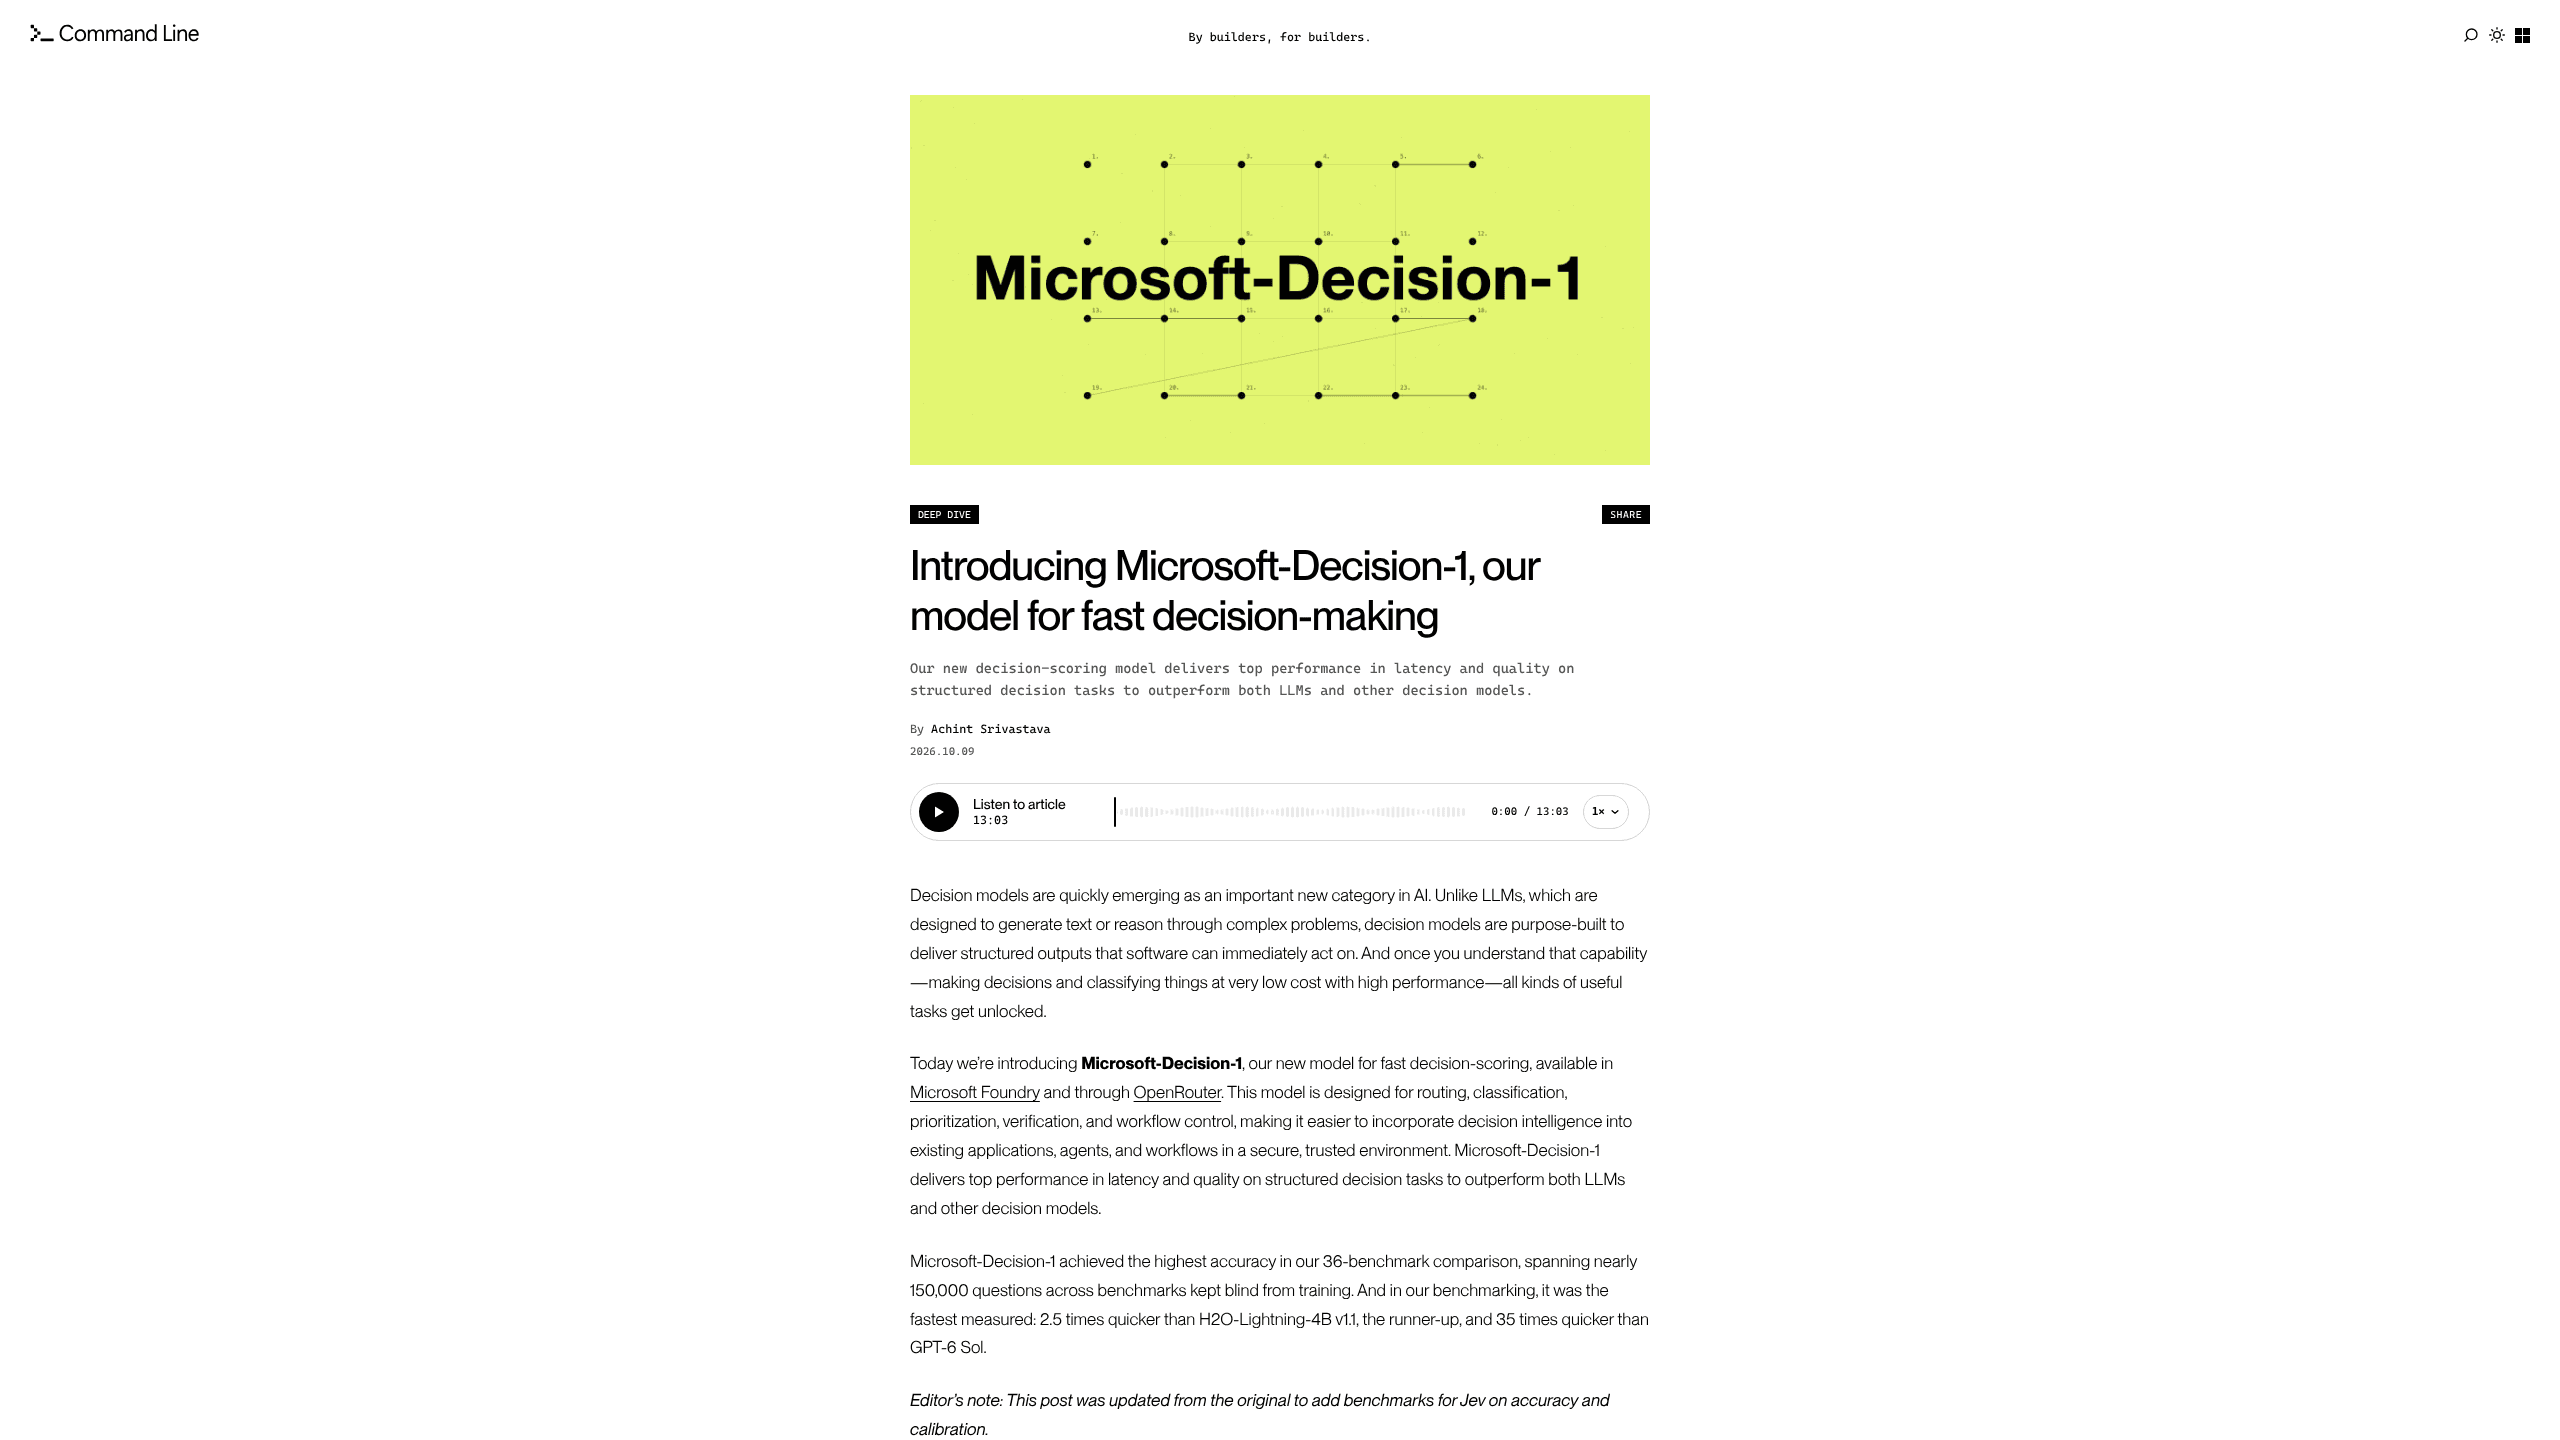
Microsoft-Decision-1はMicrosoft Foundryで提供される意思決定モデルだ。固定した選択肢ごとに校正済みの確率を返し、文章は生成しない。
Microsoft-Decision-1 について
About
Microsoft-Decision-1とは
Microsoft-Decision-1は構造化された判断のためのAI意思決定モデルだ。状況と、選択肢を限定した質問を送る。返ってくるのは選択肢ごとの数値で、ソフトウェアは文章を読み解かずにその数値で動ける。
提供先はMicrosoft FoundryとOpenRouterだ。MicrosoftはAlibabaのオープンモデルQwen3.5-9Bを土台にし、1回の推論で採点できるよう追加学習させた。最先端の対話モデルに比べれば小さく、実行コストも低い。
置き換えるのは、エージェントの一日を埋める地味な判断だ。このチケットはどのチームへ回すのか。この返信は返金を約束しているのか。この障害はどれくらい深刻なのか。こうした呼び出しは通常、大規模言語モデルに送られ、誰も読まない説明を1秒かけて書く。意思決定モデルはその説明を省く。
限界は守備範囲にある。Microsoft-Decision-1は自分で定義した選択肢の中からしか選ばない。方針文を書かせたり、誰も問いの形にしていない証拠を比べさせたりしても、採点する対象がない。理由も返さないため、外したときの原因調査は対話モデルより手間がかかる。
使い始めるには
- Foundryポータルを開き、プロジェクトに入り、モデルカタログでMicrosoft-Decision-1を探す。
- Deployを選び、デプロイの種類を決める。DataZoneStandardは推論を1つのデータゾーン内に保つ。GlobalStandardは対応する全リージョンの容量を使う。
- エンドポイント、デプロイ名、APIキーを控える。Microsoft Entra IDで接続してもよい。
state(プレーンテキストまたはJSON)と、型を指定した質問を1つ以上添えてリクエストを送る。noulははい・いいえ、choiceは固定リストから1つのラベル、scoreは順序付きの尺度に案件を置く。answersオブジェクトを読み、自前のしきい値を適用する。確率は判断と一緒に記録しておけば、後から監査できる。
AIツール情報
Microsoft-Decision-1の料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- プラットフォーム/バックエンドエンジニア
- エージェント開発者
- データ/サポート運用チーム
- AI品質の責任者
タスク
- チケットの振り分け
- モデルのルーティング
- 回答の採点
- 安全の関門
シーン
- エージェントが毎ターン、短いメニューから次の行動を選ぶ。4つの選択肢の採点は対話の補完の何分の1かの費用で済み、1回の処理で返る。
- サポートチームに、読み切れないほどのチケットが届く。モデルが分類と緊急度を付け、確信度の低い案件だけが人に回る。
- 研究のパイプラインが候補実験をふるいにかける。それぞれが固定の基準で採点され、キューの先頭だけが次へ進む。
主な機能
文章ではなく校正済みの確率
どの回答にも0から1の確率が付く。Microsoftはこれをランキングの目安ではなくAPIの一部として扱う。代表的な事例では、90%の予測は10回に9回ほど当たる。アプリ側はしきい値を決め、それを超えたら動き、残りは人間に渡せる。
判断に応じた3つの質問型
noulははい・いいえの問いに1つの確率で答える。choiceは固定リストから1つのラベルを選び、全選択肢のスコアを返す。scoreは案件を順序付きの尺度に置き、各段階の確率加重平均を返す。1回のリクエストに複数の質問を入れ、同じ処理でまとめて採点できる。
最大32Kトークンを1回で処理
入力は最大32,768トークンまで扱え、1回の呼び出しで構造化JSONを返す。長い指示、チケットのやり取り、ソースコードの一部が収まる。往復がないので、判断1回のコストは会話ではなくリクエスト1本分だ。
言い換えても判断がぶれない
本番の入力は言い換えられ、順序を変えられ、整形し直される。Microsoftは同じリクエストを8通りに変え、判断が反転する割合を測った。平均は1.3%で、選択肢の説明を言い換えた場合と、選択肢の順序を逆にした場合は反転がゼロだった。
入力100万トークン$0.042の低遅延
Microsoftの発表では、P50の遅延はGPT-6 Solより約35倍速く、比較で2位のH2O-Lightning-4B v1.1より2.5倍速い。入力は100万トークンあたり$0.042、出力は無料だ。この価格なら、忙しいキューの全メッセージを採点するといった使い方も現実になる。
AIエージェントの評価と制御のために
MicrosoftはこのモデルをAIエージェント評価向けに位置づける。提案された行動をルーブリックで採点し、回答が示された証拠に支えられているかを確かめ、続行・再試行・停止を決める。明示的な棄権にも対応するため、証拠が足りなければ「判断できない」を選べる。
メリットとデメリット
メリット
- 出力は選択肢ごとの確率を持つ型付きJSONで、解析層も出力バリデータも要らない。
- 入力100万トークン$0.042という価格で、大量のAI分類が現実的になる。キューの全メッセージを採点しても成り立つ。
- 遅延が低く、1つのタスクで何度も回るループの中に置ける。
- 利用者が自分の言葉で書き直しても、回答が安定している。
- 安全テストは11のベンチマーク、5,250件のリクエストを対象にし、ジェイルブレイクやプロンプトインジェクションも含む。
デメリット
- 説明を返さないため、判断を外したときに残るのは数値だけで、原因を追いにくい。
- 質問には固定の選択肢が必要で、開かれた判断は守備範囲の外になる。
- モデルはプレビュー段階で、本番向けのSLAはなく、APIも変わりうる。
- 無料枠がない。デプロイには支払い方法を登録したAzureサブスクリプションが要る。
よくある質問
ソフトウェア内部の構造化された判断を扱う。依頼の分類、チケットの適切なチームへの転送、キューの並べ替え、AI回答の採点、エージェントの次の一手の選択などだ。呼び出しごとに、指定した全選択肢の確率が返る。
関連コンテンツ
Microsoft-Decision-1に関連するツール、スキル、記事を探す。
Microsoft-Decision-1の代替ツール

Base Code
Base44 (Wix) · コーディング · 生産性向上Base CodeはBase44の共有クラウド開発環境だ。既存のGitHubリポジトリに対する変更をチャットで伝え、プレビューで確認し、プルリクエストとして返せる。

Knocket
Knocket (Tencent RTC team) · 生産性向上 · ビジネス · チャットボットKnocketは無料のライブチャット兼コンタクトページだ。訪問者はウェブサイト、アプリ、共有リンクから書き込み、こちらはTelegramか一つの受信トレイから返信する。

FloorGen
Vinit Kumar (FloorGen) · 生産性向上 · 中国のAIFloorGenはブラウザで動く間取り作成ツールだ。文章かスケッチから編集できる2D間取り図と3Dウォークスルーを作る。PDF、DXF、動画に書き出せ、アカウントなしでも描き始められる。