

OnDemand
OnDemand AI · マーケティング · 学習 · その他 · チャットボット
OnDemand は RAG を中核にした AI プラットフォームだ。自社データにつないだ AIエージェントを組み、API で公開できる。モデルカタログと自社モデル持ち込みの両方に対応する。
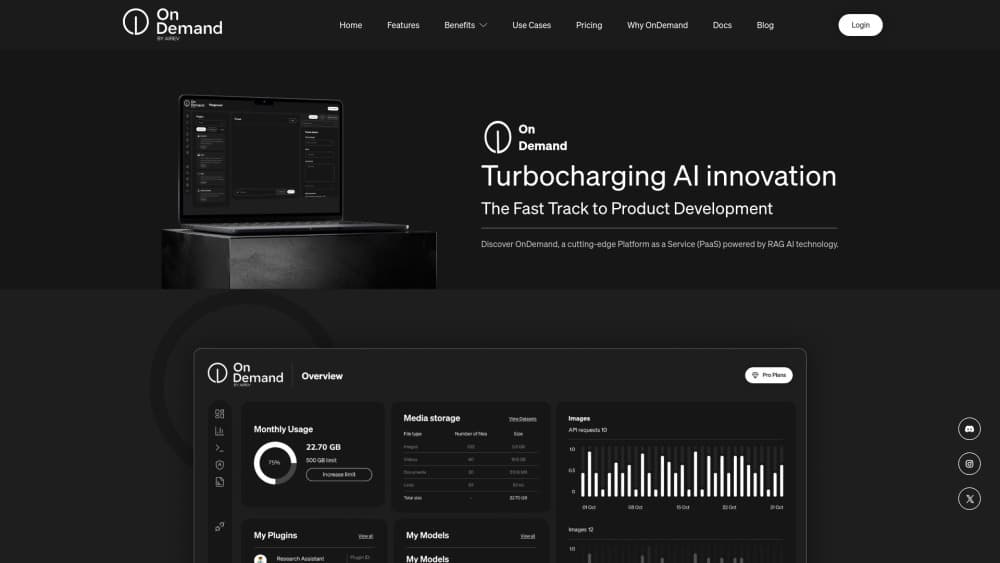
OnDemand について
About
OnDemand とは
OnDemand AI は、既存システムの中に AIエージェントを差し込むための AI PaaS だ。自社の文書やサービスをプラットフォームにつなぎ、モデルを選び、エージェント、チャット用エンドポイント、ワークフローのいずれかとして公開する。
RAGプラットフォームとして見るのが実態に近い。中心にあるのは検索拡張生成であり、後付けの機能ではない。ツールのほとんどは社内データから答えを出し、外部システムで処理を動かすために存在する。だからプロンプトの書き方より、検索の組み立て方が結果を左右する。
向き不向きははっきりしている。API と構造化データを扱える人向けの製品だ。一般消費者向けアプリはなく、有料利用は案件ごとの見積もりで、公開価格表はない。
はじめかた
- app.on-demand.io でアカウントを作り、Playground を開く。コードを書かずにモデルを試せる。
- 管理画面で API キーを発行し、https://api.on-demand.io/ に最初のリクエストを送る。
- 文書をアップロードするかデータソースをつなぎ、ナレッジエージェントを組む。回答はその内容から出る。
- ツール、REST エージェント、フローを足し、アプリから呼ぶエンドポイントとして公開する。
AIツール情報
OnDemandの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- バックエンドやフルスタックの開発者
- 中規模企業の AI エンジニア
- 資料がすでに手元にあるプロダクトチーム
タスク
- ヘルプ記事と過去の問い合わせ履歴を使ったサポート支援。回答は参照元の文書に根拠を置く。
- 社内の REST サービスをエージェント化し、チャットの依頼から注文状況の確認やチケット起票までこなす。
- 同じ社内データセットで複数モデルの挙動を比べてから採用先を決める。同じエージェントの背後でモデルを差し替えられる。
シーン
- 数週間で動く AI を見せる必要がある実証案件
- 文書を未知のエンドポイントへ送れない規制業種のチーム
- 受付、分類、振り分けのような多段のバックオフィス業務
主な機能
モデルカタログと Playground
テキスト、画像、データ向けのホスト型モデルを用意し、Playground で回答を比べてから決められる。同じプロンプトを複数モデルに投げ、予算と遅延に合うものを残す。作り込む前に課題が解けるか確かめる最短の道だ。
BYOI と BYOM
Bring Your Own Inference は、すでに動かしている推論エンドポイントを OnDemand に向ける。Bring Your Own Model はさらに進み、Hugging Face のモデルを vLLM と専用ベアメタル GPU で動かし、非公開の重みは自前のトークンで扱う。調整済みモデルを本番に残したまま、データを移さずホスティング代も二重に払わずに済む。
エージェントとコネクタ
エージェントはモデルをチャットの外へ連れ出す。REST エージェントは OpenAPI スキーマを呼び出せる操作に変え、ナレッジエージェントは索引済み文書から答える。コネクタは OAuth で外部サービスをつなぐ。MQTT の IoT エージェントとターミナルエージェントは機器とサーバーを扱う。ハードウェアに触る業務では効いてくる。
エージェントフロービルダー
ビルダーはモデル、エージェント、ロジックを再現可能なパイプラインに束ねる。ノードが分岐、データ変換、ツール呼び出しを受け持つので、多段の処理はスクリプトの列ではなく一本のフローとして走る。公開したフローには専用エンドポイントと実行履歴が付き、失敗の追跡が楽になる。
RAG のベクトル検索とファイル処理
アップロードしたファイルは解析され、チャンクに分けられ、管理されたベクトルデータベースに収まる。回答はその断片に基づく。検索設定ではチャンクの大きさと取得件数を調整できる。大きな文書も扱えるため、200 ページの PDF でも取り込みが止まらない。
API、Webhook、サーバーレスアプリ
会話、エージェント、フロー、実行のすべてに API がある。共通のベース URL の下で、標準のキーとレート制限を使う。Webhook は実行終了時に結果を自社システムへ返す。サーバーレスアプリは小さな関数をエージェントの隣に置く。運用するサービスの数が減る。
メリットとデメリット
メリット
- 検索、エージェント、フロー、API アクセスが一か所にまとまる。RAG 機能ひとつに四社も要らない。
- 専用 GPU 上の BYOM は、プライバシー要件の厳しいチームにとって現実的な選択肢だ。宣伝文句ではない。
- Playground があればモデル比較は数日から半日で済む。
- 公開済みフローは実行ログを出す。エージェントが誤答したときの手がかりになる。
デメリット
- 価格は見積もり制で、サイトだけでは月額を読めない。予算承認に時間がかかる。
- API の知識が前提だ。非技術者には管理画面が詰まって見え、ドキュメントも開発者向けに寄っている。
- 検索の質は文書の整え方に左右される。構造の甘い資料は、自信ありげな誤答を生む。
よくある質問
既存製品に AIエージェントと検索を足すために使う。社内文書を扱うサポート支援、社内 API を呼ぶチャットエンドポイント、自動化した バックオフィスのフローが典型だ。
関連コンテンツ
OnDemandに関連するツール、スキル、記事を探す。
OnDemandの代替ツール

Tractionwave
TractionWave · 画像 · マーケティングTractionWaveは静止画広告のアテンションヒートマップを作るAIツールだ。PNGかJPGを入れると、予測された注目位置、優先順位付きホットスポット、修正案が返る。予算を投じる前の判断に使う。

OpenSEO - AI Visibility
EveryApp · コーディング · マーケティング · ビジネスOpenSEOはキーワード調査、被リンク、順位追跡、サイト監査、AI検索での可視性をまとめたオープンソースSEOプラットフォームだ。使った分だけ課金され、MCP経由でAIエージェントからデータを引ける。

Plugins Radar
Plugins Radar · マーケティング · ビジネスPlugins Radarは、ChatGPTプラグインがディレクトリ検索と会話内でどこに表示されるか、上にいる競合と変化を追跡するツール。9,885件を毎時チェックする。