
OpenLIT
OpenLIT · コーディング
OpenLITはOpenTelemetryを基盤にしたオープンソースのプラットフォームで、LLMの可観測性、評価、ガードレールを備え、AIエージェントの挙動を追跡して採点し修正できる。
OpenLIT について
About
OpenLITとは
OpenLITはAIアプリの可観測性レイヤーを担う。アプリを接続すれば、モデル呼び出し、ツール呼び出し、検索、エージェントの各ステップがすべて読めるトレースとして残る。追跡、評価、ガードレール、プロンプト管理、コスト追跡を1か所でこなす。
売りはデータの持ち運びやすさにある。OpenLITが書き出すのはOpenTelemetryの標準データなので、内蔵ダッシュボードに置いても、同じトレースをGrafana、Datadog、あるいは任意のOTLPバックエンドへ送ってもいい。テレメトリが独自形式に縛られることはなく、Apache 2.0の下でスタック全体を自前でホストできる。
難点は、OpenLITが開発者向けツールだという点だ。価値を引き出すにはSDKかコレクタを組み込む必要があり、本番の流量を扱うならストレージも自分で運用することになる。設定不要の完成品を求めている人には向かない。
はじめかた
- OpenLITのリポジトリをクローンして
docker compose up -dを実行するか、既存のOTLPエンドポイントにアプリを接続する。 - Pythonなら
pip install openlit、TypeScriptならnpm install openlitでSDKを入れる。 - コードの先頭に
openlit.init()を足すと、対応するモデルプロバイダ、フレームワーク、ベクトルDBが自動で計装される。 - ダッシュボードを開いて最初のトレースを読み、アプリの成長に合わせて評価、プロンプト、ガードレールを整えていく。
AIツール情報
OpenLITの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- LLMアプリを作る開発者:ベンダー契約なしで自分のコードのトレース、コスト、レイテンシが手に入り、設定は1行で済む。
- プラットフォームチームとSRE:GPUコレクタとAIエージェント監視のダッシュボードがハードウェアとツール呼び出しの挙動を映すので、利用者から報告が上がる前に劣化を捉えられる。
- 閉じた可観測性ツールからの移行を考えるチーム:OpenLITはOpenTelemetryを話すため、既存のバックエンドを残したまま、スタック全体の再計装を避けられる。
タスク
- 失敗したエージェント実行の原因調査:モデル呼び出し、ツール呼び出し、検索のトレースをたどり、ループがどこで切れたかを突き止める。ログを眺めて勘に頼る作業は要らない。
- モデル費用の圧縮:モデル、ユーザー、セッション単位でトークンとコストを測り、金額に見合わない箇所でプロンプトやモデルを差し替える。
- 公開前のプロンプト比較:OpenGroundで1つのプロンプトを複数モデルに当て、実際の入力で耐えるものを見極める。
- 実行時のプロンプトインジェクション対策:ガードレールが流量を検査し、危険なリクエストをモデルに届く前に止める。
シーン
- RAGチャットボットの本番投入:テスト用クエリの見本ではなく実トラフィックで、検索品質と回答の妥当性を監視する。
- CIでのコーディングエージェント運用:1セッションのファイル読み取り、編集、シェルコマンドを記録し、エージェントが実際に何を変えたかを監査する。
- 学習や推論中のGPUコスト監視:NVIDIA、AMD、IntelのGPUから利用率、メモリ、温度、消費電力を取り、アプリのトレースと同じ画面に並べる。
主な機能
OpenTelemetryネイティブの追跡
OpenLITはLLM呼び出し、ツール呼び出し、MCPリクエスト、検索、エージェントの各ステップを標準のOpenTelemetryトレースとして記録する。ユーザー、セッション、コスト、レイテンシで絞り込め、同じデータをOpenLIT内に留めずGrafana、Datadog、任意のOTLPエンドポイントへ送れる。この持ち運びやすさが、閉じたツールではなくこれを選ぶ最大の理由だ。
自動計装とノーコードの選択肢
openlit.init()を足すだけで対応するプロバイダ、フレームワーク、ベクトルDBが計装され、OpenAI、LangChain、CrewAI、ChromaDBなど50を超える連携がそろう。Claude Code、Codex、Cursorといったコーディングエージェントには、CLIがソースコードに触れずに計装を入れる。
LLM-as-a-judgeによる評価
OpenLITは幻覚、バイアス、有害性、関連性、網羅性、指示追従の観点で出力を採点する。実トラフィックでも実験でも検査を回せ、CIパイプラインの合否に結び付けられるので、品質低下は公開前にせき止められる。
バージョン管理付きのプロンプトハブ
Prompt Hubはプロンプトを1か所に集め、Major、Minor、Patchのタグで版を管理し、実行時に{{variable}}の値を差し込む。アプリのコードを出し直さずにプロンプトを配信・巻き戻しできるため、文言の変更がリリース周期から切り離される。
実行時のガードレール
ガードレールはリクエストの到着時に検査し、プロンプトインジェクション、機微な話題、話題の制限に対して動く。ルールはこちらが決め、OpenLITがリクエスト経路上で適用する。モデルが素直に振る舞うかどうかに頼らない安全層になる。
コスト、レイテンシ、GPU監視
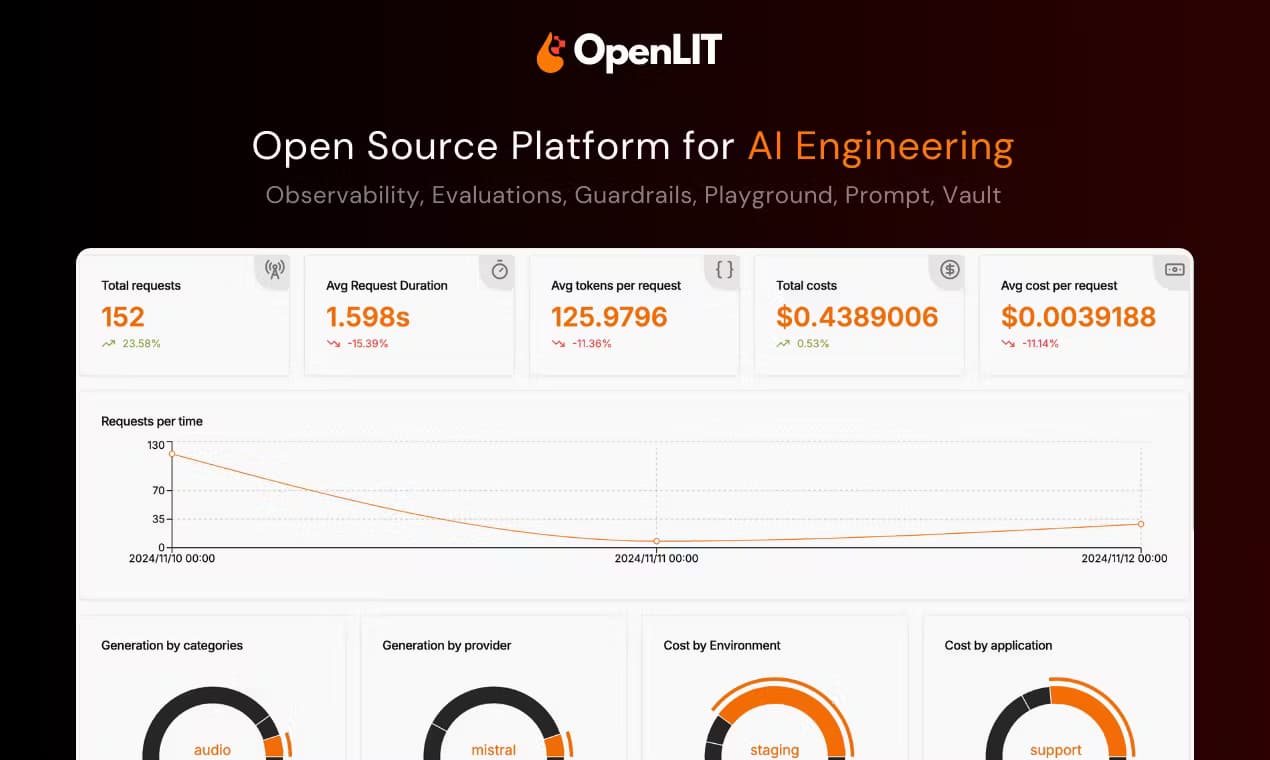
モデル、プロバイダ、ユーザー、セッション、エージェントをまたいで支出とレイテンシを追跡し、微調整モデルの独自価格にも対応する。別途のGPUコレクタがNVIDIA、AMD、Intelのハードウェアから利用率、メモリ、温度、消費電力を引き出し、コストとハードウェアの負荷が同じダッシュボードに並ぶ。
メリットとデメリット
メリット
- OpenTelemetryネイティブでトレースが持ち運べ、独自形式を避けられる
- Apache 2.0の下で無償でセルフホストでき、ライセンスキーもデータの所有権も自前で保てる
- 対応プロバイダは1行で接続でき、コーディングエージェントにはノーコードの選択肢もある
- 可観測性、評価、ガードレール、プロンプト、GPU監視を1つのプラットフォームに集約
- ClickHouseベースのストレージが高流量のLLMとエージェントのテレメトリを支える
デメリット
- 開発者向けに作られており、非技術者は設定と概念の壁を感じる
- 本番トラフィックをセルフホストするならClickHouseを自分で動かし健全に保つ必要がある
- 機能が広いぶん、入門ドキュメントを読み切るまで時間がかかる
- マネージドSaaSと違い、更新、拡張、バックアップはすべて自己責任になる
よくある質問
OpenLITはAIエージェントとLLMアプリを追跡、評価、防御するオープンソースのプラットフォームだ。モデル呼び出し、ツール呼び出し、検索をOpenTelemetryトレースとして取り込み、その上に評価、ガードレール、プロンプト管理を重ねる。
関連コンテンツ
OpenLITに関連するツール、スキル、記事を探す。
OpenLITの代替ツール
Forefront
Forefront · コーディングForefrontはオープンソースAIで構築するためのウェブプラットフォームだ。主要なオープンソース言語モデルを自分のデータで微調整し、性能を評価し、API経由で実行したり、エクスポートして自分でホストしたりできる。クローズドなプラットフォームの手軽さを求めつつ、モデルとデータの所有権にはこだわる開発者が対象だ。

Startkit
StartKit.AI · コーディングStartkitは、AI SaaSとAIラッパー製品を作るためのボイラープレートだ。面倒な部分をあらかじめ配線済みにしたAIスタートアップボイラープレートと考えればいい。認証、StripeとLemon Squeezyの決済、利用制限、トランザクションメール、そしてOpenAI、Anthropic、Groq、Llamaと通信するAI APIスターターキットが含まれる。リポジトリをクローンして価格を設定し、ユーザーが実際にお金を払う部分に取りかかれる。ReactとTailwind上のNext.jsで作られているため、ボイラープレートコードの多くはすでに見慣れたものだ。
Testim
Tricentis · コーディングTestimは、Web・モバイル・Salesforceアプリ向けにエンドツーエンドテストを構築して実行するAIテスト自動化プラットフォームだ。機械学習を頼りに、インターフェースが変わってもテストを安定させ、チームが壊れたセレクターの修正に費やす時間を減らす。今日から使い始められる自動テストツールとしては悪くない。ブラウザで操作を録画してテストを作り、より細かい制御が必要なときはJavaScriptを足す。忙しいQAチームにとって堅実な選択肢である。