
PDFMerse
PDFMerse · コーディング · 生産性向上
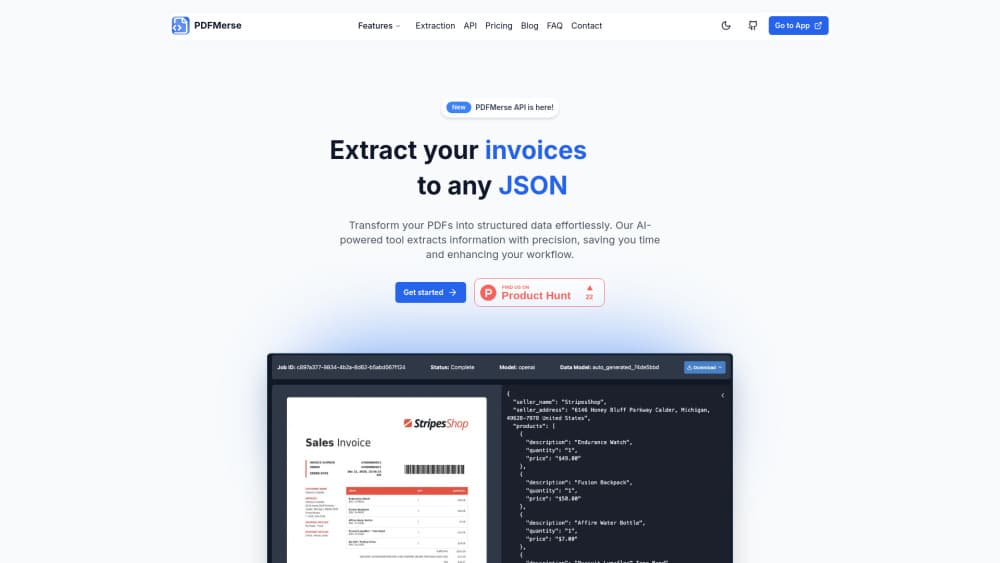
PDFMerseは、あらゆるPDFをJSONやCSVといった構造化データに変換するAIデータ抽出ツールで、文書を使える行データにしたいチーム向けに作られている。
PDFMerse について
PDFMerseとは
PDFMerseはAIを使ったPDFデータ抽出ツールだ。文書を渡すと、人間と同じようにレイアウトを読み取り、並べ替えや絞り込み、データベースへの読み込みができる構造化データを返す。うたい文句は単純明快で、請求書やレポート、明細から数字を手作業で写すのをやめること。発想はこれだけだ。
多くの人は、手作業にようやく疲れ果てたときに、PDFファイルからデータを抽出する方法をまず検索する。PDFMerseはその需要に真正面から応える。
このツールが狙う痛点ははっきりしている。ほとんどのPDFは解析ではなく印刷のために作られている。テキストは妙な段組みに落ち、表はページをまたいで途切れ、スキャンしたページは実質ただの画像だ。普通の変換ツールでこうしたファイルからデータを引っ張ると、使えるようになるまでに何時間も整理が要る文字化けの山が残る。PDFMerseは抽出をまず理解の問題として扱う。だから出力は構造を保つ。
注意点は、完璧な抽出ツールなど存在しないということで、PDFMerseもそこは偽らない。精度は元ファイルのきれいさ次第だ。くっきりしたデジタル請求書は、スマホで撮った傾いたレシート写真よりはるかにうまく解析できる。全ページ100%の精度を期待すると肩透かしを食う。新しい種類の文書を初めて処理するときは、とくに出力の抜き取り確認を予定に入れておきたい。
はじめ方
- PDFMerseのサイトでアカウントを作成し、ダッシュボードにサインインする。
- PDFをアップロードするか、文書の取り込み元を接続する。
- 請求書番号、日付、合計、取引先など、受け取りたいフィールドを定義する。
- 抽出を実行し、AIに各ページを読ませる。
- 構造化された出力を確認し、スプレッドシートやデータベース、API向けにJSONまたはCSVで書き出す。
AIツール情報
PDFMerseの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- 財務・経理チーム:元のPDFがある程度きれいであれば、請求書や明細の明細行と合計を打ち直さずに取り出せる。
- 運用・管理部門:定例のレポートやフォームを、スプレッドシートにすぐ入る行に変える。同じレイアウトが毎月繰り返すなら効果は大きい。
- データ・運用エンジニア:抽出したJSONをデータベースやパイプラインへ直接流し込む。これを土台に組む前に、まず現在のAPIアクセス状況を確認したい。
タスク
- 請求書データの抽出:取引先、日付、金額、明細行を、読むしかないスクリーンショットではなく構造化フィールドとして得る。
- レポートのデジタル化:長いPDFレポートを、分析やグラフ化に使える機械可読なデータへ変換する。
- フォーム処理:申込書、レシート、発注書をバッチで読み取り、ひとつの表にまとめる。
シーン
- 月末の記帳:放っておけば半日タイピングで消える仕入先請求書の山を片づける。
- 調査・アンケート業務:公開レポートから表を抜き出し、出典間で数字を比較できるようにする。
- 紙記録の移行:保管していたPDFを、チームが実際に検索できる構造化ライブラリへデジタル化する。
主な機能
PDFを構造化データに
中核となる仕事は、PDFを他の場所で使える構造化データに変えることだ。PDFMerseは文書を読み、関心のあるフィールドを特定し、文字の壁ではなく整った形式で返す。結果をスプレッドシートやデータベースへ流し込むとき、この違いは効いてくる。きれいな列は、どんな日でもコピー&ペーストに勝る。
カスタムフィールド定義
何を抽出するかは自分で決める。ツールが当てずっぽうに推測するのを期待する代わりに、請求書番号や支払期日、合計金額といった欲しいフィールド名を設定する。これで出力が読み込み先のシステムにそろい、後からデータを整形し直す時間が減る。
JSONとCSVのエクスポート
抽出したデータは、他のツールがすでに話せる形式で出てくる。開発ワークフロー向けにPDFからJSONが欲しい? できる。代わりにスプレッドシート向けのPDFからCSVが必要? それも動く。JSONは開発者やAPIワークフローに向き、CSVはExcelやGoogle Sheetsに直接入るので表計算中心の人が使いやすい。両方あれば、間に変換の一手間は要らない。
複雑なレイアウトへの対応
本物のPDFは整っていない。表はページをまたぎ、段組みは並んで走り、見出しは繰り返す。では、表が3ページに分かれ、コピーしたくない見出しが繰り返されるときはどうなるか。このAIは、位置でテキストをつかんで台無しにするのではなく、そうしたレイアウトを筋の通った順序で読むように作られている。使える抽出ツールとただのテキストの塊を分けるのは、まさにこの部分だ。
乱れた文書での精度
文書は千差万別で、抽出はその幅に耐える必要がある。整ったデジタルファイルはきれいに抽出でき、スキャンページや低品質の取り込みは難しく、ひととおり目を通す必要が出る。既知の取引先の標準的な請求書をきれいにスキャンしたものはほぼ完璧に戻ってくる一方、古いスマホで悪い照明の下に撮ったしわくちゃのレシートは、モデルとあなたの忍耐の両方を試す。自分のファイルがどちら側か分かれば、どれだけ確認に時間を割くべきか見えてくる。
文書のバッチ処理
複数のファイルをさばくとき、本当に時間を節約するのはバッチ処理だ。狙いは単発の完璧な抽出ではなく、請求書やフォームの列を一気に片づけることにある。手作業で同じことをするより、PDFデータ抽出ツールが元を取るのはここだ。明細を50件渡してその場を離れる。戻れば表ができている。
メリットとデメリット
メリット
- PDFを生テキストのままにせず、構造化されたJSONやCSVに変える。
- カスタムのフィールド定義で、出力を自分のワークフローに合わせて保てる。
- 複数列のページや表など、複雑なレイアウトを読める。
- スキャンした文書や不完全な文書にもまずまず対応する。
- 請求書やフォームのような繰り返し文書で、手入力の手間を減らす。
デメリット
- 低品質のスキャンでは精度が落ちるので、その結果は自分で確認する必要がある。
- ブラウザ専用で、オフライン利用向けのデスクトップアプリやモバイル版はない。
- 実際の料金とプラン階層は変わりうるので、契約前に公式サイトで最新の詳細を確認したい。
- APIアクセスに関する公開情報は乏しく、大規模に自動化したいなら問題になる。
よくある質問
PDF文書からデータを抽出し、JSONやCSVのような構造化出力として返す。ファイルをアップロードし、欲しいフィールドを伝えると、文書を読んでその値を取り出す。
関連コンテンツ
PDFMerseに関連するツール、スキル、記事を探す。
PDFMerseの代替ツール
Forefront
Forefront · コーディングForefrontはオープンソースAIで構築するためのウェブプラットフォームだ。主要なオープンソース言語モデルを自分のデータで微調整し、性能を評価し、API経由で実行したり、エクスポートして自分でホストしたりできる。クローズドなプラットフォームの手軽さを求めつつ、モデルとデータの所有権にはこだわる開発者が対象だ。

Startkit
StartKit.AI · コーディングStartkitは、AI SaaSとAIラッパー製品を作るためのボイラープレートだ。面倒な部分をあらかじめ配線済みにしたAIスタートアップボイラープレートと考えればいい。認証、StripeとLemon Squeezyの決済、利用制限、トランザクションメール、そしてOpenAI、Anthropic、Groq、Llamaと通信するAI APIスターターキットが含まれる。リポジトリをクローンして価格を設定し、ユーザーが実際にお金を払う部分に取りかかれる。ReactとTailwind上のNext.jsで作られているため、ボイラープレートコードの多くはすでに見慣れたものだ。
Testim
Tricentis · コーディングTestimは、Web・モバイル・Salesforceアプリ向けにエンドツーエンドテストを構築して実行するAIテスト自動化プラットフォームだ。機械学習を頼りに、インターフェースが変わってもテストを安定させ、チームが壊れたセレクターの修正に費やす時間を減らす。今日から使い始められる自動テストツールとしては悪くない。ブラウザで操作を録画してテストを作り、より細かい制御が必要なときはJavaScriptを足す。忙しいQAチームにとって堅実な選択肢である。