
Plexe
Plexe · コーディング
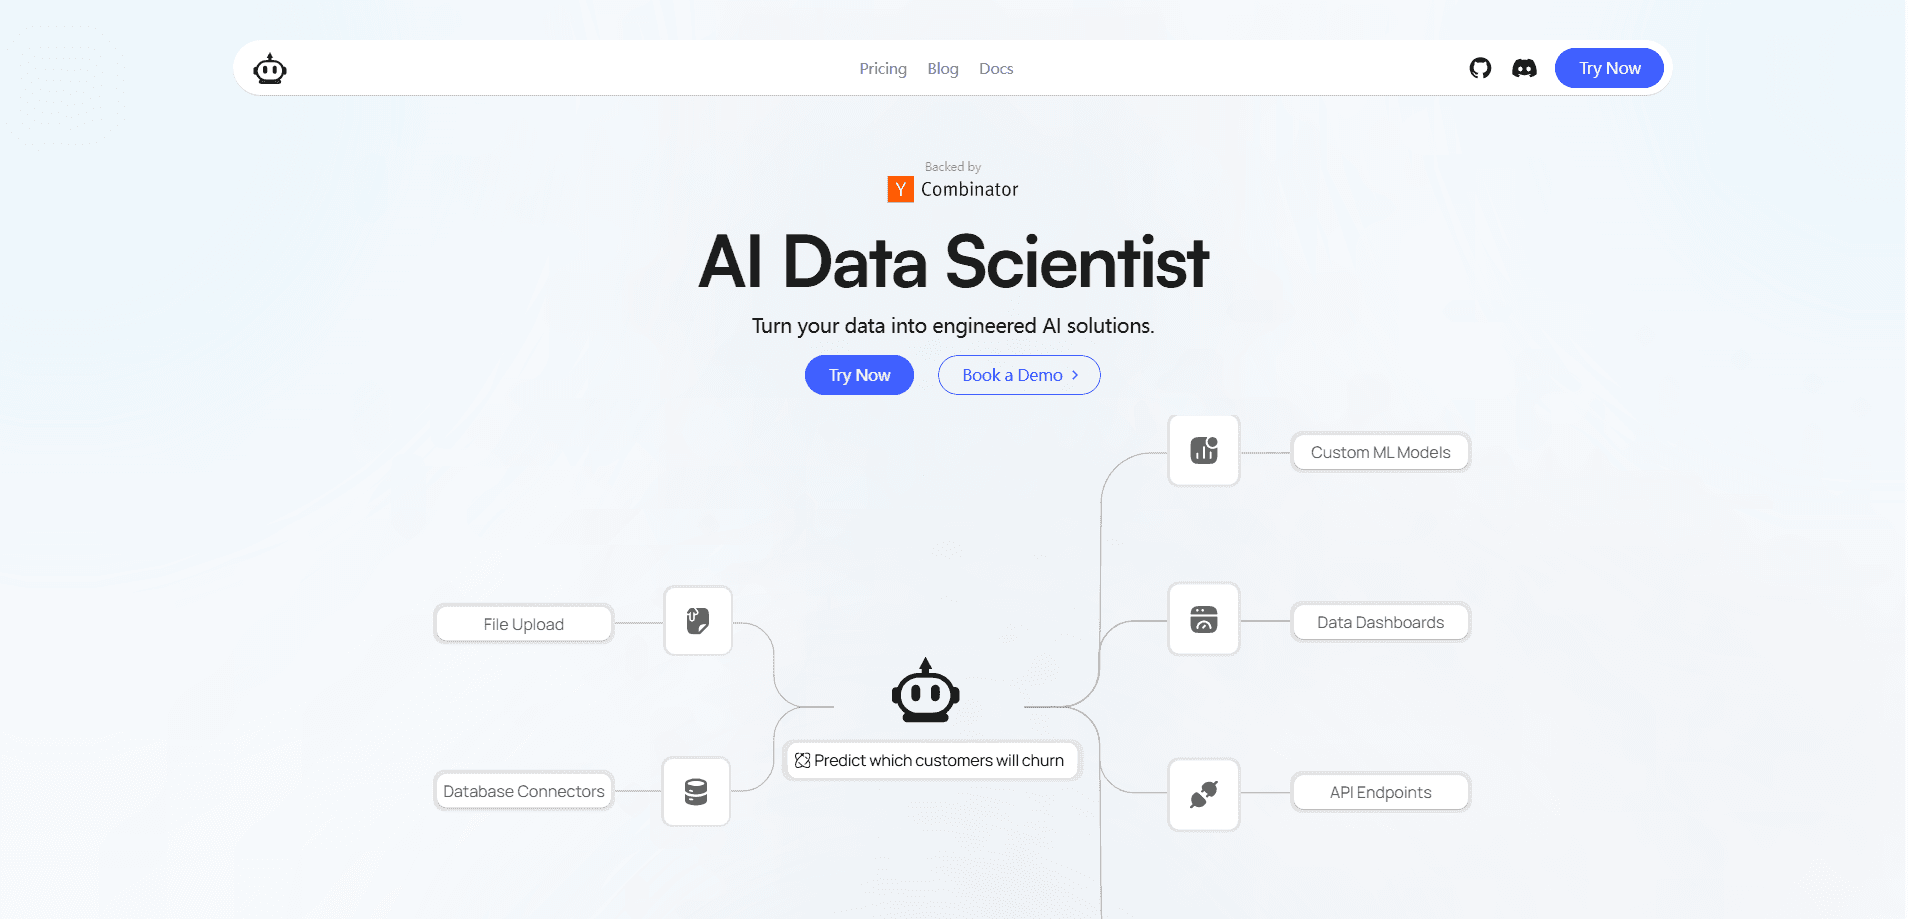
Plexeは、自然言語からMLモデルを構築できるオープンソースのAutoMLプラットフォームだ。欲しいものを平易な言葉で伝えれば、あとはエージェントがやってくれる。学習コードを手で書く代わりに、データセットと目標をエージェントに渡せば、データ準備、コード生成、学習、展開までをこなす。チームはAIモデル構築ツールとして使い、専任のMLエンジニアを置かずに、四半期ではなく数週間で予測結果を出荷する。
Plexe について
Plexeとは何か
Plexeは、動く機械学習モデルが必要だが、ツールチェーンを学ぶのに何か月も費やしたくない人向けの、エージェント駆動型ツールだ。初心者にとっての取っつきやすい入口でもある。データセットをつなぎ、欲しい予測を記述すると、マルチエージェントシステムが進め方を計画し、学習コードを生成して実行し、性能が伸びなくなるまで結果を磨き上げる。scikit-learn、PyTorch、TensorFlowといった一般的なライブラリの上に成り立っているため、出力は読みやすく、さらに先へ進めたいエンジニアにそのまま渡せる。
これが解決する主な問題は、「データがある状態」と「展開済みモデルがある状態」の間の隔たりだ。従来のワークフローは特徴量エンジニアリング、フレームワーク選定、インフラで止まり、どの段階も誰かが最初の予測を一つ見る前に何日も食いつぶす。Plexeはそうした段階を一つのループにまとめ、生成されたコードの一行一行を可視化したまま保つ。だから検査も変更も、後で自社エンジニアに渡すこともできる。
最大の制約は、それでもまともなデータと明確な目標が要るという点だ。散らかったデータセットへの曖昧な指示は、エージェントがどれほど優れていても有用な予測モデルを生み出さない。加えて初期段階の製品でもある。非常に大規模な、あるいは珍しい種類の問題では粗さが残ると見ておこう。
社内にML専門家がいないチームにとって、Plexeは面倒な作業を引き受ける予測モデルツールとして機能する。ただしデータそのものが本当の問題であるプロジェクトを救うことはない。
はじめ方
pip install plexeでオープンソースライブラリをインストールするか、インフラ構築を避けたいならconsole.plexe.aiのホステッドプラットフォームに登録する。- データセットをPandas DataFrame(ライブラリ)としてつなぐか、プラットフォームのUIとAPIからアップロードする。
- 目標を自然言語で記述し、必要なら入力と出力のスキーマを定義して、モデルが何を期待すべきか正確に把握できるようにする。
- Plexeを好みのLLMプロバイダーに向けて、エージェントシステムが計画とコード生成を行えるようにする。
- エージェントにモデルを構築・評価させ、推論用にエクスポートするか、自社製品に展開する。
AIツール情報
Plexeの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- 定型の学習コードを飛ばして、動くモデルにより早くたどり着きたい開発者とデータサイエンティスト。
- アプリ内に予測が必要だが、専任のMLエンジニアがいないプロダクトチームとアナリスト。
- 本格的なリソースを投じる前に、モデリングのアイデアを試したい初期実験中の創業者。
タスク
- 既存のデータセットから、解約スコア、価格予測、リードスコアリングといった表形式の予測モデルを構築する。
- 分類や回帰のアイデアを素早く試作し、データがそれを支えるかどうかを見る。
- 見直して自社のエンジニアリングチームに渡せる、きれいで文書化された学習コードを生成する。謎のスクリプトはもう終わりだ。
シーン
- 顧客履歴のスプレッドシートだけを持つ小さなスタートアップが、ML専門家を雇わずに解約モデルを求める。
- 次のスプリントまでに、軽量な予測エンドポイントを製品に組み込みたい社内ツールチーム。
- 一週間ではなく一午後で複数のアプローチを比較したい初期研究。素早い回転。低いリスク。
主な機能
自然言語によるモデル構築
欲しい結果を平易な言葉で記述すれば、Plexeのエージェントシステムがモデリング戦略を組み立てる。選ぶアルゴリズムはない。書く学習ループもない。エージェントは意図とデータを読み取り、そこに向けて構築する。
マルチエージェントパイプライン
内部では、一連のエージェントが計画、コード生成、実行、改良を担う。各段階が次を養い、性能が伸びなくなるまでシステムが結果を反復する。内部のほとんどに触れずに動くモデルが手に入る。時間の節約はこのループから生まれる。
オープンソースのPythonライブラリ
plexeライブラリはpipコマンド一つでインストールでき、既存のPythonコードにそのまま入る。計算資源とデータは自分で管理し、LLMプロバイダーの認証情報も自分で持ち込む。最大限の制御を求めるチーム向けの道だ。それだけのことである。
マネージドのホステッドプラットフォーム
インフラを管理したくないなら、console.plexe.aiのホステッドプラットフォームが、組み込みのスケーリングと簡素化された請求を備えたWeb UIとREST APIを提供する。運用の負担なしにエンタープライズ級のMLを求めるプロダクトチームに合い、サーバーを一台も自分で用意せずにアイデアから稼働中のエンドポイントまでたどり着ける。
スキーマとデータセットの制御
期待する入力と出力をPydanticモデルや普通の辞書で定義し、学習データをPandas DataFrameやデータセットジェネレーターから流し込める。厳密なスキーマは、生成されたモデルをアプリが実際に必要とするものに沿わせる。この一致は多くの人が思う以上に重要だ。
完全なコードの透明性
Plexeが生み出すモデルはどれもきれいで、文書化され、読める。生成されたコードを開いて理解し、カスタマイズできる。何もブラックボックスの裏に隠れていない。モデルが社内レビューを通る必要があるとき、これが効いてくる。
展開と推論
Plexeは学習済みモデルを推論用にパッケージ化するか、本番インフラに展開する。モデルはディスクに保存して後で読み込めるので、毎回作り直す必要はない。これが試作品を実際に出荷できるものに変える。
メリットとデメリット
メリット
- 自然言語入力がML学習曲線で最も険しい部分を取り除くので、非専門家でも本物のモデルを作れる。
- オープンソースの核によりコードは自分のもので、エージェントが生成したものは何でも検査・変更できる。
- 二つの展開経路(Pythonライブラリとマネージドプラットフォーム)で、制御と利便性を交換できる。
- 一般的なフレームワークに対応し、出力はチームがすでに使うツールに収まる。
デメリット
- ホステッドプラットフォームの料金は公開されておらず、エンタープライズ見積もりのためにチームへ連絡する必要がある。今すぐ数字が欲しい人には面倒だ。
- 結果はデータ品質に大きく左右される。散らかった入力は依然として弱いモデルを生み、それは直してくれない。
- 初期段階の製品なので、ニッチあるいは特に複雑な問題では粗さにぶつかることがある。
よくある質問
自然言語の記述から機械学習モデルを構築する。データと目標を渡せば、エージェントシステムがモデルの計画、記述、学習、展開を代行する。一文で言えばそれが製品のすべてだ。
関連コンテンツ
Plexeに関連するツール、スキル、記事を探す。
Plexeの代替ツール

Base Code
Base44 (Wix) · コーディング · 生産性向上Base CodeはBase44の共有クラウド開発環境だ。既存のGitHubリポジトリに対する変更をチャットで伝え、プレビューで確認し、プルリクエストとして返せる。

Google EmbeddingGemma 2
Google DeepMind · ライティング · 画像 · コーディングGoogle EmbeddingGemma 2 は 7 億 4000 万パラメータのオープンなモデルで、テキスト、コード、画像、音声、動画フレームを同じ 768 次元空間のベクトルに変え、スマートフォンやノート PC 上で動く。

GitGlow
GitGlow · コーディング · 生産性向上GitGlow は自分のコードと AI エージェントの変更を一つのレビューにまとめるデスクトップ Git クライアントだ。出荷前に、マシンから何が出ていくのかを確かめられる。